向量化算法 doc2vec
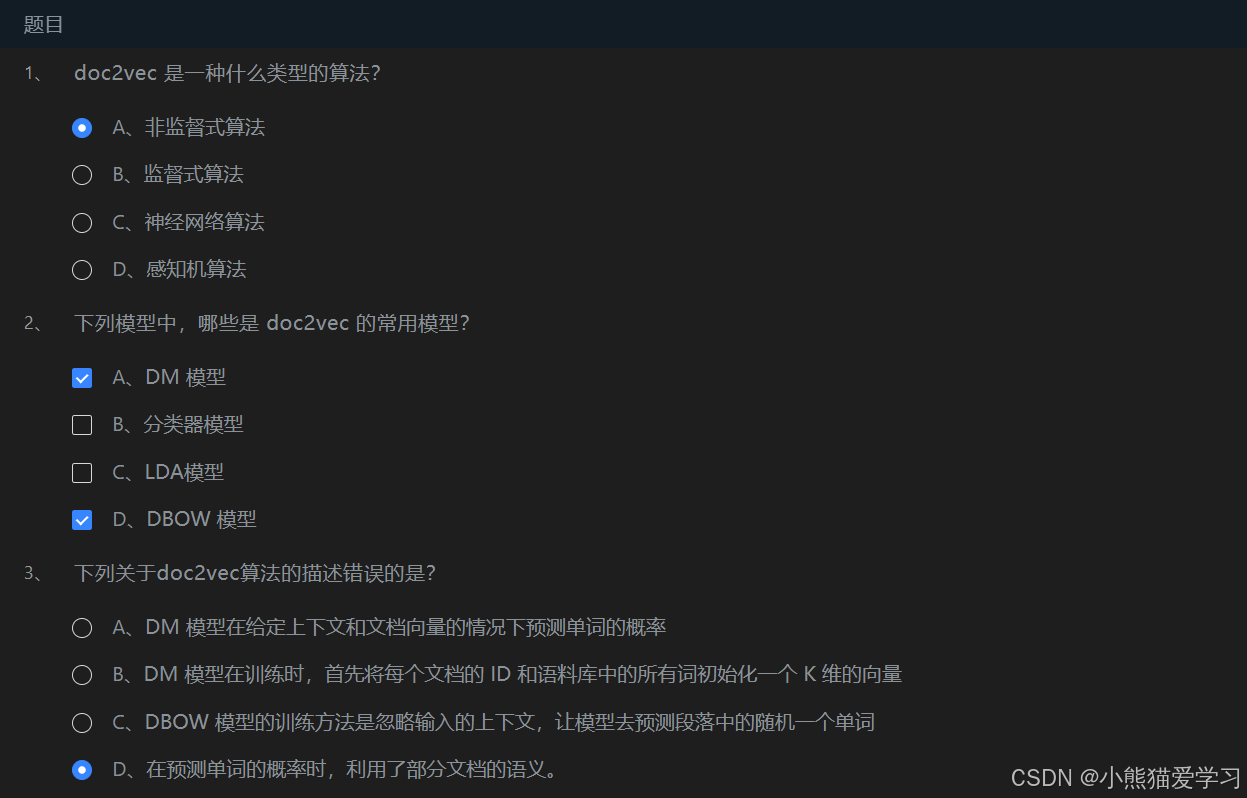
第1关:认识 Doc2vec
第2关:Doc2vec 实战
from gensim.models.doc2vec import Doc2Vec,TaggedDocument
import pandas as pd

def D2V():
    article = pd.read_excel('data.xlsx') #data为训练集,繁体
    sentences = article['内容'].tolist()
    split_sentences = []
    for i in sentences:
        split_sentences.append(i.split(' '))
    documents = [TaggedDocument(doc, [i]) for i, doc in enumerate(split_sentences)]

# 任务:基于 gensim 构建 doc2vec 模型并命名为doc2vec_stock进行保存
# ********** Begin *********#

    model = Doc2Vec(documents, size=100, window=5, min_count=5, workers=4, epoch=5000)
    model.save("doc2vec_stock.model")

# ********** End **********#
向量化算法 word2vec
第1关:向量化算法 word2vec
import logging

from gensim.models import word2vec

def getmodel():

  logging.basicConfig(format='%(asctime)s : %(levelname)s : %(message)s', level=logging.INFO)

  # 加载《人民的名义》文本

  sentences = word2vec.LineSentence('./in_the_name_of_people_segment.txt')

# 任务:使用 gensim 模块中的word2vec对sentences文本构建合适的word2vec模型,并保存到model变量中,使得文本中的人名相近度达0.9以上。

# ********** Begin *********#

  model = word2vec.Word2Vec(sentences, hs=1, min_count=1, window=3, size=100)

# ********** End **********#

  return model




 扫一扫


 7225

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


