Cc1924
码龄8年
求更新 关注
提问 私信
  • 博客:1,095,345
    社区:19
    1,095,364
    总访问量
  • 378
    原创
  • 3,297
    粉丝
  • 225
    关注
IP属地以运营商信息为准,境内显示到省(区、市),境外显示到国家(地区)
IP 属地:北京市
加入CSDN时间: 2018-07-18
博客简介:

qq_42731705的博客

查看详细资料
个人成就
  • 获得1,624次点赞
  • 内容获得283次评论
  • 获得7,551次收藏
  • 代码片获得11,396次分享
  • 博客总排名1,164,231名
创作历程
  • 6篇
    2025年
  • 9篇
    2024年
  • 26篇
    2023年
  • 203篇
    2022年
  • 134篇
    2021年
成就勋章
TA的专栏
  • 深度学习
    16篇
  • 算法刷题
    67篇
  • NeRF
    1篇
  • SLAM
    81篇
  • ROS
    19篇
  • C++
    59篇
  • 计算机网络
    6篇
  • 作业记录
    4篇
  • 暂存
    2篇
  • git/github
    2篇
  • 数学基础
    3篇
  • ceres学习笔记
    5篇
  • g2o
    1篇
  • 理论基础
    1篇
  • CS231N
    5篇
  • 电机笔记
    21篇
  • Python笔记
    6篇
  • Linux工具操作笔记
    63篇
  • 单片机嵌入式笔记
    9篇
  • 杂项
    7篇
  • 树莓派/OpenCV/
    8篇

TA关注的专栏 70

TA关注的收藏夹 0

TA关注的社区 6

TA参与的活动 2

兴趣领域 设置
  • 人工智能
    神经网络
创作活动更多

【多重好礼】鸿蒙心迹 · 开发录原创征稿活动

鸿蒙开发者的实战经验,值得被记录。从踩坑排查到项目复盘,从工具脚本到学习笔记,每一段真实的开发经历,都是社区最宝贵的技术资产。「鸿蒙心迹 · 开发录」正式启航,不限主题、随时可写,只要是鸿蒙开发相关的真实经验都欢迎投稿。 本活动为 [HarmonyOS 7.0 创新内容共创季](https://builderx.csdn.net/activity-site/harmonyos/activity2026)双轨征文之一,与[「共创季 · 稿事节」](https://harmonyosdev.csdn.net/6a97f0de2b83d06f0ecadec5.html)深度征文互补——「稿事节」写深度技术长文,「开发录」写日常开发实战笔记。 「开发录」每月一期,12月截止,本季共三期,投稿即有机会获得京东卡、CSDN博客流量券、亿万Token、社区定制周边好礼!

125人参与 去参加
  • 最近
  • 文章
  • 专栏
  • 代码仓
  • 资源
  • 收藏
  • 关注/订阅/互动
更多
  • 最近

  • 文章

  • 专栏

  • 代码仓

  • 资源

  • 收藏

  • 关注/订阅/互动

  • 社区

  • 帖子

  • 问答

  • 课程

  • 视频

搜索 取消

13.1-13.4. 计算机视觉【1】

摘要本章探讨了计算机视觉中提升模型性能的两种关键方法:图像增广和微调。图像增广通过随机变换(如翻转、裁剪、颜色调整等)扩充训练数据,增强模型泛化能力,同时减少对特定属性的依赖。微调则利用预训练模型的知识迁移到新任务,通过保留底层特征提取层并重新训练输出层,在小规模目标数据集上实现高效学习。实验以热狗识别为例,展示了如何在真实场景中应用这些技术,包括数据预处理、模型结构调整和训练策略优化。两种方法共同解决了训练数据不足时的模型性能瓶颈问题。
原创
博文更新于 2025.06.24 ·
1295 阅读 ·
16 点赞 ·
0 评论 ·
18 收藏

13.5-13.8. 计算机视觉【2】

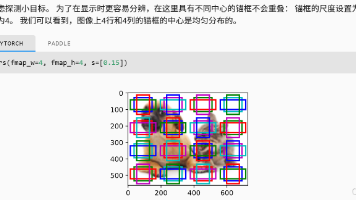
目标检测有两种类型的损失。第一种有关锚框类别的损失:我们可以简单地复用之前图像分类问题里一直使用的交叉熵损失函数来计算;第二种有关正类锚框偏移量的损失:预测偏移量是一个回归问题。但是,对于这个回归问题,我们在这里不使用 3.1.3节中描述的平方损失,而是使用L1L_1L1​范数损失,即预测值和真实值之差的绝对值。掩码变量bbox_masks令负类锚框和填充锚框不参与损失的计算。最后,我们将锚框类别和偏移量的损失相加,以获得模型的最终损失函数。我们可以沿用准确率评价分类结果。由于偏移量使用了。
原创
博文更新于 2025.06.24 ·
1534 阅读 ·
8 点赞 ·
0 评论 ·
17 收藏

12. 计算性能

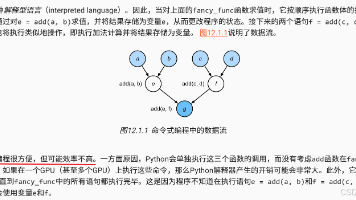
这个策略被多个深度学习框架使用,包括Theano和TensorFlow(后者已经获得了命令式编程的扩展)。
原创
博文更新于 2025.05.28 ·
816 阅读 ·
5 点赞 ·
0 评论 ·
3 收藏

11. 优化算法

也就是说,梯度下降是使用整个训练集的数据计算loss和梯度,随机梯度下降是在训练集中随机选择一个样本计算loss和梯度,而小批量随机梯度下降则是计算一个batch中的样本的loss和梯度(是前二者的折中)。:这里就是上面一节说的有效样本数量,感觉意思应该就是动量是一个迭代的加权平均,所以相当于累积了过去很多数据的梯度,这里有效样本数量指的就是累积了多少数据的平均梯度。:这里的意思就是在计算梯度平方的时候,是逐元素计算的,而不是计算整个 tensor 的平方。然后计算 s_t 的时候也是逐个元素计算的。
原创
博文更新于 2025.05.27 ·
1387 阅读 ·
28 点赞 ·
0 评论 ·
17 收藏

10. 注意力机制

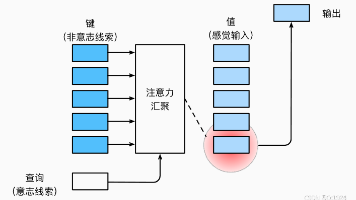
queries和attention_weights的形状为(查询个数,“键-值”对个数)# (q, k)# values的形状为(查询个数,“键-值”对个数)
原创
博文更新于 2025.05.24 ·
1003 阅读 ·
8 点赞 ·
0 评论 ·
8 收藏

9. 现代循环神经网络

我们将描述具有多个隐藏层的深层架构, 并讨论基于前向和后向循环计算的双向设计。在解释这些循环神经网络的变体时, 我们将继续考虑 8节中的语言建模问题。尽管我们已经应用了梯度裁剪等技巧来缓解这个问题, 但是仍需要通过设计更复杂的序列模型来进一步处理它。具体来说,我们将引入两个广泛使用的网络, 即**门控循环单元(gated recurrent units,GRU)**和。在各种序列学习问题中,如自动语音识别、文本到语音转换和机器翻译, 输入和输出都是任意长度的序列。和束搜索,并用它们来生成序列。
原创
博文更新于 2025.05.22 ·
470 阅读 ·
7 点赞 ·
0 评论 ·
4 收藏

8. 循环神经网络

高级API提供了循环神经网络的实现。我们构造一个具有256个隐藏单元的单隐藏层的循环神经网络层rnn_layer。事实上,我们还没有讨论多层循环神经网络的意义(这将在 9.3节中介绍)。现在仅需要将多层理解为一层循环神经网络的输出被用作下一层循环神经网络的输入就足够了。# 输入维度,隐藏层(注意不是输出层)维度我们使用张量来初始化隐状态,它的形状是**(隐藏层数,批量大小,隐藏单元数)**。(注意这里相比前面从零开始实现,多了一个隐藏层数)通过一个隐状态和一个输入,我们就可以用更新后的隐状态计算输出。
原创
博文更新于 2025.05.22 ·
1736 阅读 ·
17 点赞 ·
0 评论 ·
18 收藏

7. 现代卷积神经网络

这样的设计。
原创
博文更新于 2025.05.21 ·
1416 阅读 ·
13 点赞 ·
0 评论 ·
19 收藏

6. 卷积神经网络

例如,如果我们拍摄黑白之间轮廓清晰的图像X,并将整个图像向右移动一个像素,即Z[i, j] = X[i, j + 1],则新图像Z的输出可能大不相同。多输入通道:输入是 (C, H, W),则卷积核的大小需要是 (C, h, w), 也就是通道数必须相同,然后计算卷积的时候是把所有通道的卷积结果加起来,得到一个通道的输出。多输出通道:在最流行的神经网络架构中,随着神经网络层数的加深,我们常会增加输出通道的维数,通过减少空间分辨率以获得更大的通道深度。和下面公式中的不一样,这里是指一半的填充。
原创
博文更新于 2025.05.21 ·
941 阅读 ·
11 点赞 ·
0 评论 ·
8 收藏

5. 深度学习计算

自定义层的时候,把参数设置为 nn.Parameter 的好处:自动优化:当一个张量被封装为 nn.Parameter 时,它会自动被添加到模型的参数列表中(即 model.parameters())。在调用优化器(如 torch.optim.SGD 或 torch.optim.Adam)时,优化器会遍历这些参数并更新它们的值。设备一致性:将张量转换为 nn.Parameter 后,可以确保这些参数与模型的其他部分一起被移动到指定的设备(CPU 或 GPU)。
原创
博文更新于 2025.05.20 ·
1292 阅读 ·
17 点赞 ·
0 评论 ·
23 收藏

4. 多层感知机

当你设置 retain_graph=True 时,PyTorch 不会在 .backward() 调用后释放计算图,而是保留它,以便你可以再次在这个图上调用 .backward()。默认情况下,当 .backward() 被调用后,计算图会被标记为“已使用”(即梯度已被计算),随后如果再次尝试在这个图上调用 .backward(),PyTorch 会抛出一个错误,因为它认为图已经被“消费”过了,不应该再被使用。然而,在某些情况下,你可能需要在同一个图上多次调用 .backward()。
原创
博文更新于 2025.05.20 ·
1136 阅读 ·
28 点赞 ·
0 评论 ·
16 收藏

3.线性神经网络

生成器函数是一种特殊的函数,它允许你逐个生成值,而不是一次性返回一个完整的列表或集合。这样做的好处是可以节省内存,特别是在处理大量数据时,因为你可以按需生成数据,而不是一次性将所有数据加载到内存中。由于yield的使用,data_iter函数不会一次性执行完毕并返回一个结果,而是每次调用时返回一个批次的数据,并在下次调用时从上次停止的地方继续执行。使用生成器的好处之一是它们允许你以一种懒加载(lazy loading)的方式处理数据,即只在需要时才生成数据。
原创
博文更新于 2025.05.20 ·
1220 阅读 ·
18 点赞 ·
0 评论 ·
16 收藏

2.预备知识

然而,虽然这些更奇特的对象确实出现在高级机器学习中(包括深度学习中), 但当调用向量的反向计算时,我们通常会试图计算一批训练样本中每个组成部分的损失函数的导数。这里,我们的目的不是计算微分矩阵,而是单独计算批量中每个样本的偏导数之和。例如,假设y是作为x的函数计算的,而z则是作为y和x的函数计算的。想象一下,我们想计算z关于x的梯度,但由于某种原因,希望将y视为一个常数, 并且只考虑到x在y被计算后发挥的作用。这里可以分离y来返回一个新变量u,该变量与y具有相同的值, 但丢弃计算图中如何计算y的任何信息。
原创
博文更新于 2025.05.20 ·
1037 阅读 ·
16 点赞 ·
0 评论 ·
6 收藏

代码随想录2(二刷)——数组:977有序数组的平方、209长度最小的子数组、59螺旋矩阵II

由于负数的存在,可以知道最终平方后的数组的最大值可能在原数组的最左边或者最右边。也就是说,从最右往左(从大到小)看平方后的数组的话,其元素的来源应该是原数组的左边或者右边的值,所以可以从原数组的最左边和最右边两头往中间看,依次对比他们哪个值更大。这里一圈下来,我们要画每四条边,这四条边怎么画,每画一条边都要坚持一致的左闭右开,或者左开右闭的原则,这样这一圈才能按照统一的规则画下来。上面的暴力匹配没有利用到原来的数组就是有序的这个特点。的时候往后循环求和,他们求和的数组之间是有很大部分的重叠的。
原创
博文更新于 2024.09.18 ·
358 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

代码随想录1(二刷)——数组:704二分查找、27移除元素

这个暴力的方法也很简单, 就是循环遍历数组,只要找到了要删除的元素,就把它后面所有的元素都向前移动。由于把后面的元素向前移动的时候,需要再次用for循环,因此有两个for循环,时间复杂度是n^2。
原创
博文更新于 2024.09.18 ·
753 阅读 ·
1 点赞 ·
1 评论 ·
1 收藏

Ubuntu20 cv_bridge版本问题

文章目录ubuntu20.04下opencv版本不兼容问题
原创
博文更新于 2024.01.22 ·
640 阅读 ·
7 点赞 ·
0 评论 ·
6 收藏

NeRF资料整理

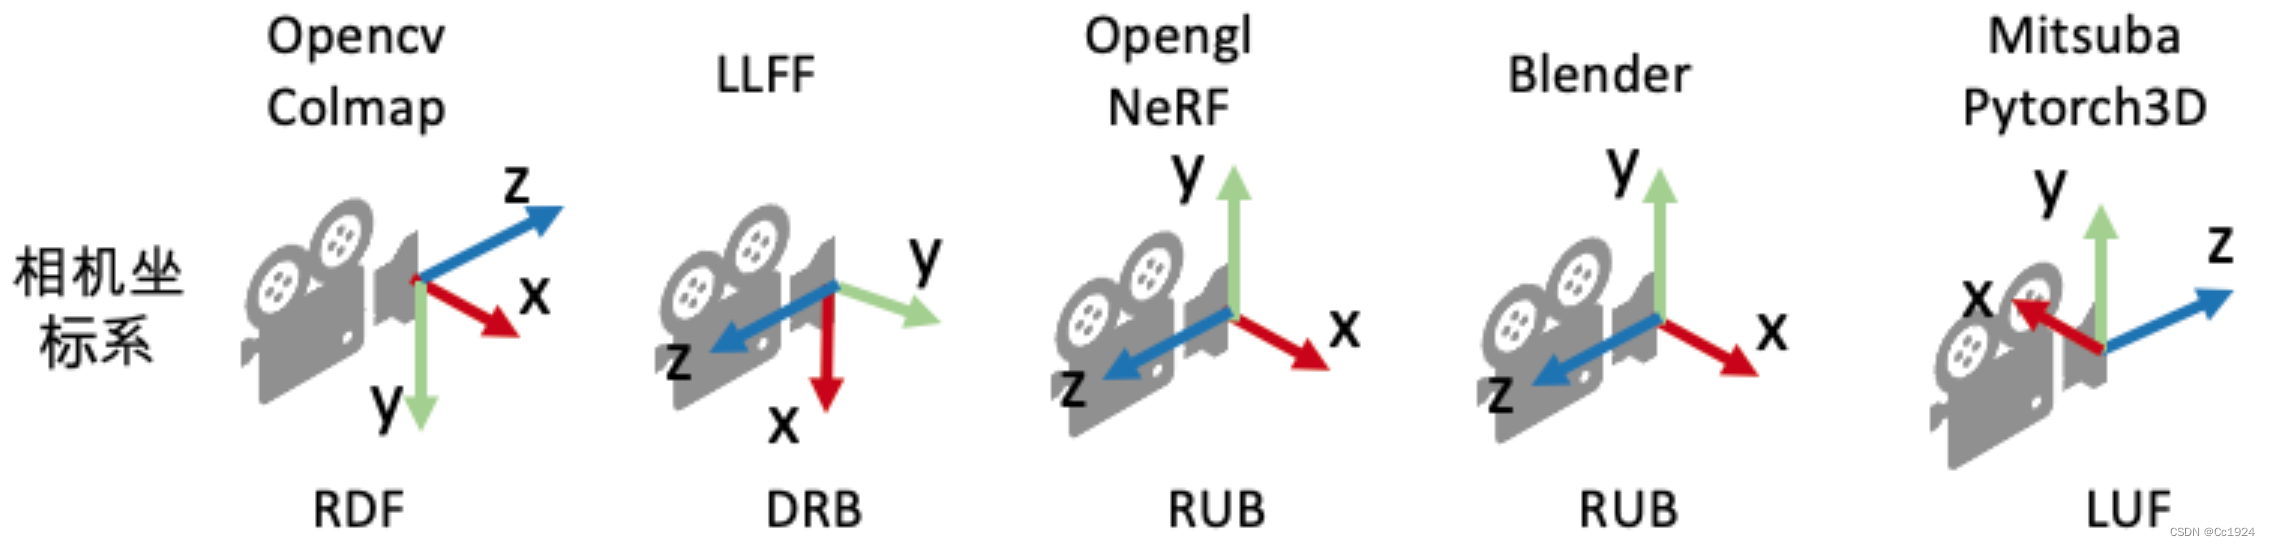
这个写的很详细,写的也很好,比较清楚的解释了为什么要使用NDC空间,其实就是因为对于实际场景来说它的深度范围是比较难确定的,渲染的时候需要从0到正无穷的深度进行渲染,显然这样无法在代码中进行确定区间的采样,而NDC空间使用坐标变换的方式可以将这个范围变换到[0,1]之间,从而变成一个有界的采样。:这个写的非常好,其中解释了Colmap、LLFF、OpenGL等多种坐标系的区别,如下图所示。唯一的遗憾就是没有讲解NDC空间。:nerf_pl代码中推荐的空间变换的参考,进去看了一下英文写的比较难懂。
原创
博文更新于 2024.01.20 ·
922 阅读 ·
9 点赞 ·
0 评论 ·
12 收藏

代码随想录13——栈与队列:150逆波兰表达式、53滑动窗口中和的最大值、239滑动窗口最大值、347前K个高频元素

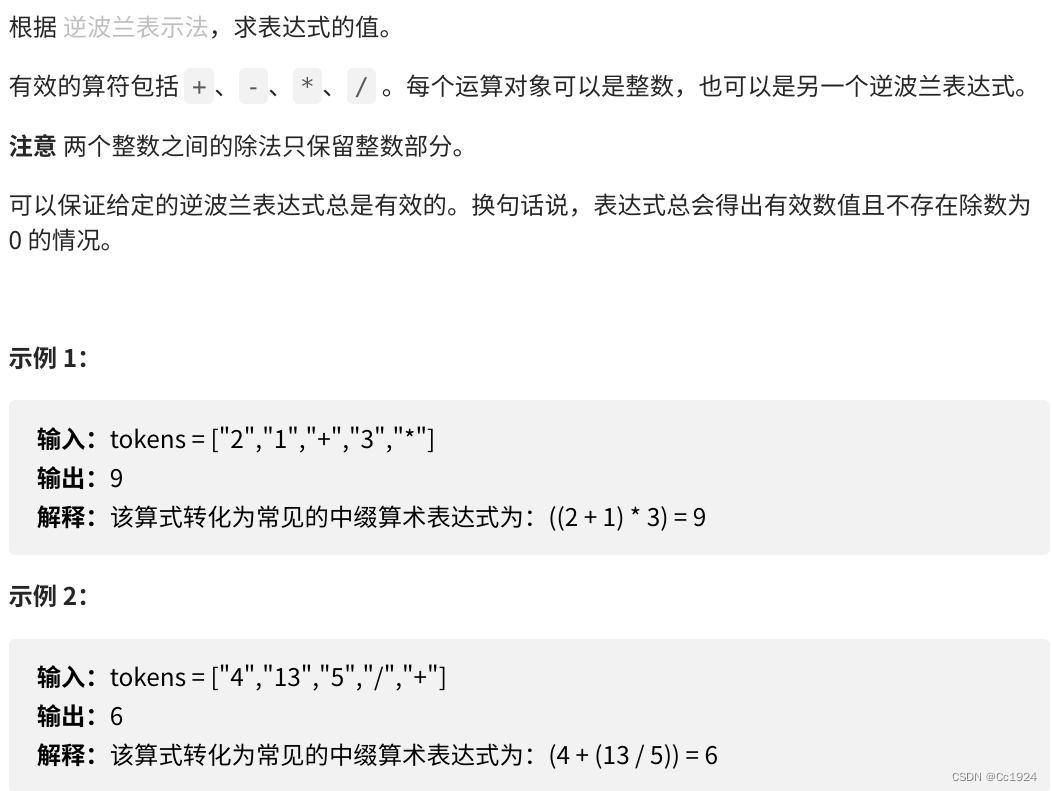
使用优先级队列就可以一直维护前K个高频的元素。其中又分为大顶堆和小顶堆,这个也是属于数据结构的内容,后面自己再好好学习吧,现在知道它是什么思路就可以。按照值来排序,但是这样要把所有的键都进行排序,而最后我们只需要找前K个高频元素,并不是找所有的频率排序的元素,所以这里可以优化。:队列中可以有相等的元素)。就够了,保持单调队列里单调递减,此时队列出口元素就是窗口里最大元素。自己构造一个队列的数据结构,队列没有必要维护窗口里的所有元素,,也讲了很多其他的内容,所以最好还是去看看。最先想到的是对统计之后的。
原创
博文更新于 2023.10.18 ·
653 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

ubuntu安装cuda/cuDNN/TensorRT

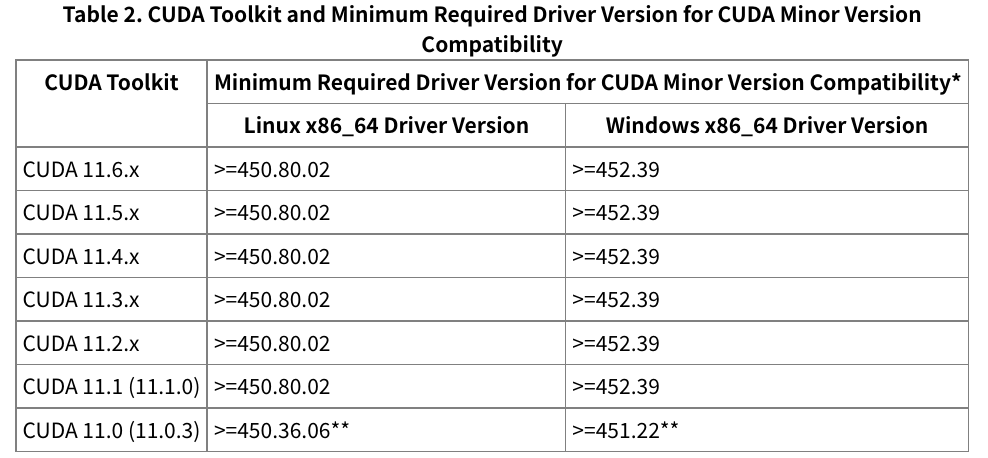
Ubuntu安装和卸载CUDA和CUDNNUbuntu 18.4 查看CUDNN版本
原创
博文更新于 2023.10.11 ·
5988 阅读 ·
8 点赞 ·
0 评论 ·
40 收藏

SLAM相关手撕代码题

【代码】SLAM相关手撕代码题。
原创
博文更新于 2023.09.14 ·
832 阅读 ·
3 点赞 ·
0 评论 ·
3 收藏
加载更多