


文章目录
11.1. 优化和深度学习
直接去看原文就行了,很简单:https://zh.d2l.ai/chapter_optimization/optimization-intro.html
11.1.1. 优化的目标
11.1.2. 深度学习中的优化挑战
11.1.2.1. 局部最小值
11.1.2.2. 鞍点
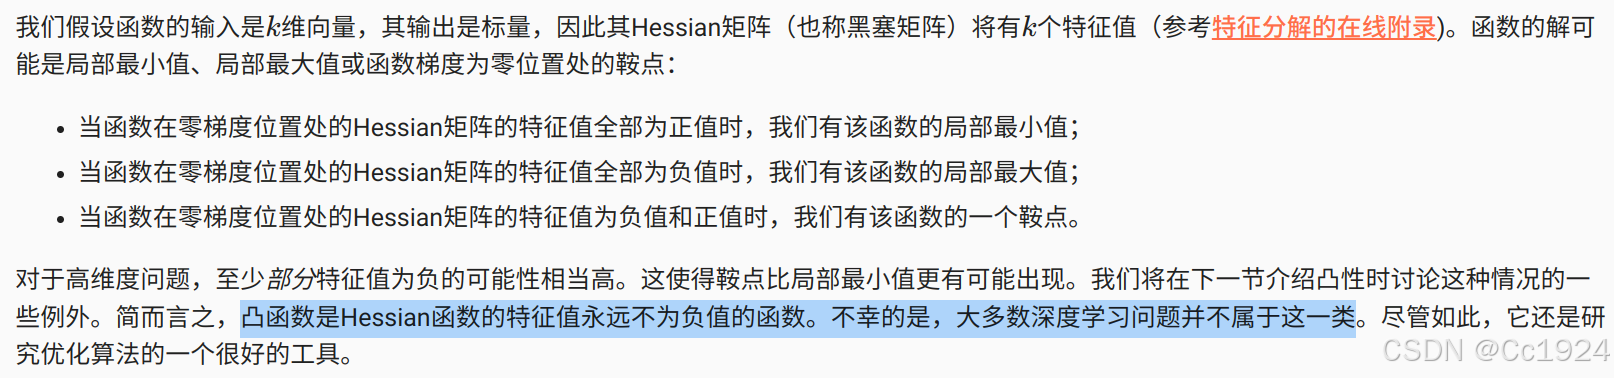
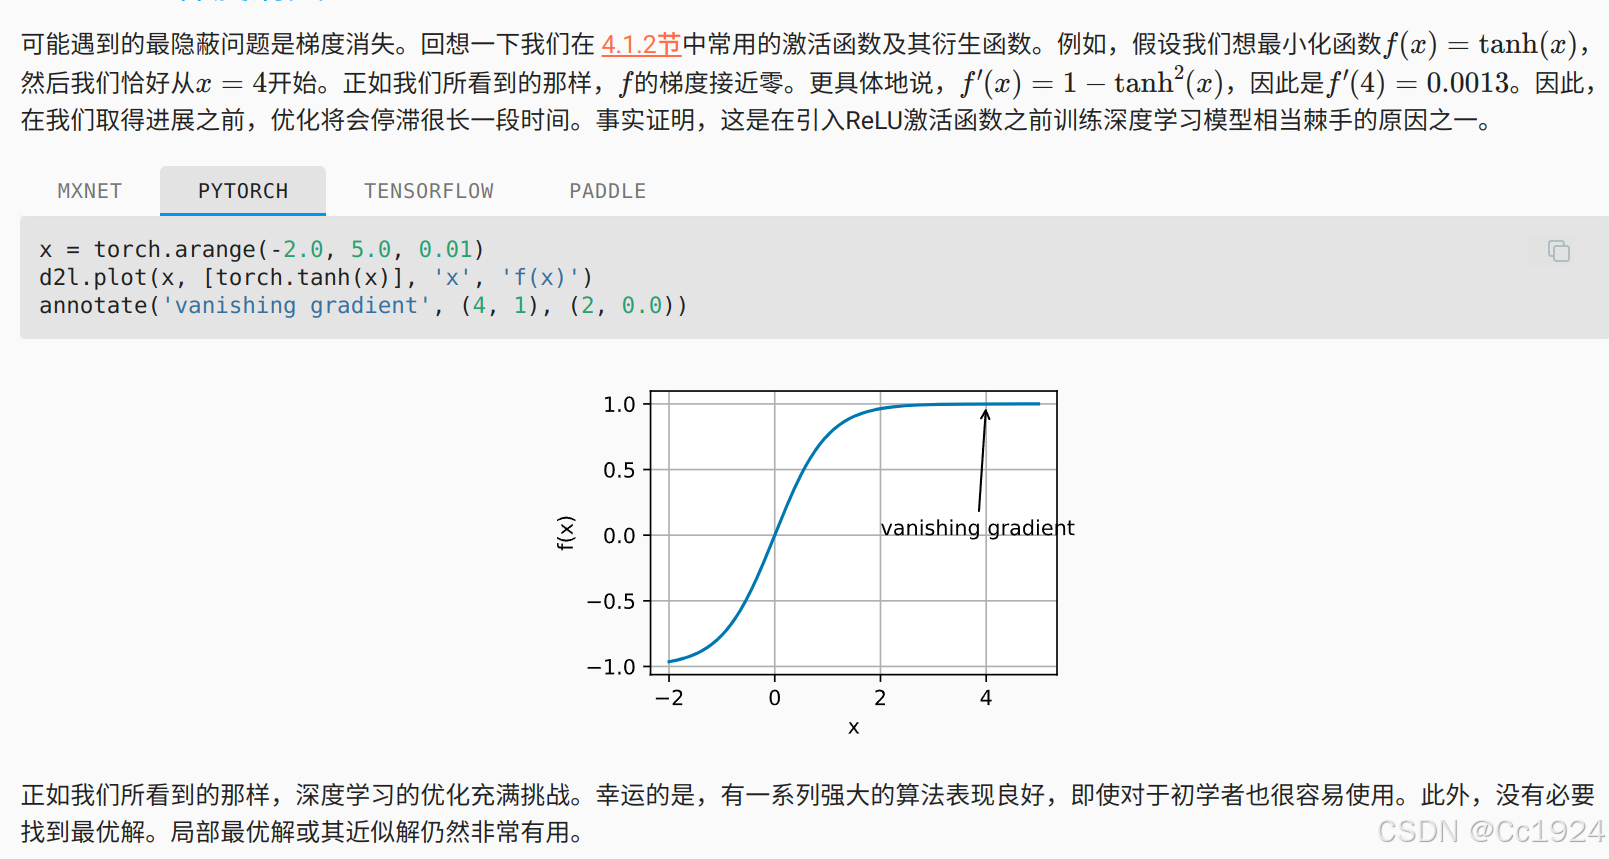
11.1.2.3. 梯度消失
11.1.3. 小结
- 最小化训练误差并不能保证我们找到最佳的参数集来最小化泛化误差。
- 优化问题可能有许多局部最小值。
- 一个问题可能有很多的鞍点,因为问题通常不是凸的。
- 梯度消失可能会导致优化停滞,重参数化通常会有所帮助。对参数进行良好的初始化也可能是有益的。
11.2. 凸性
这一节全是公式推导,感觉作用不大,如果想看可以直接去看原文:https://zh.d2l.ai/chapter_optimization/convexity.html
11.3. 梯度下降
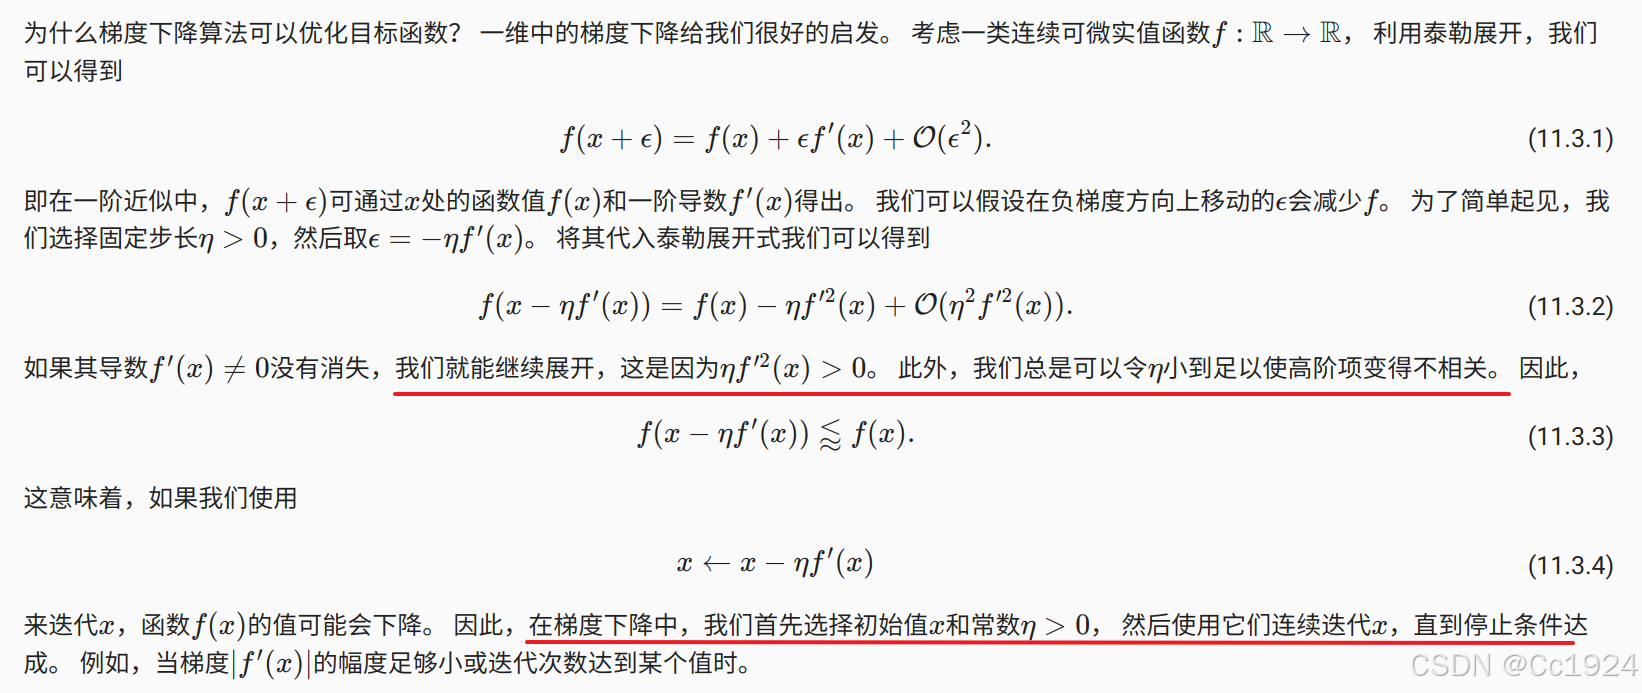
尽管梯度下降(gradient descent)很少直接用于深度学习, 但了解它是理解下一节随机梯度下降算法的关键。 例如,由于学习率过大,优化问题可能会发散,这种现象早已在梯度下降中出现。 同样地,预处理(preconditioning)是梯度下降中的一种常用技术, 还被沿用到更高级的算法中。 让我们从简单的一维梯度下降开始。
11.3.1. 一维梯度下降
11.3.1.1. 学习率
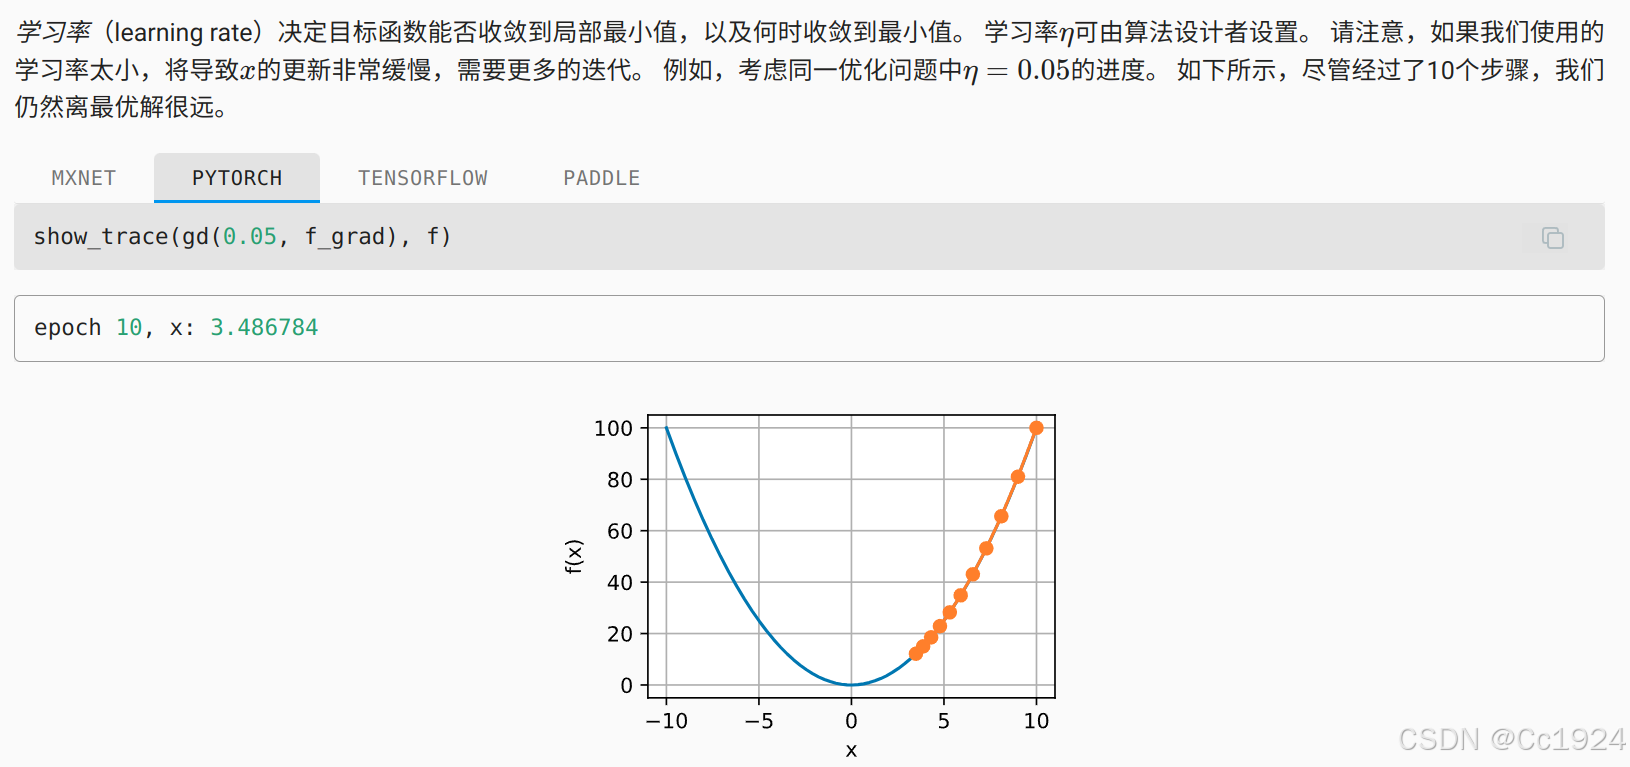
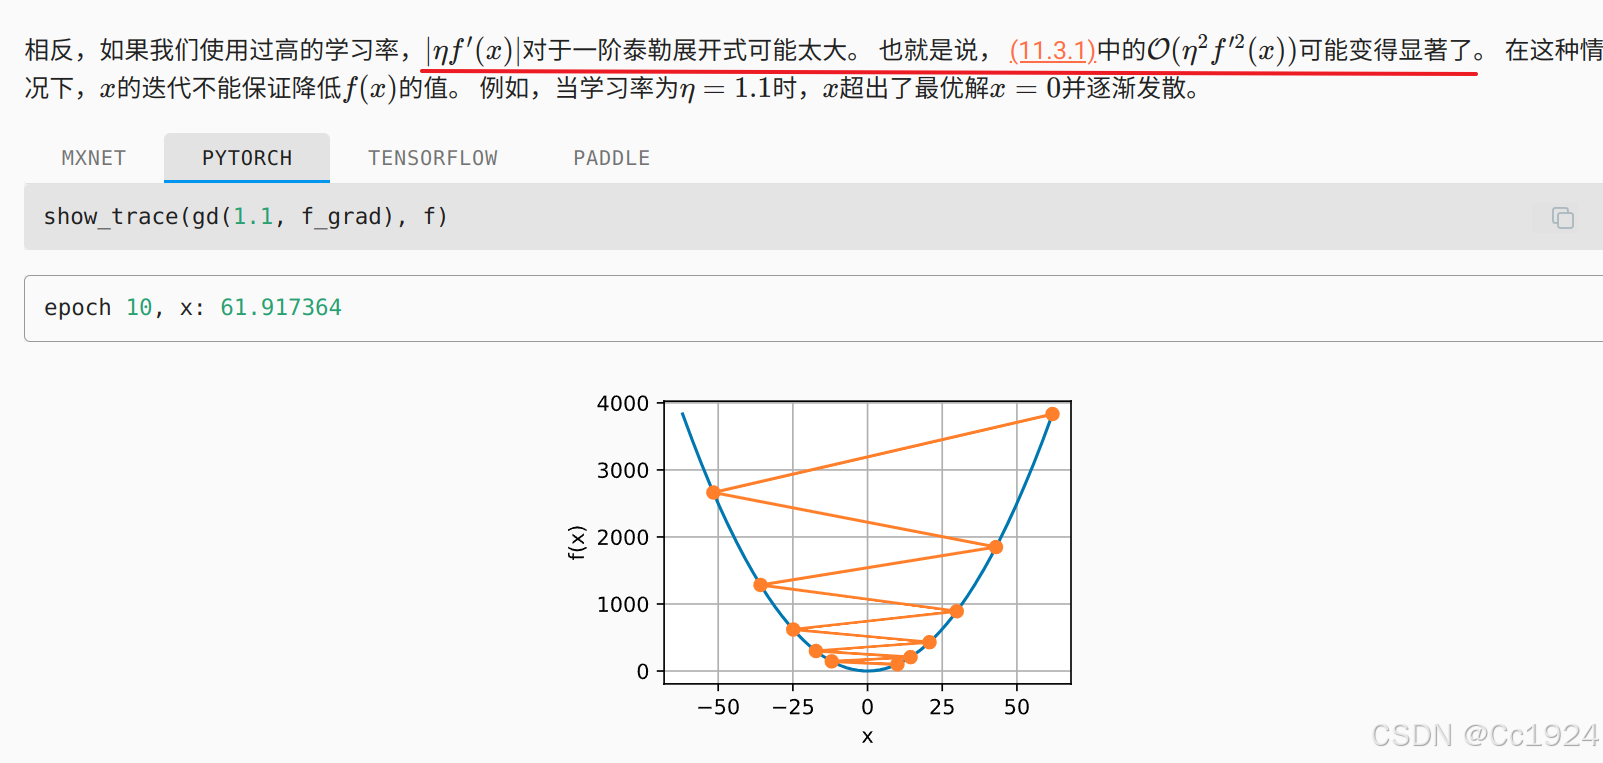
11.3.1.2. 局部最小值
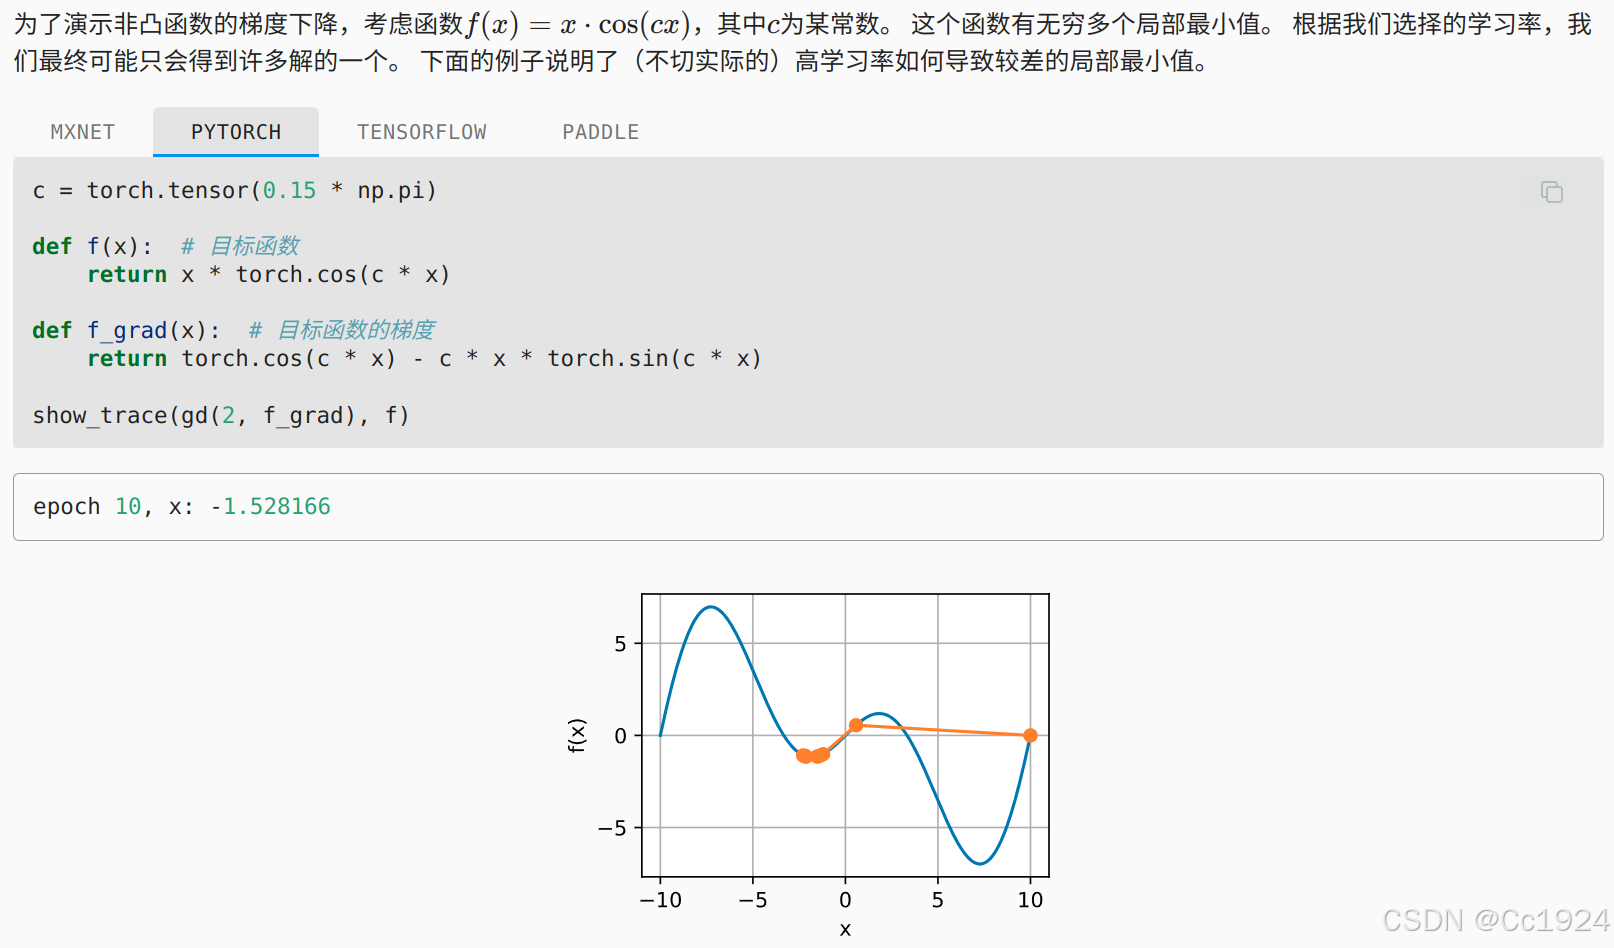
11.3.2. 多元梯度下降
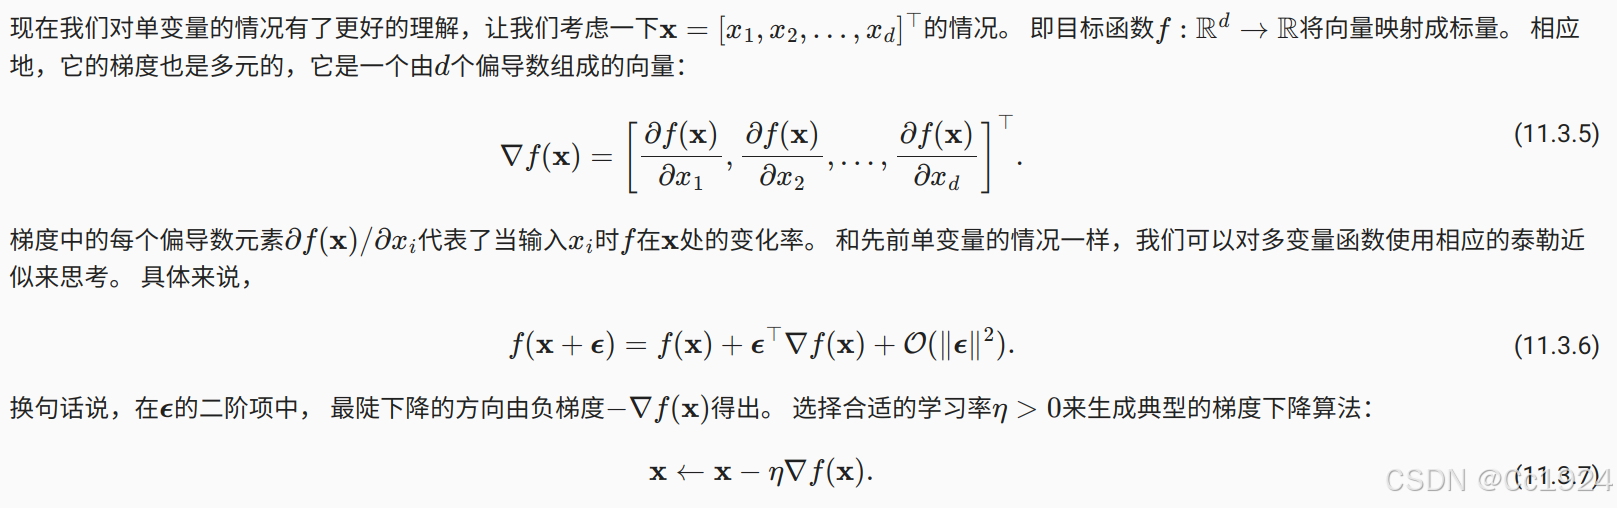
11.3.3. 自适应方法
正如我们在 11.3.1.1节中所看到的,选择“恰到好处”的学习率 η \eta η 是很棘手的。 如果我们把它选得太小,就没有什么进展;如果太大,得到的解就会振荡,甚至可能发散。 如果我们可以自动确定 η \eta η ,或者完全不必选择学习率,会怎么样? 除了考虑目标函数的值和梯度、还考虑它的曲率的二阶方法可以帮我们解决这个问题。 虽然由于计算代价的原因,这些方法不能直接应用于深度学习,但它们为如何设计高级优化算法提供了有用的思维直觉,这些算法可以模拟下面概述的算法的许多理想特性。
11.3.3.1. 牛顿法
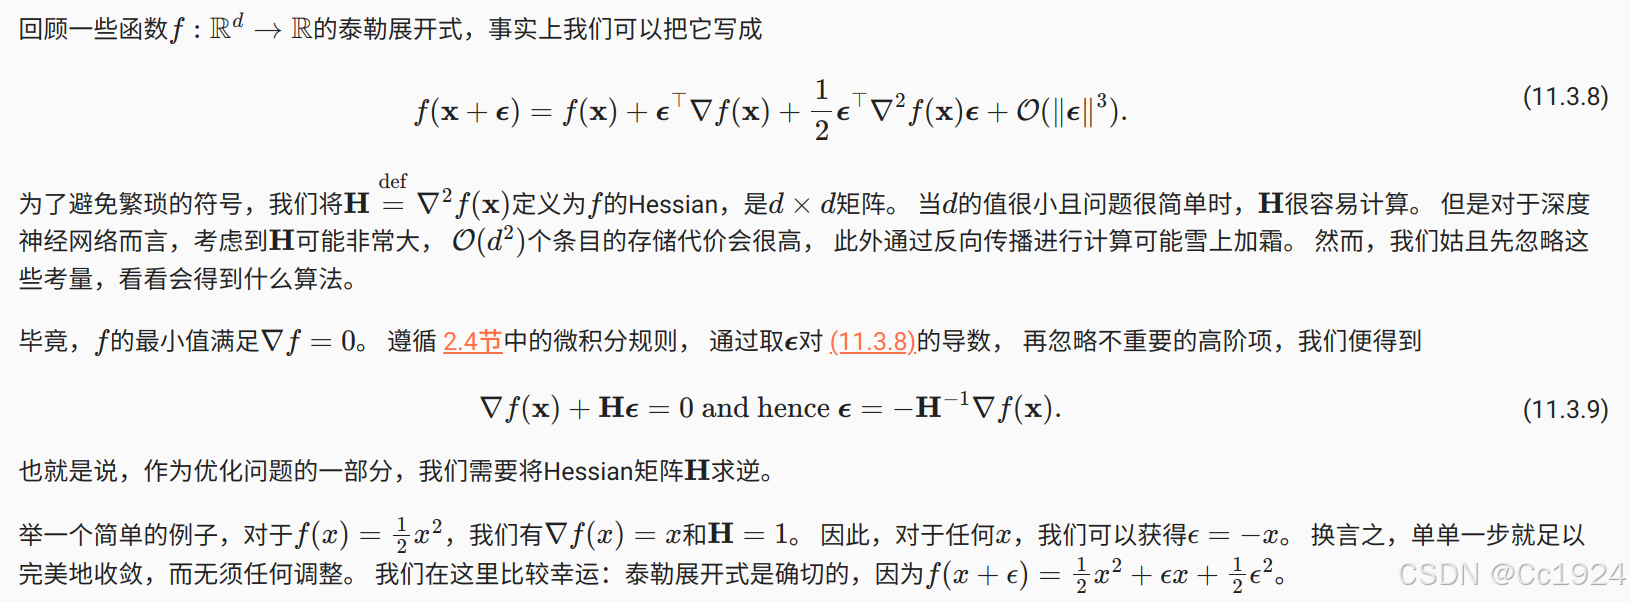
实际上就是求二阶导,用黑森矩阵直接求凸函数的最优解。但是对于非凸函数,请注意在牛顿法中,我们最终将除以Hessian。 这意味着如果二阶导数是负的,f 的值可能会趋于增加。 这是这个算法的致命缺陷! 让我们看看实践中会发生什么。
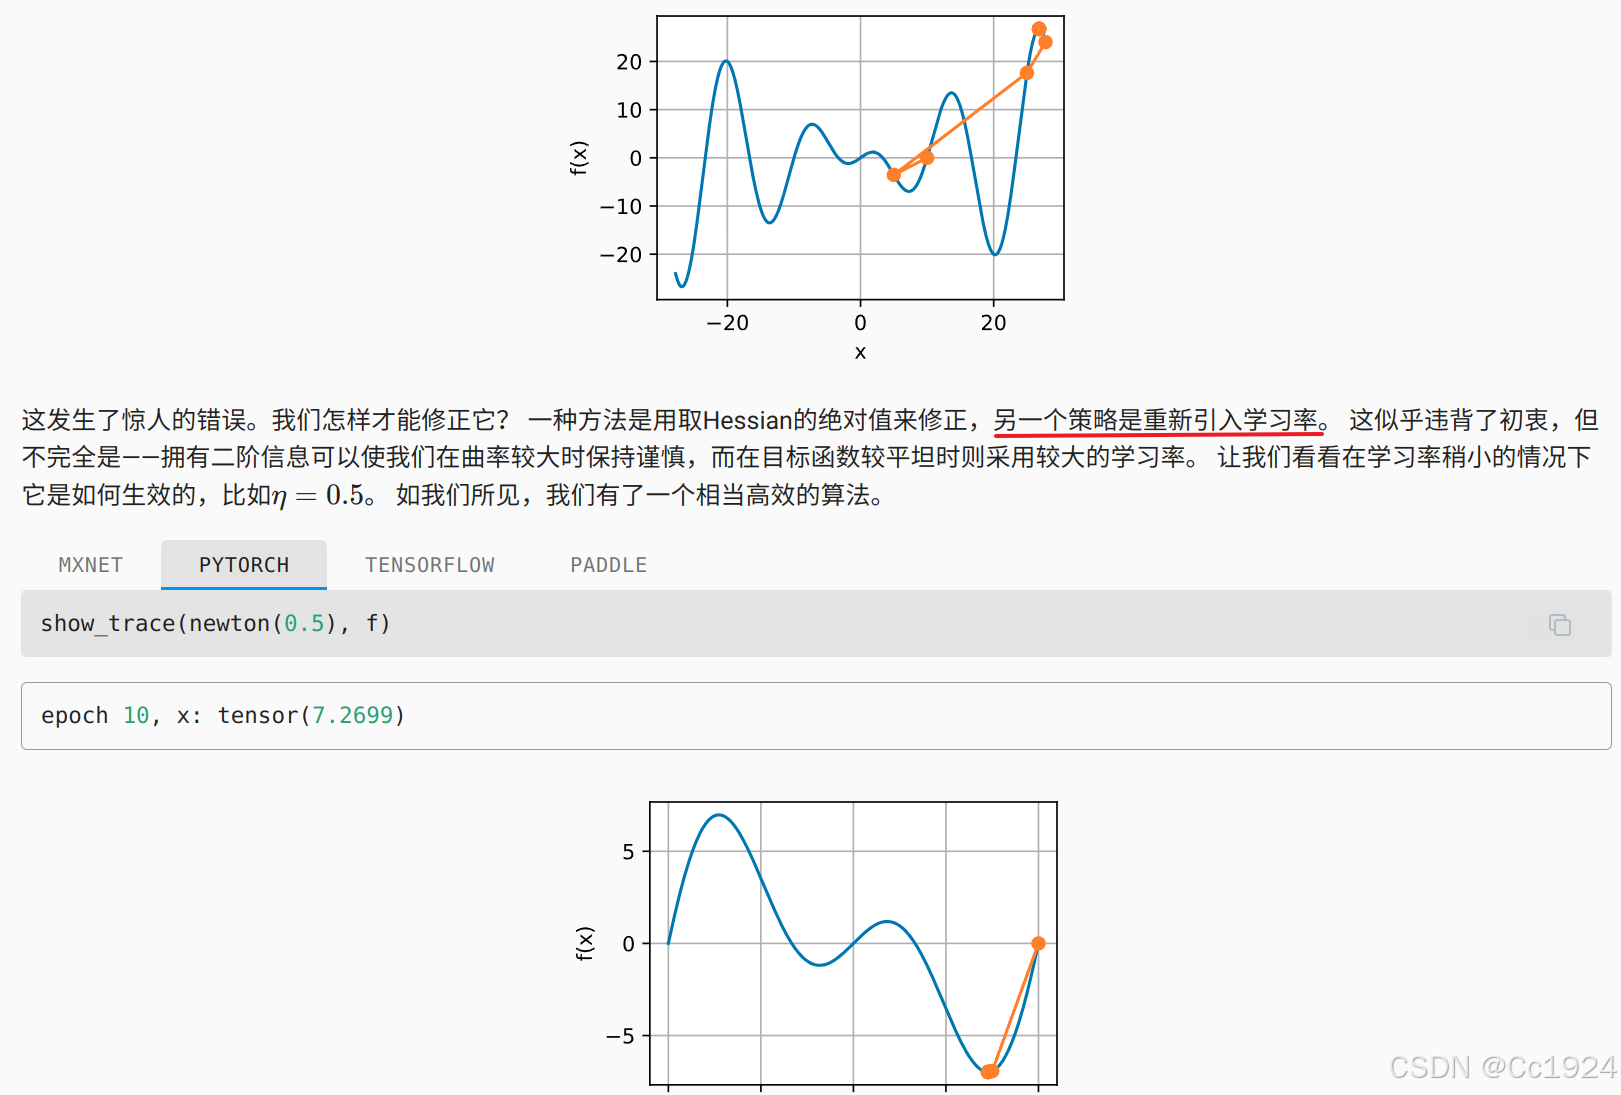
11.3.3.2. 收敛性分析
直接去看原文,内容不重要
11.3.3.3. 预处理
11.3.3.4. 梯度下降和线搜索
11.3.4. 小结
- 学习率的大小很重要:学习率太大会使模型发散,学习率太小会没有进展。
- 梯度下降会可能陷入局部极小值,而得不到全局最小值。
- 在高维模型中,调整学习率是很复杂的。
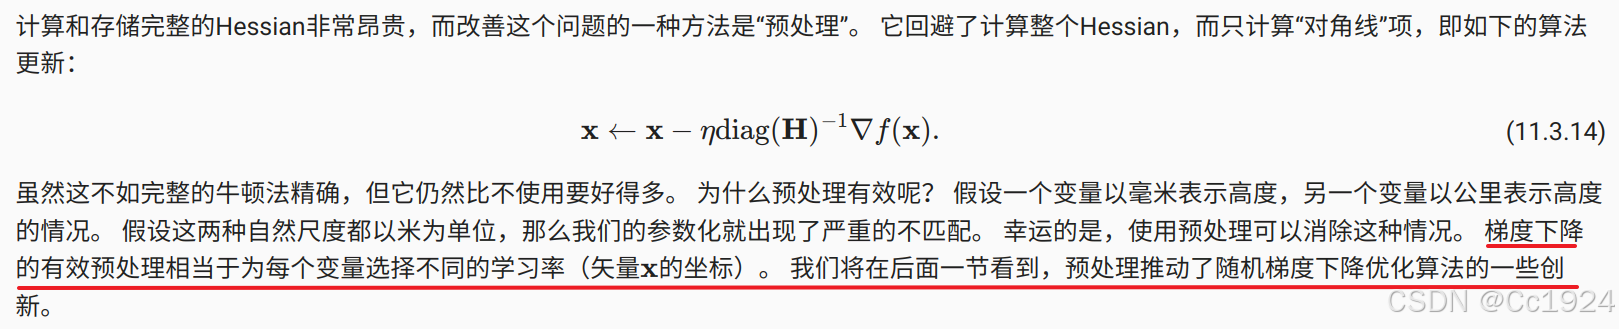
- 预处理有助于调节比例。(可以认为就是在向量的不同轴上调整学习率,从而统一数据比例)
- 牛顿法在凸问题中一旦开始正常工作,速度就会快得多。
- 对于非凸问题,不要不作任何调整就使用牛顿法。
11.4. 随机梯度下降
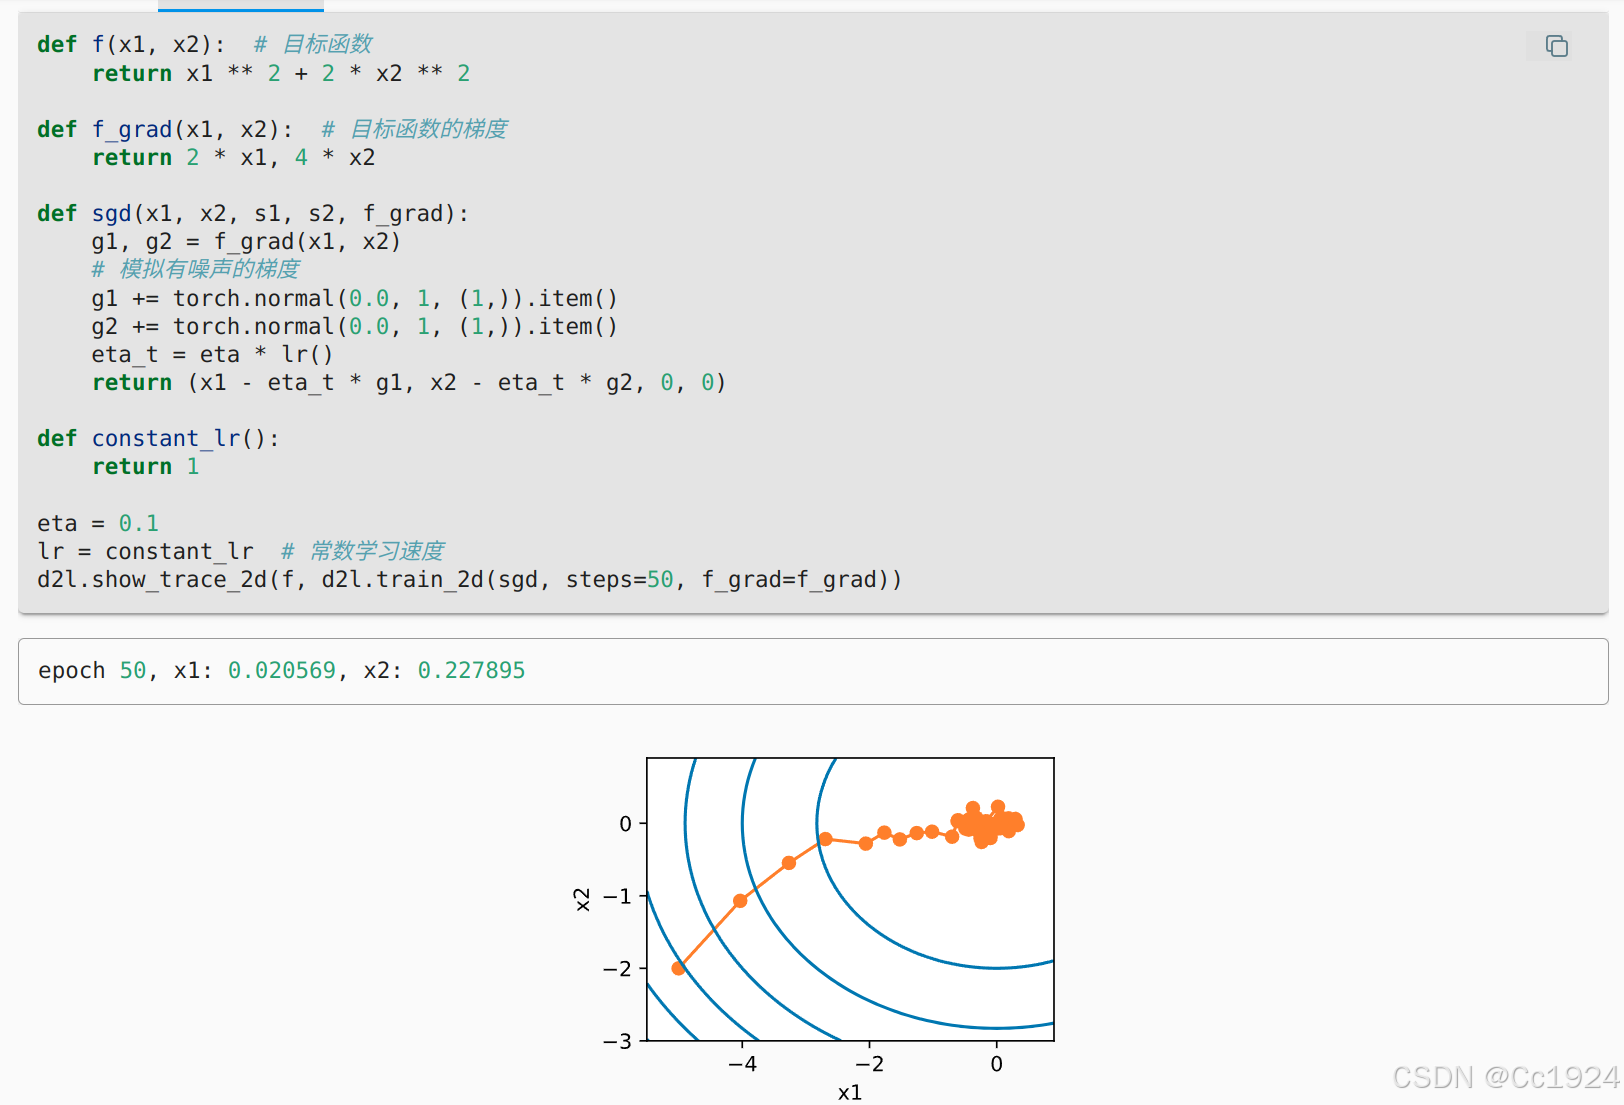
在前面的章节中,我们一直在训练过程中使用随机梯度下降,但没有解释它为什么起作用。为了澄清这一点,我们刚在 11.3节中描述了梯度下降的基本原则。本节继续更详细地说明随机梯度下降(stochastic gradient descent)。
11.4.1. 随机梯度更新
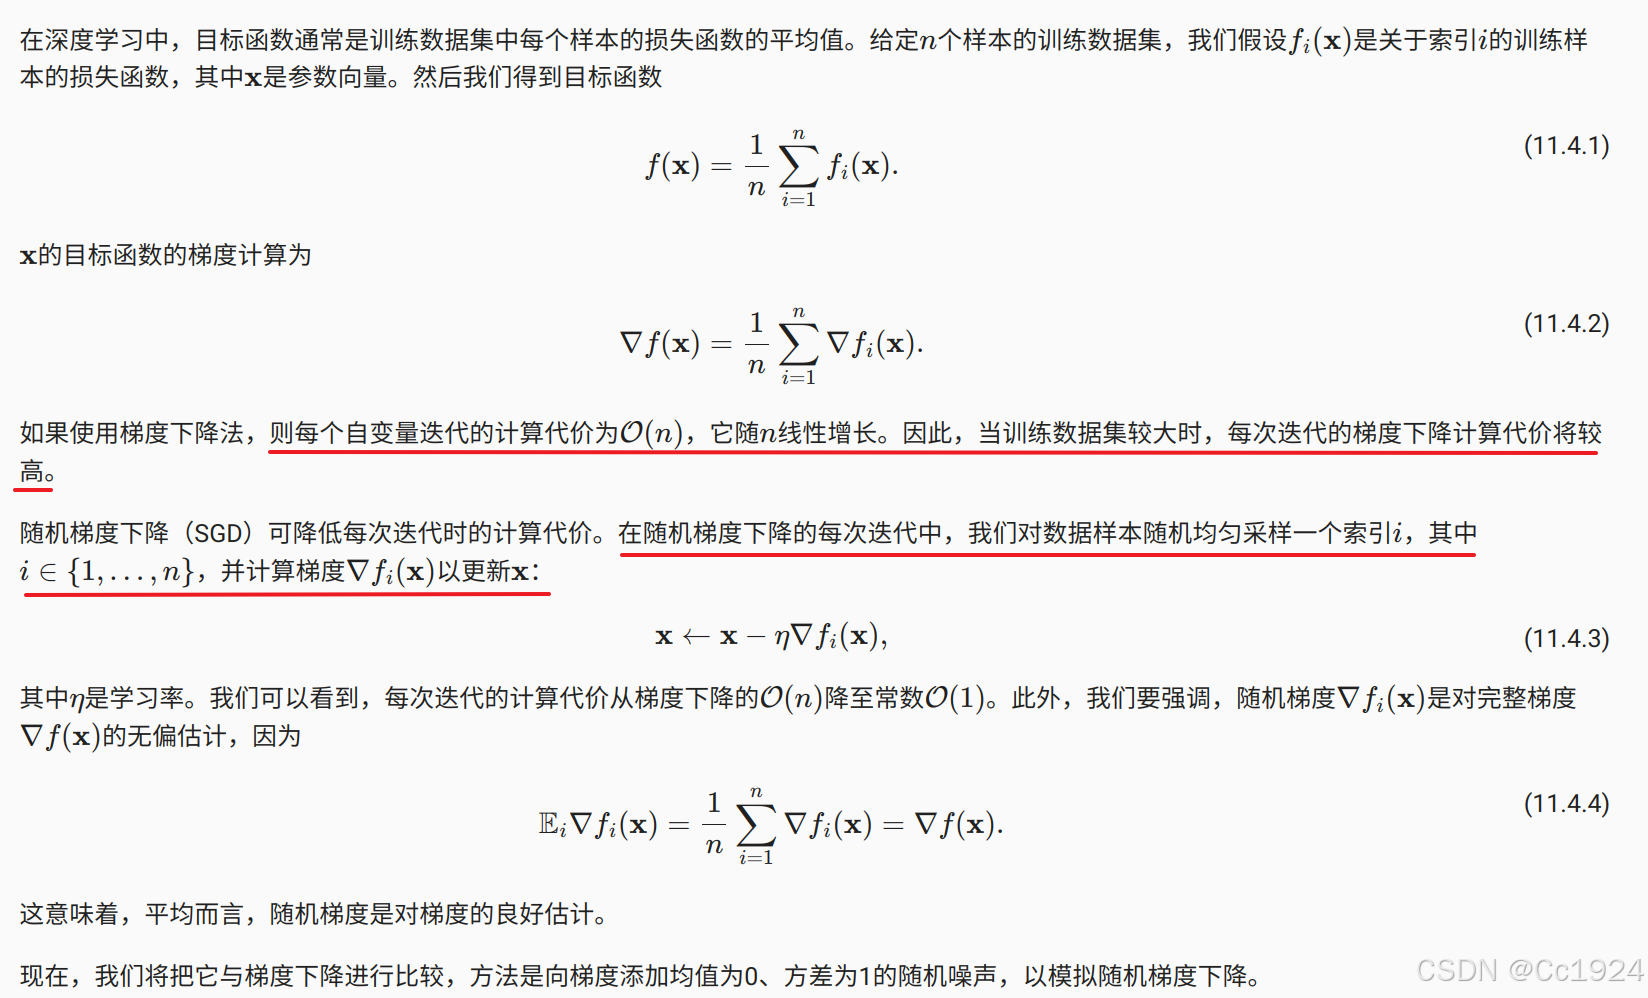
疑问:n个样本的loss不是在batch维度可以一次并行计算吗?计算代价为什么是 O(n) 呢?可能这里的意思是整个训练数据集的样本个数是 n,即使使用 batch 训练每次也只能训练少量的数据,所以就用这小批量的数据计算梯度,然后进行梯度下降。
def exponential_lr():
    # 在函数外部定义,而在内部更新的全局变量
    global t
    t += 1
    return math.exp(-0.1 * t)

t = 1
lr = exponential_lr
d2l.show_trace_2d(f, d2l.train_2d(sgd, steps=1000, f_grad=f_grad))
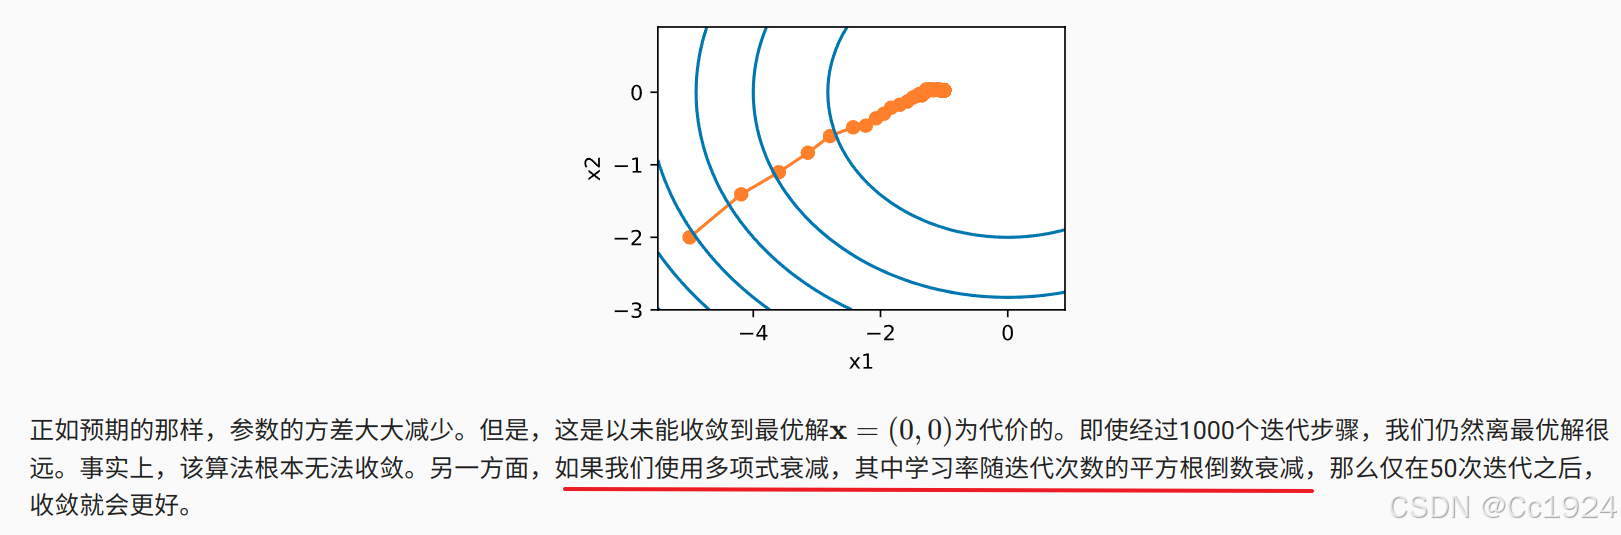
def polynomial_lr():
    # 在函数外部定义,而在内部更新的全局变量
    global t
    t += 1
    return (1 + 0.1 * t) ** (-0.5)

t = 1
lr = polynomial_lr
d2l.show_trace_2d(f, d2l.train_2d(sgd, steps=50, f_grad=f_grad))
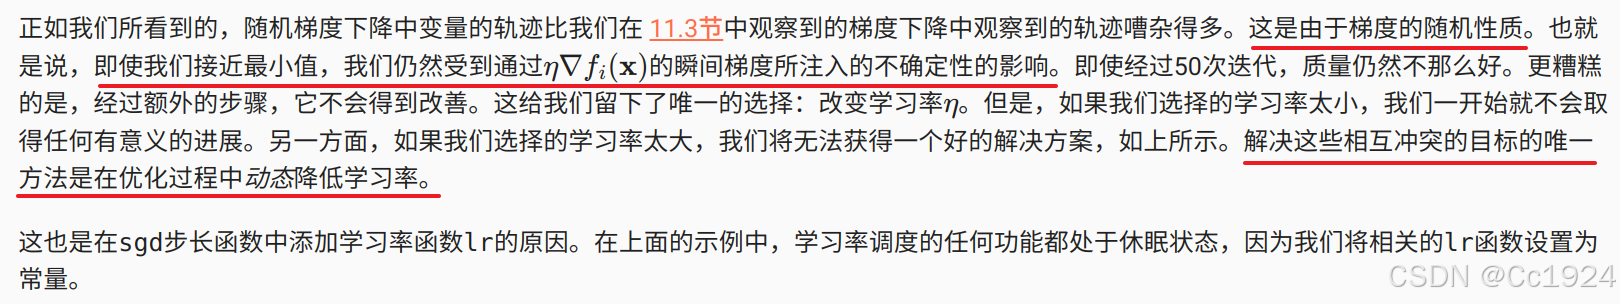
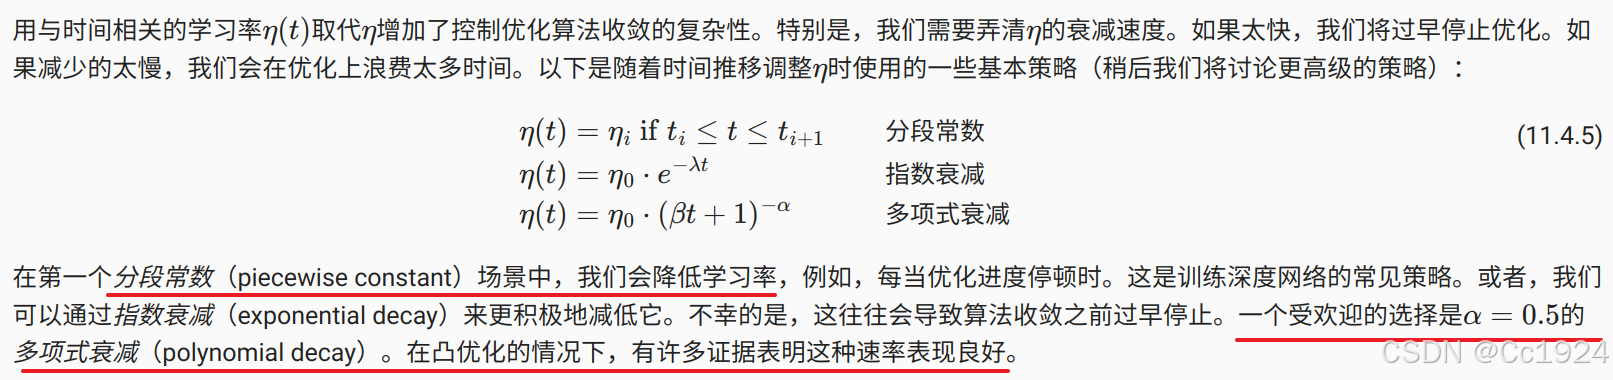
关于如何设置学习率,还有更多的选择。例如,我们可以从较小的学习率开始,然后使其迅速上涨,再让它降低,尽管这会更慢。我们甚至可以在较小和较大的学习率之间切换。现在,让我们专注于可以进行全面理论分析的学习率计划,即凸环境下的学习率。对一般的非凸问题,很难获得有意义的收敛保证,因为总的来说,最大限度地减少非线性非凸问题是NP困难的。有关的研究调查,请参阅例如2015年Tibshirani的优秀讲义笔记。
11.4.3. 凸目标的收敛性分析
都是数学推导,不太重要,可以直接去看原文:https://zh.d2l.ai/chapter_optimization/sgd.html
11.4.4. 随机梯度和有限样本
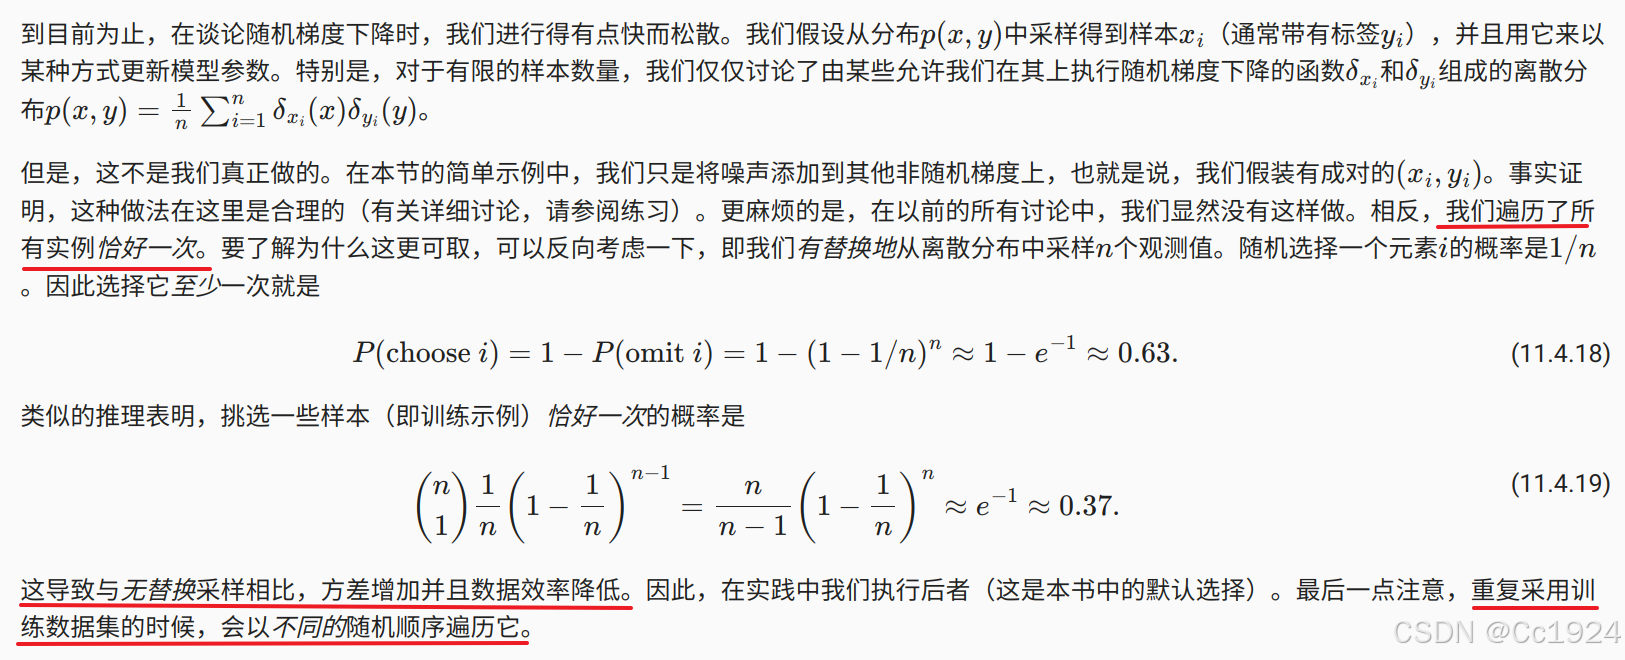
解释:这里大概就是说每次迭代随机选择数据的时候是在整个训练集中无放回地选择的,并且把整个训练集迭代完一次之后,会更换随机种子以新的顺序再随机选择数据进行迭代。
11.4.5. 小结
- 对于凸问题,我们可以证明,对于广泛的学习率选择,随机梯度下降将收敛到最优解。
- 对于深度学习而言,情况通常并非如此。但是,对凸问题的分析使我们能够深入了解如何进行优化,即逐步降低学习率,尽管不是太快。
- 如果学习率太小或太大,就会出现问题。实际上,通常只有经过多次实验后才能找到合适的学习率。
- 当训练数据集中有更多样本时,计算梯度下降的每次迭代的代价更高,因此在这些情况下,首选随机梯度下降。
- 随机梯度下降的最优性保证在非凸情况下一般不可用,因为需要检查的局部最小值的数量可能是指数级的。
11.5. 小批量随机梯度下降
到目前为止,我们在基于梯度的学习方法中遇到了两个极端情况: 11.3节中使用完整数据集来计算梯度并更新参数, 11.4节中一次处理一个训练样本来取得进展。 二者各有利弊:每当数据非常相似时,梯度下降并不是非常“数据高效”。 而由于CPU和GPU无法充分利用向量化,随机梯度下降并不特别“计算高效”。 这暗示了两者之间可能有折中方案,这便涉及到小批量随机梯度下降(minibatch gradient descent)。
解释:也就是说,梯度下降是使用整个训练集的数据计算loss和梯度,随机梯度下降是在训练集中随机选择一个样本计算loss和梯度,而小批量随机梯度下降则是计算一个batch中的样本的loss和梯度(是前二者的折中)。
11.5.1. 向量化和缓存
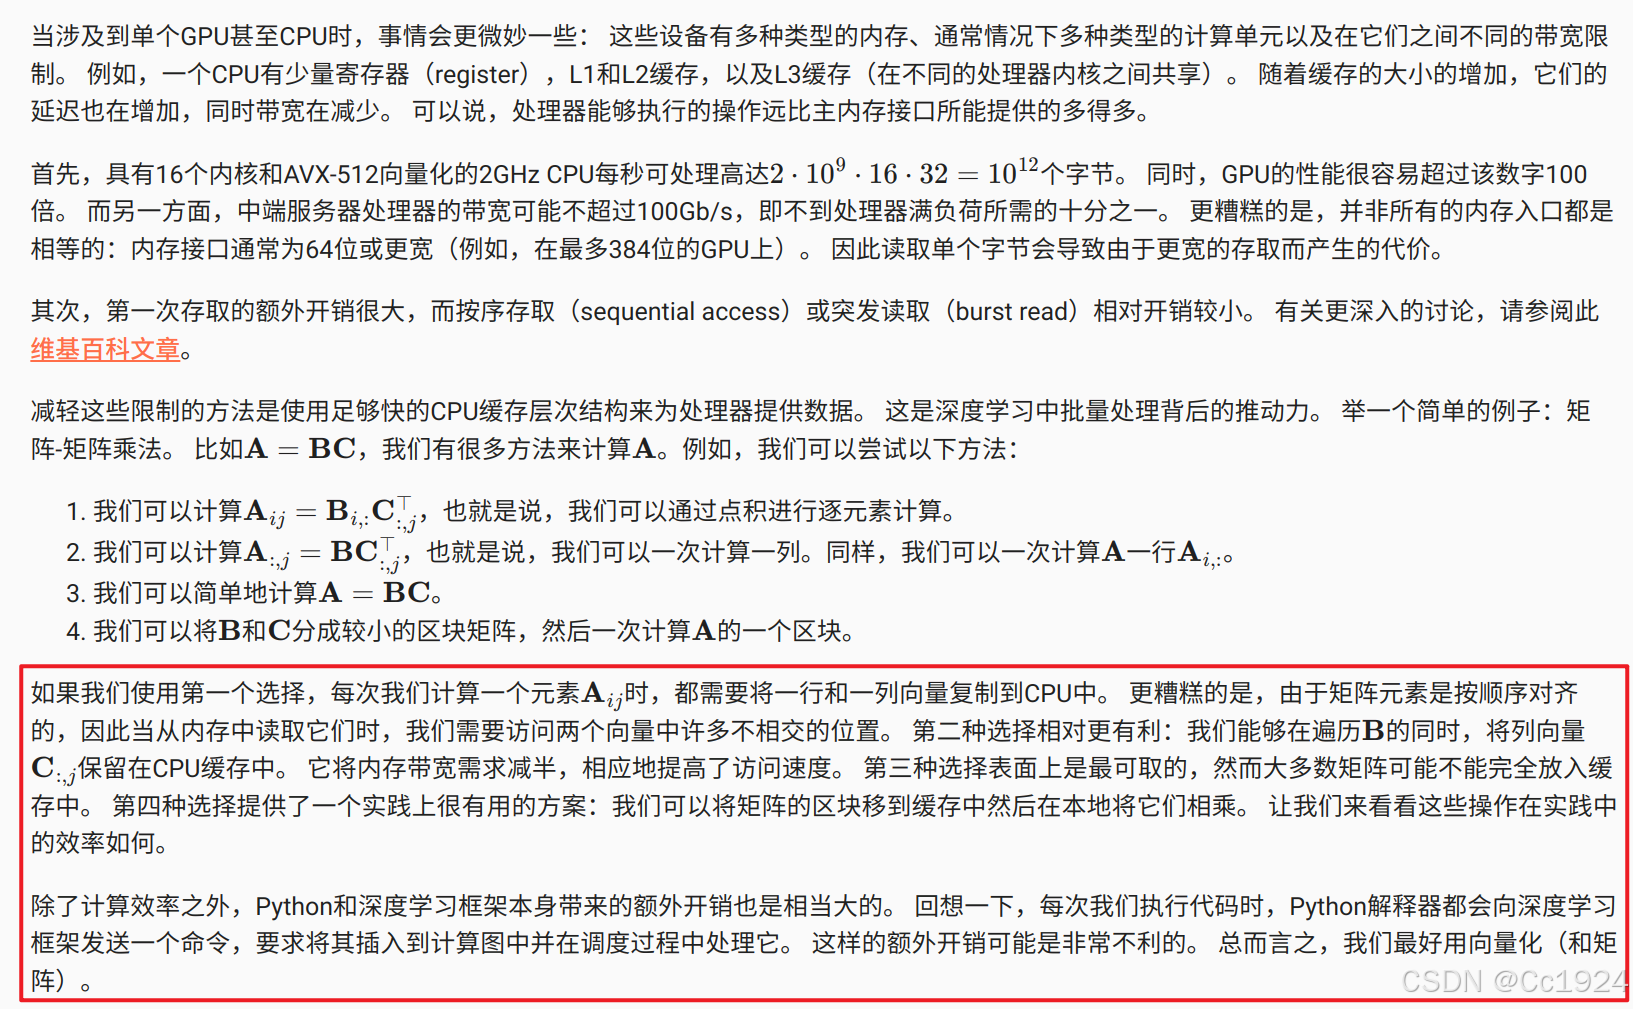
解释:这里其实就是再说为什么要使用小批量,因为随机梯度下降使用单个样本,每次都要读取数据、并且运行深度学习框架的计算,所以计算效率很低;梯度下降计算所有样本,但是数据量太大不能全部放入缓存中;而小批量随机梯度下降一次计算一小批的数据,较好地利用了向量化和矩阵计算。
11.5.2. 小批量
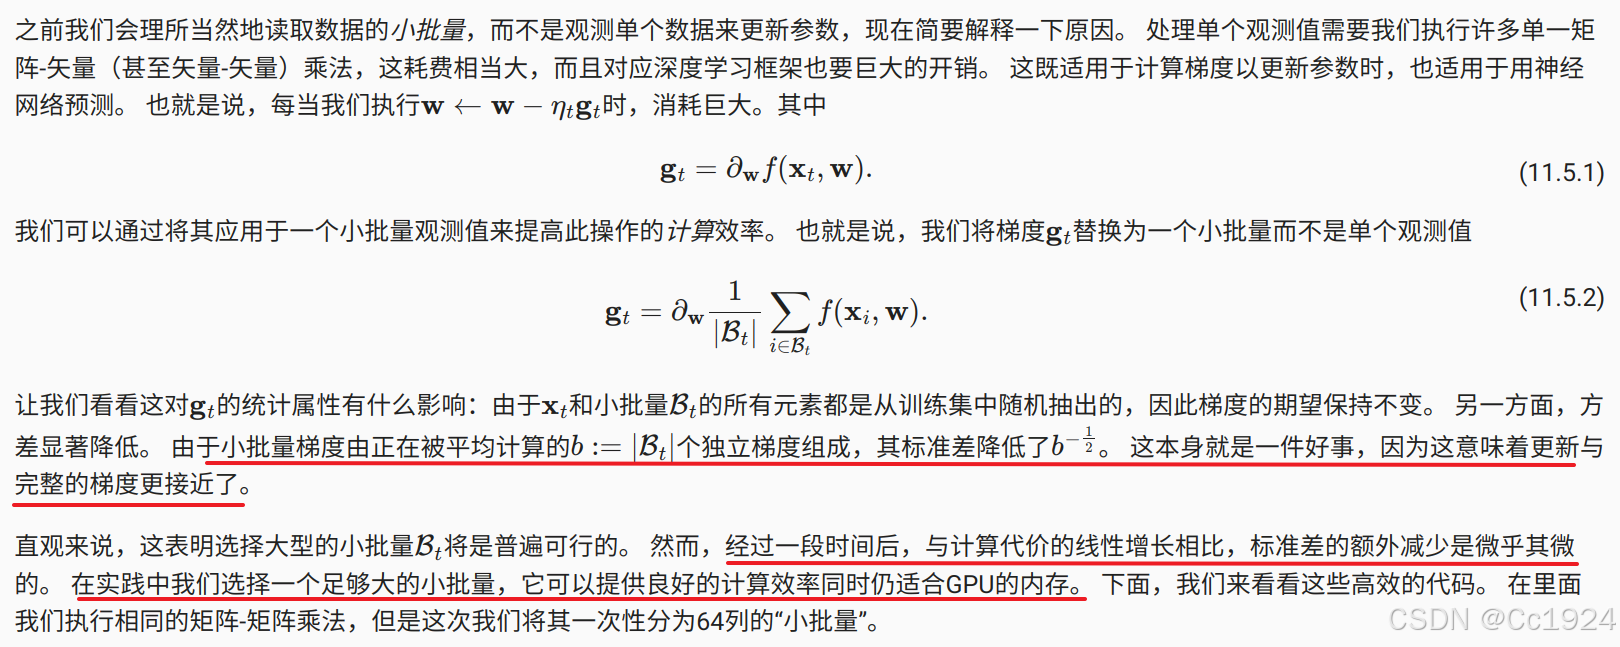
解释:首先小批量比单个数据在计算梯度的时候方差更小,更接近整个数据集的完整梯度;但是经过一段时间的迭代之后方差就不是主要影响了,而是小批量的计算效率比单个数据更高。因此尽量要选择适合GPU内存的足够大的小批量。
11.5.3. 读取数据集
11.5.4. 从零开始实现
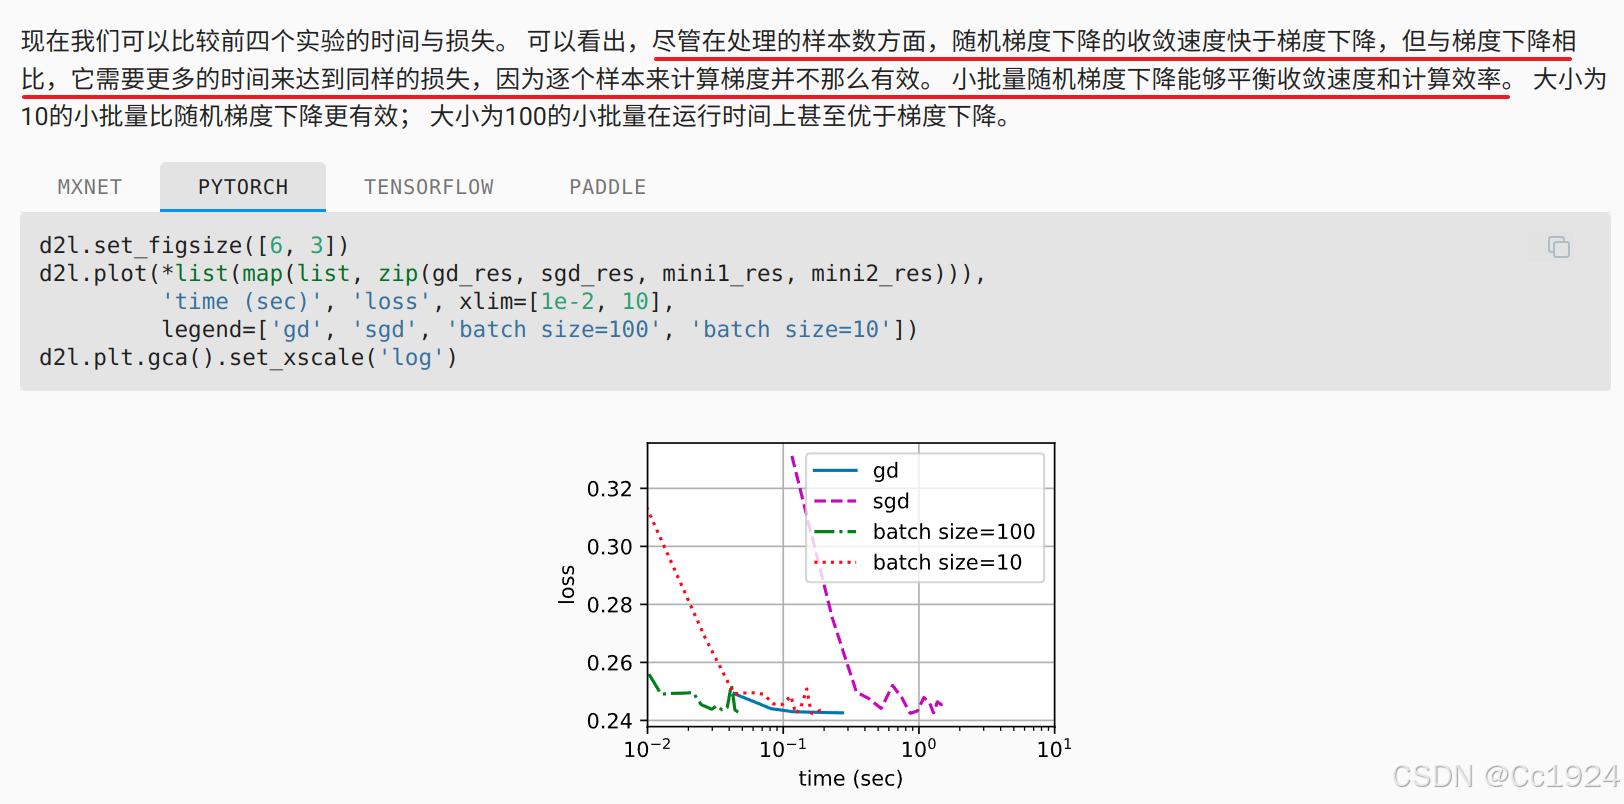
这两节没有什么主要内容,其实就是测试了使用不同大小的小批量进行训练,收敛速度和计算速度的对比。
11.5.6. 小结
- 由于减少了深度学习框架的额外开销,使用更好的内存定位以及CPU和GPU上的缓存,向量化使代码更加高效。
- 随机梯度下降的“统计效率”与大批量一次处理数据的“计算效率”之间存在权衡。小批量随机梯度下降提供了两全其美的答案:计算和统计效率。
- 在小批量随机梯度下降中,我们处理通过训练数据的随机排列获得的批量数据(即每个观测值只处理一次,但按随机顺序)。
- 在训练期间降低学习率有助于训练。
- 一般来说,小批量随机梯度下降比随机梯度下降和梯度下降的速度快,收敛风险较小。
11.6. 动量法
11.6.1. 基础
本节将探讨更有效的优化算法,尤其是针对实验中常见的某些类型的优化问题。
11.6.1.1. 泄漏平均值
11.6.1.2. 条件不佳的问题
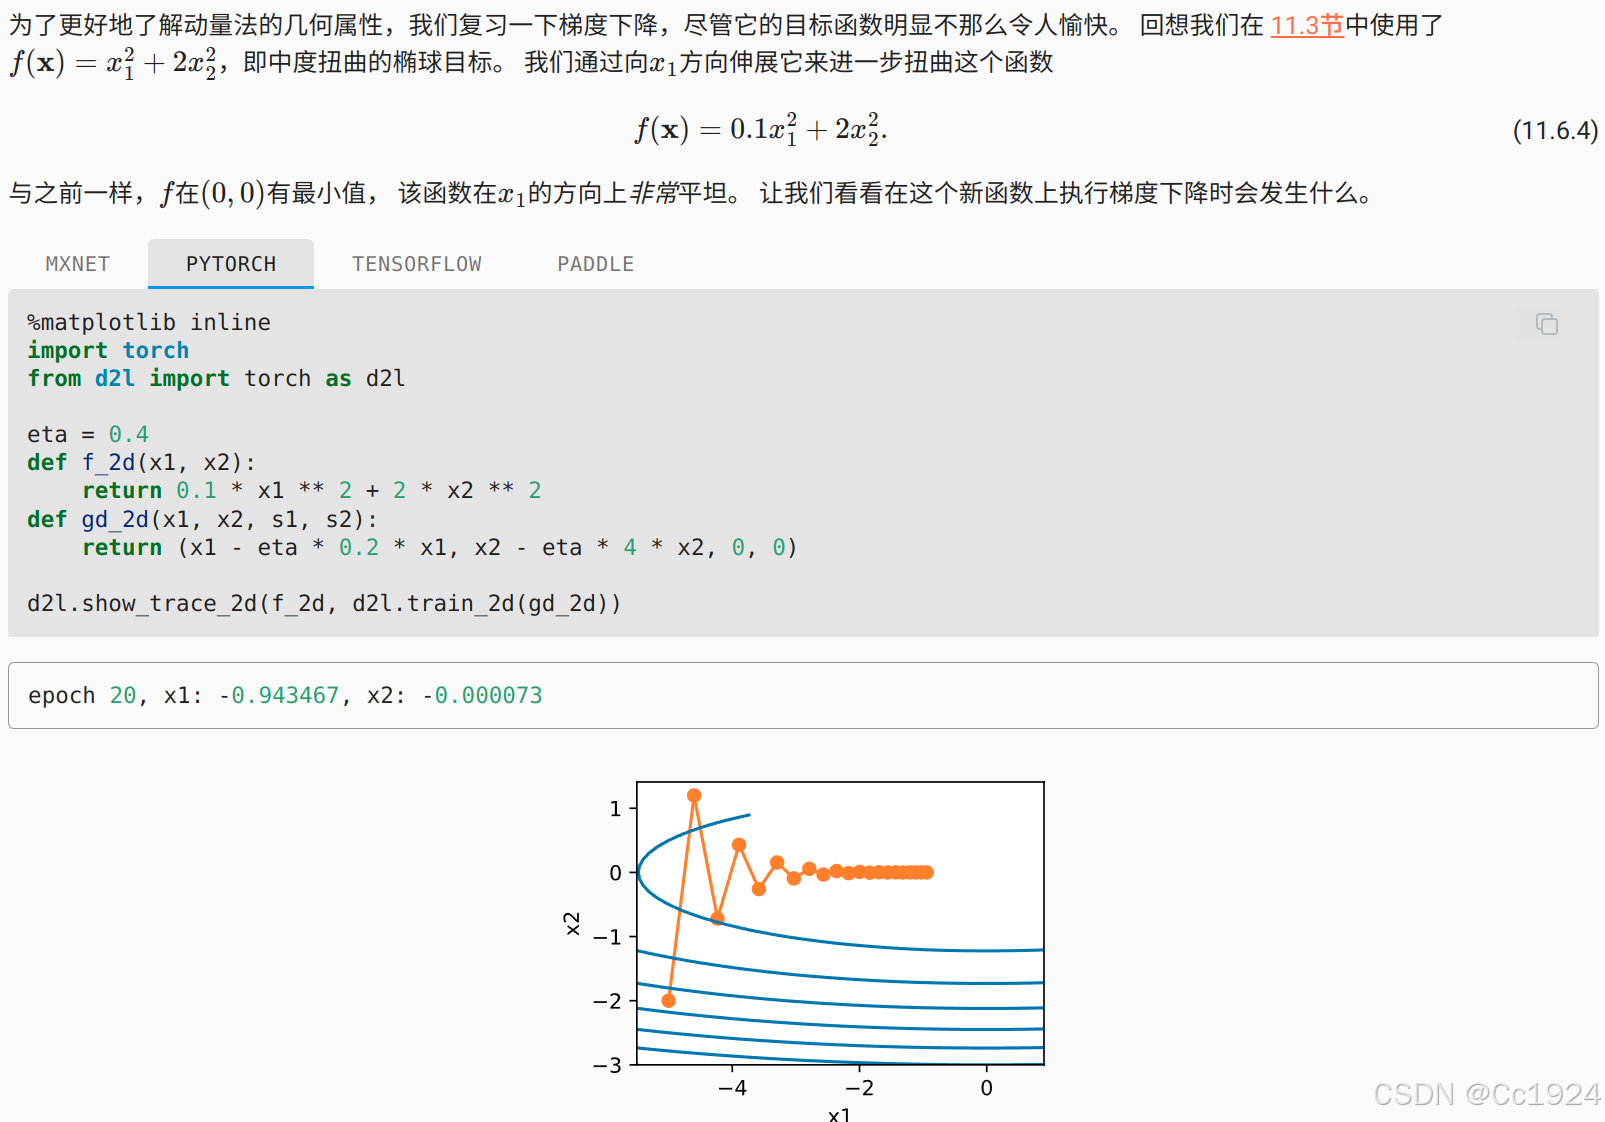
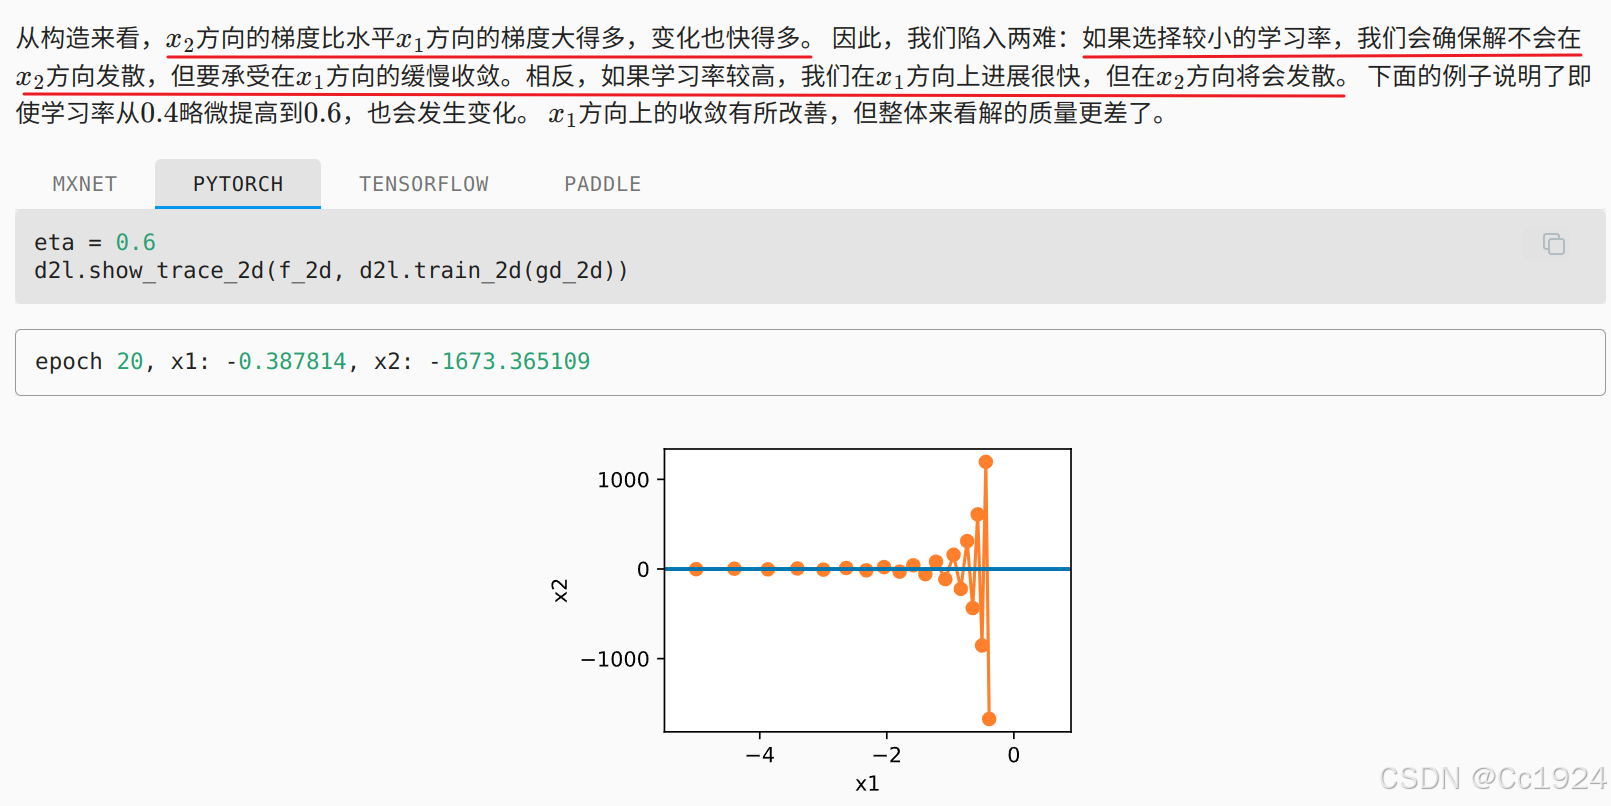
11.6.1.3. 动量法
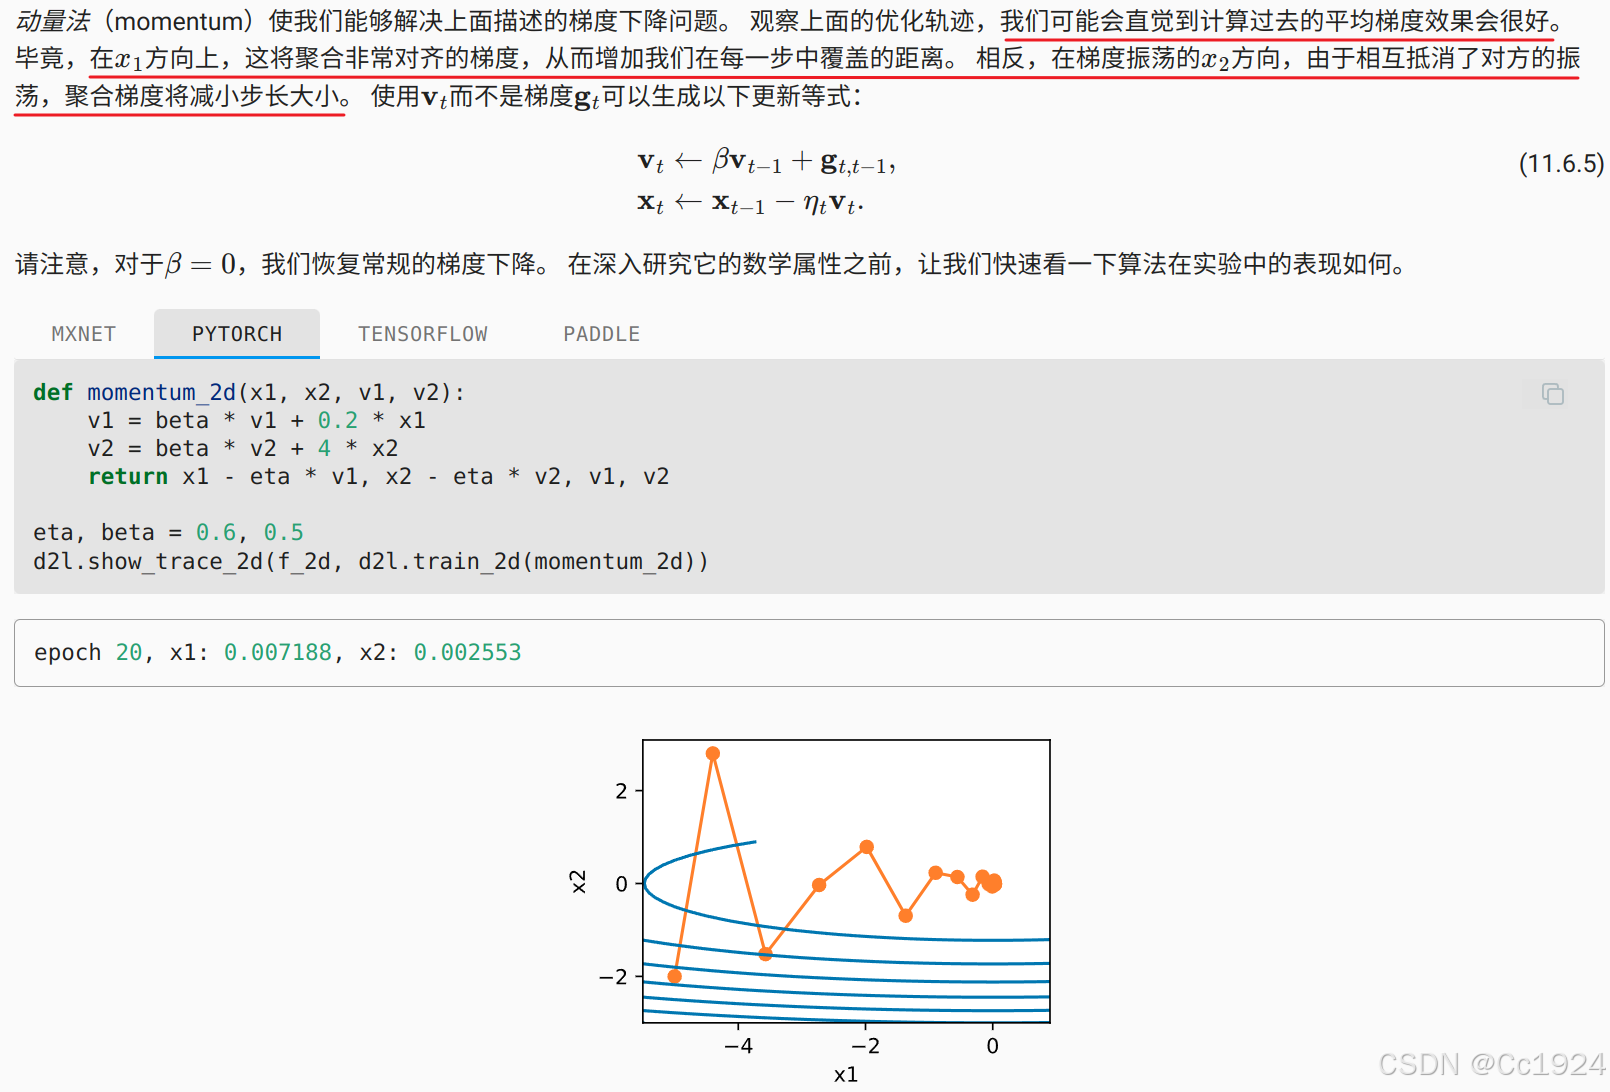
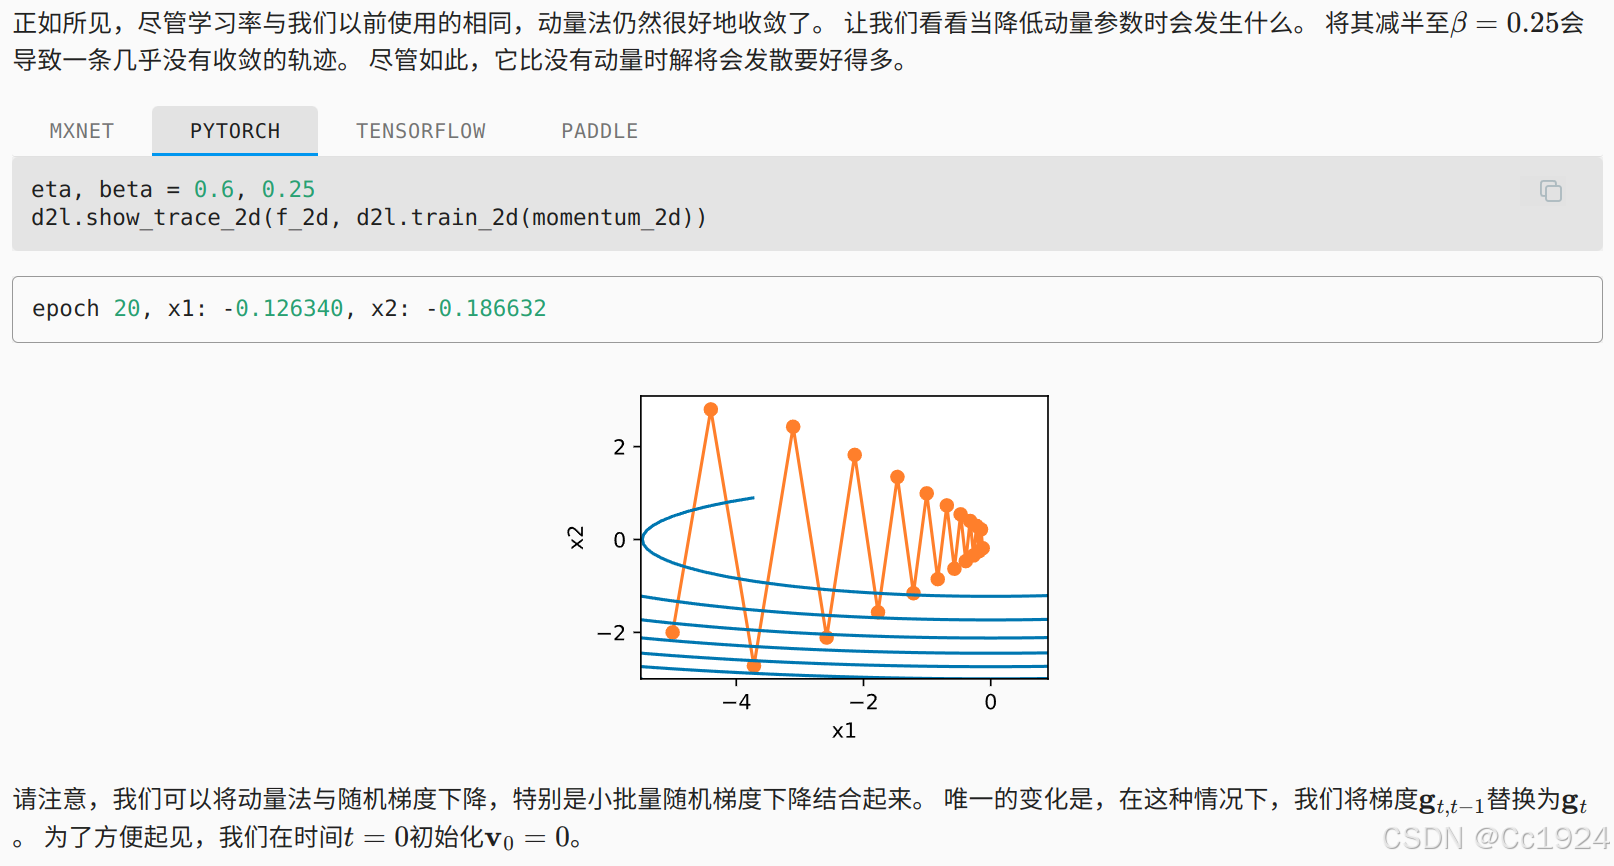
11.6.1.4. 有效样本权重
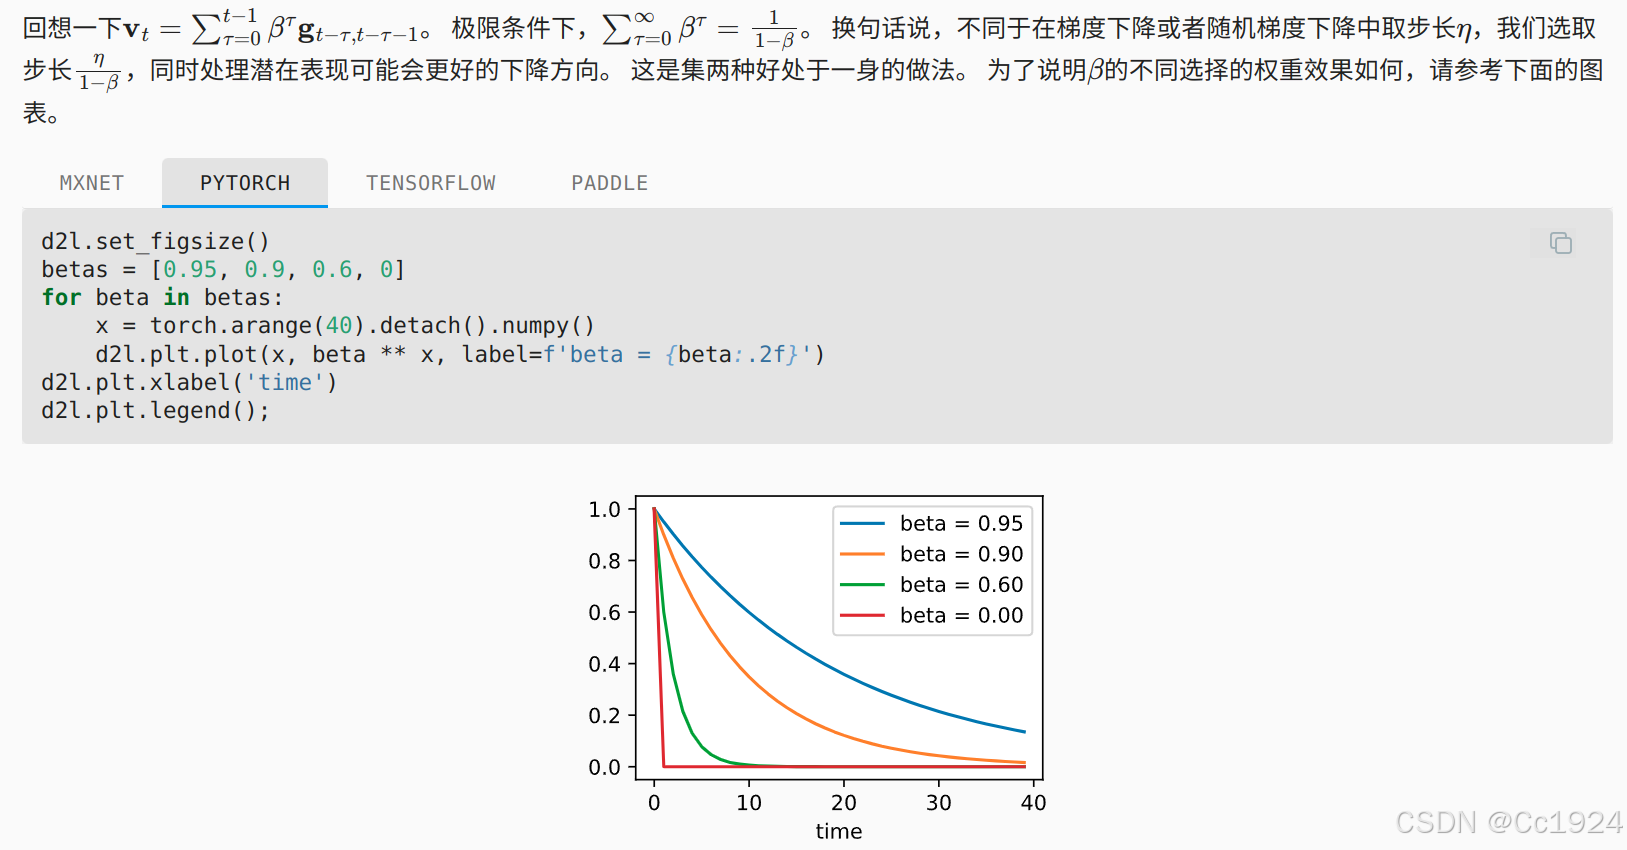
TODO:这里没看懂什么意思,但是感觉也不太重要。
11.6.2. 实际实验
11.6.2.1. 从零开始实现
相比于小批量随机梯度下降,动量方法需要维护一组辅助变量,即速度。 它与梯度以及优化问题的变量具有相同的形状。 在下面的实现中,我们称这些变量为states。
def init_momentum_states(feature_dim):
    v_w = torch.zeros((feature_dim, 1))
    v_b = torch.zeros(1)
    return (v_w, v_b)

def sgd_momentum(params, states, hyperparams):
    for p, v in zip(params, states):
        with torch.no_grad():
            v[:] = hyperparams['momentum'] * v + p.grad
            p[:] -= hyperparams['lr'] * v
        p.grad.data.zero_()
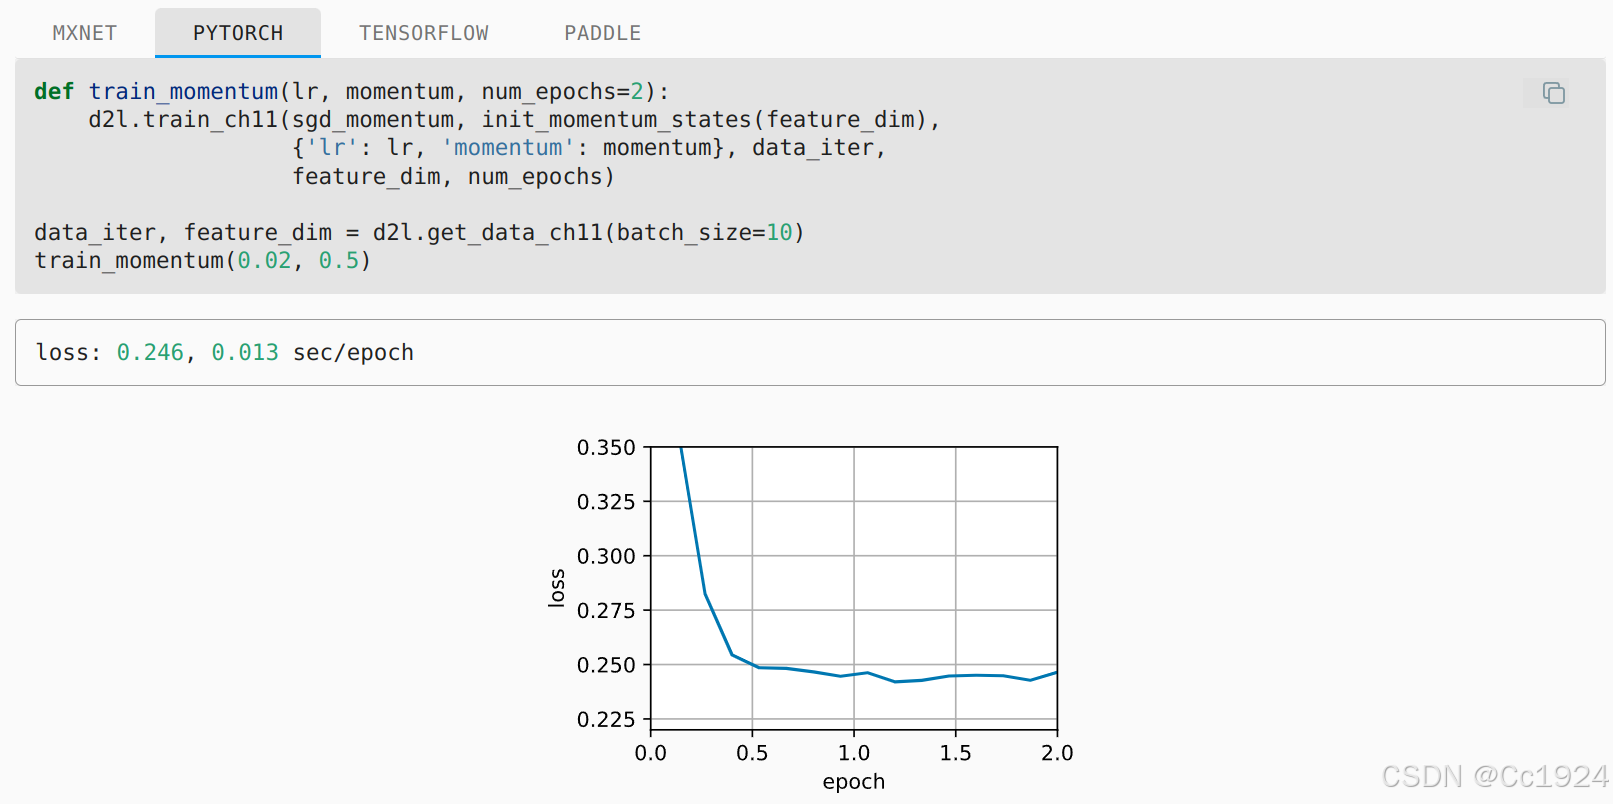
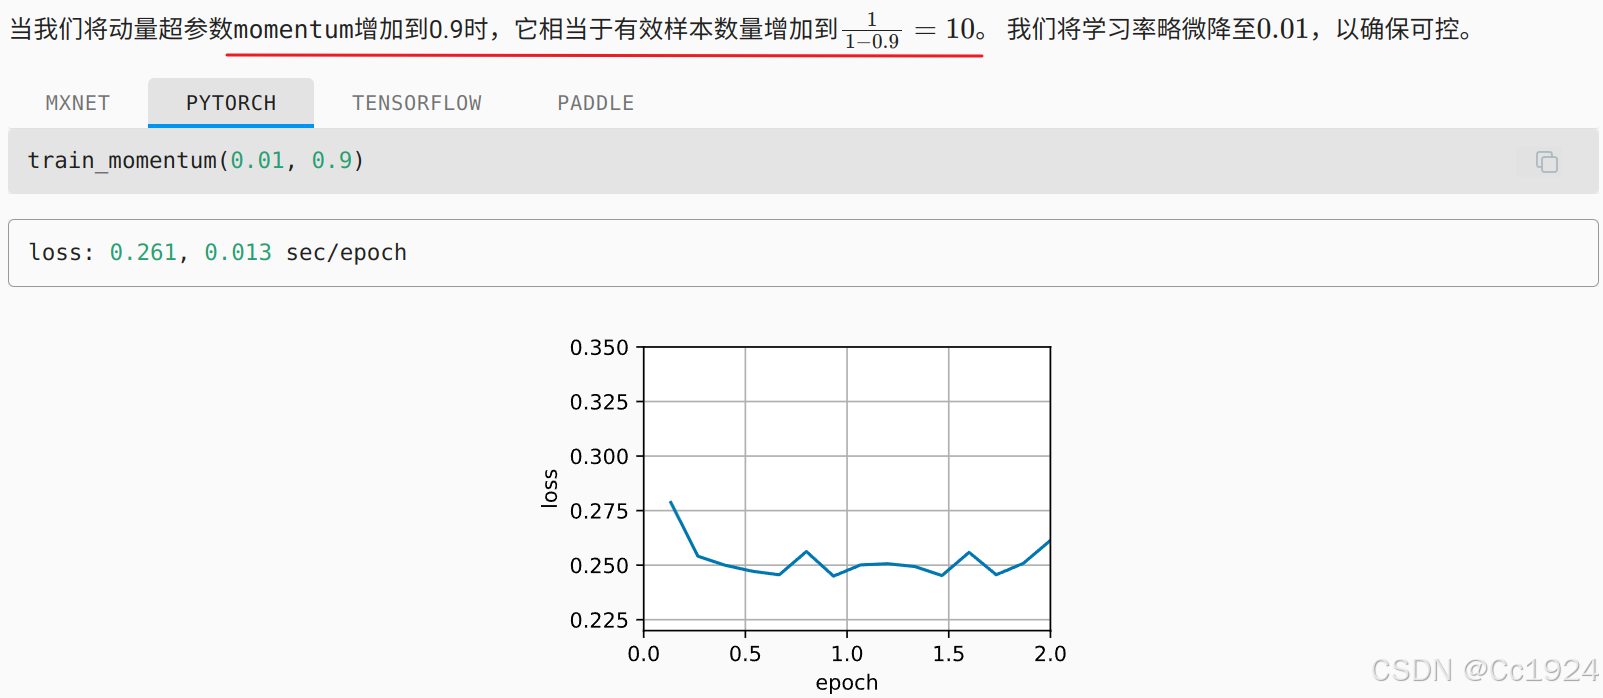
解释:这里就是上面一节说的有效样本数量,感觉意思应该就是动量是一个迭代的加权平均,所以相当于累积了过去很多数据的梯度,这里有效样本数量指的就是累积了多少数据的平均梯度。
11.6.2.2. 简洁实现
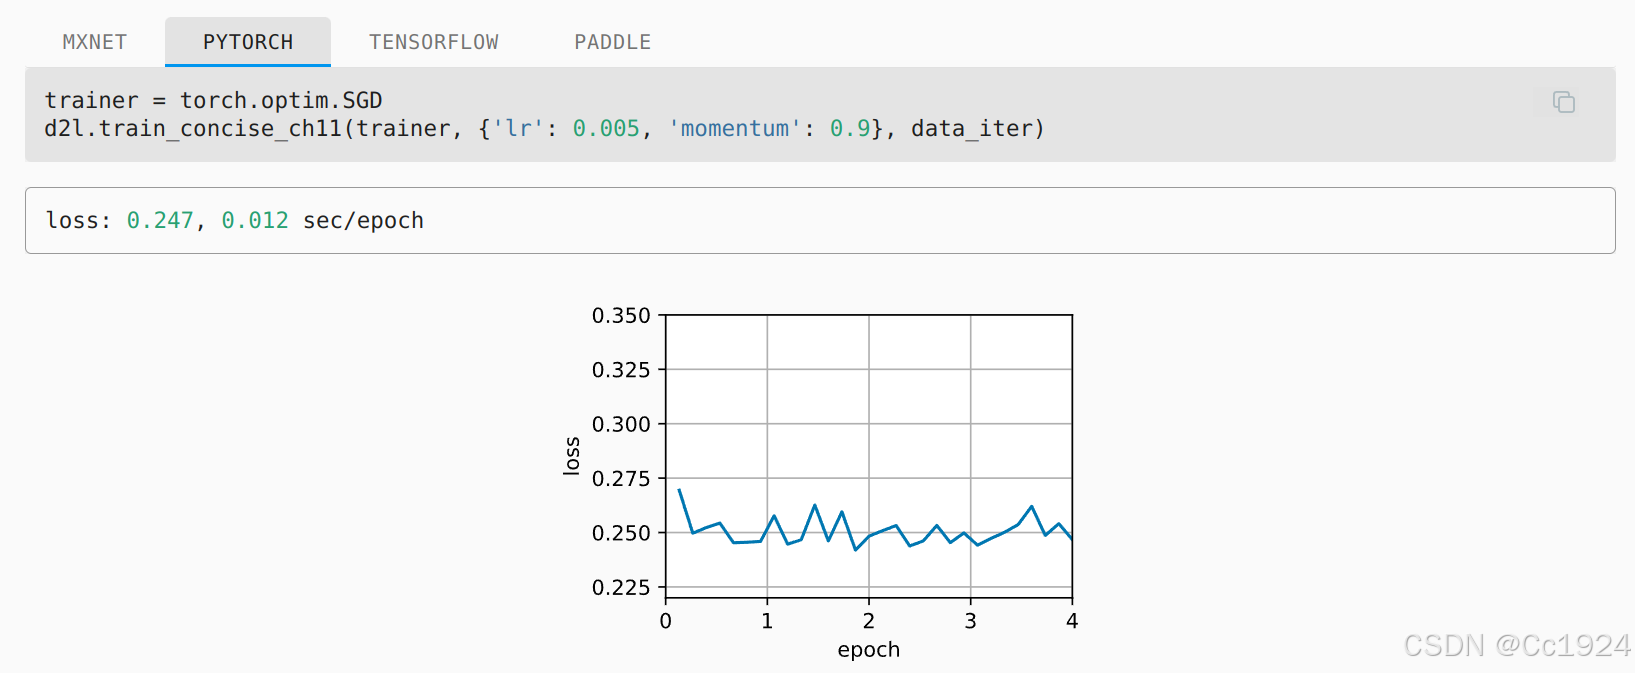
由于深度学习框架中的优化求解器早已构建了动量法,设置匹配参数会产生非常类似的轨迹。
11.6.3. 理论分析
这部分全都是数学推导,不太重要,可以直接去看原文:https://zh.d2l.ai/chapter_optimization/momentum.html
注意:这一节理论分析最后给出了一个结论:另外,一般而言较大值的 β \beta β 是可取的。通常会选择为0.9。
11.6.4. 小结
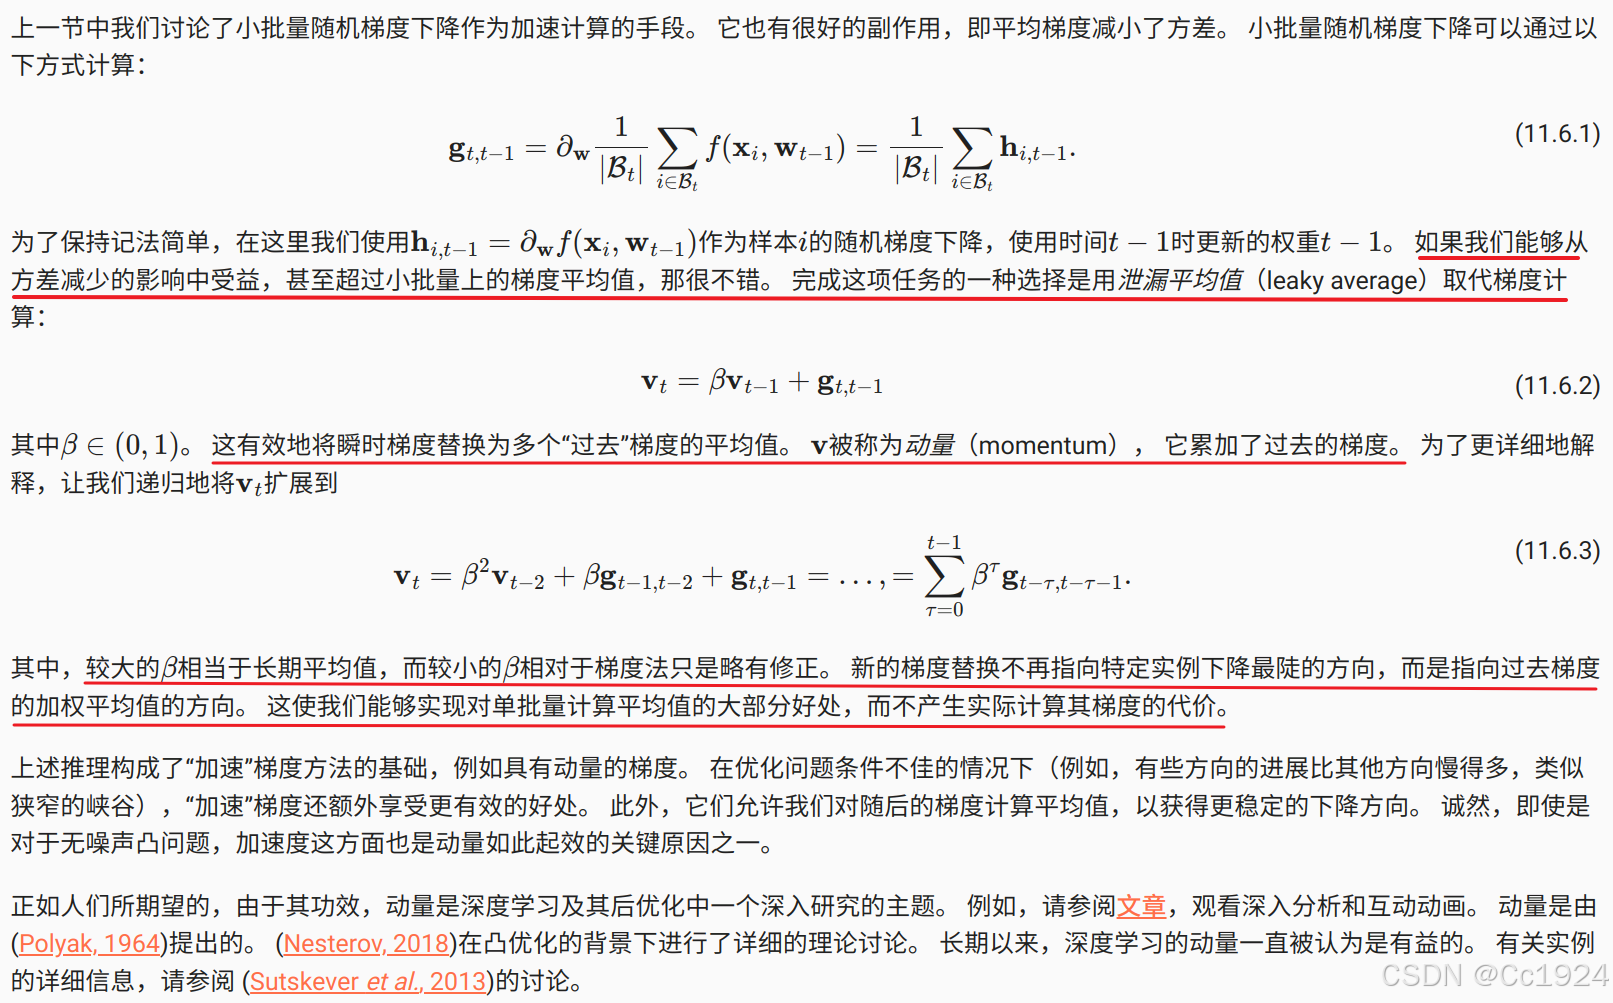
- 动量法用过去梯度的平均值来替换梯度,这大大加快了收敛速度。
- 对于无噪声梯度下降和嘈杂随机梯度下降,动量法都是可取的。
- 动量法可以防止在随机梯度下降的优化过程停滞的问题。
- 由于对过去的数据进行了指数降权,有效梯度数为 1 1 − β \frac{1}{1-\beta} 1−β1。
- 在凸二次问题中,可以对动量法进行明确而详细的分析。
- 动量法的实现非常简单,但它需要我们存储额外的状态向量(动量 v)。
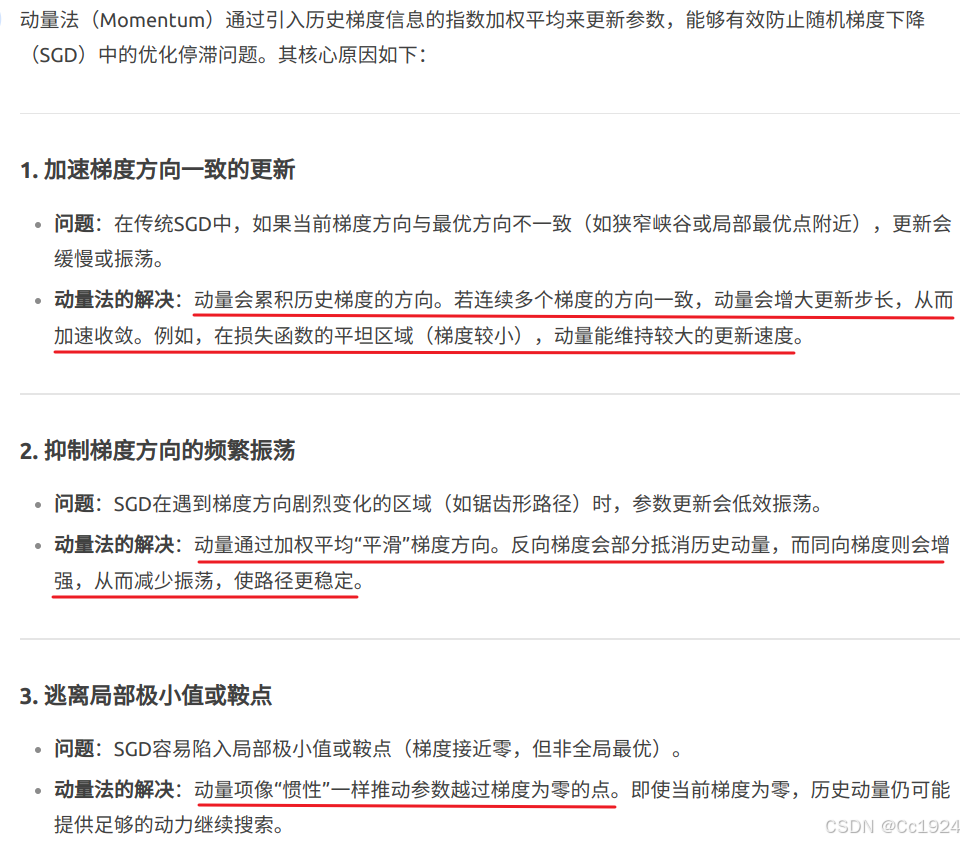
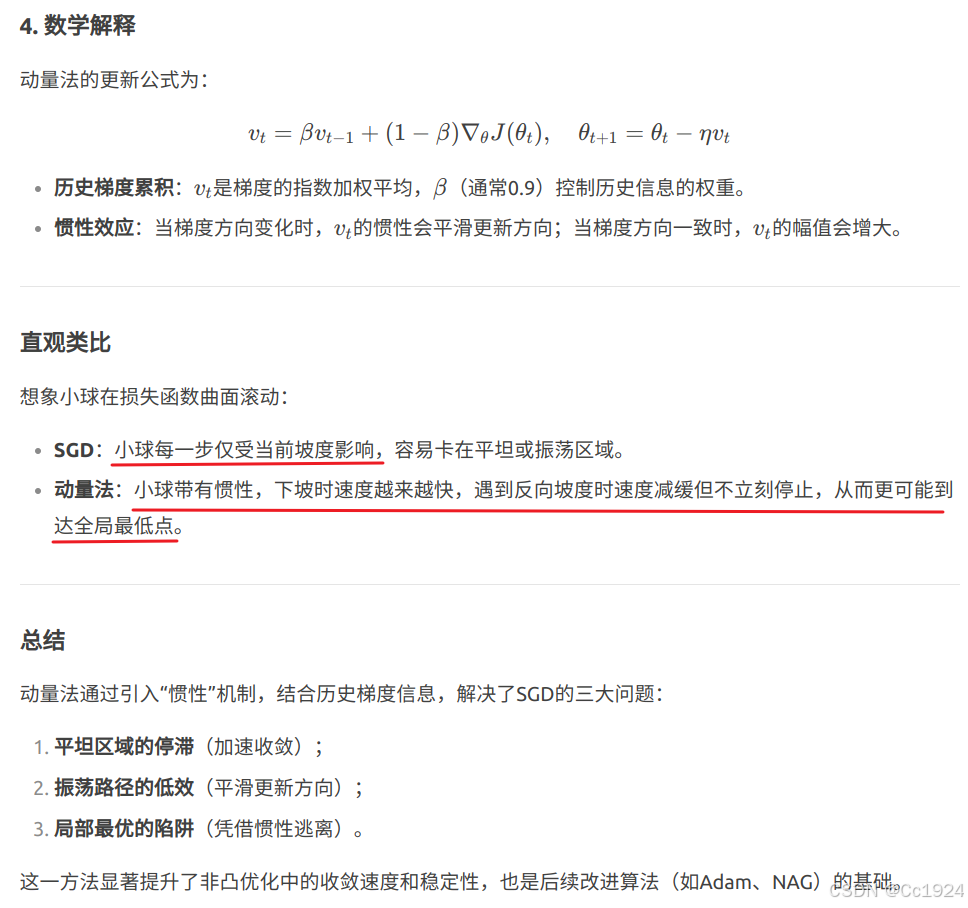
解释:动量法为什么可以防止在随机梯度下降的优化过程停滞的问题?
11.7. AdaGrad算法
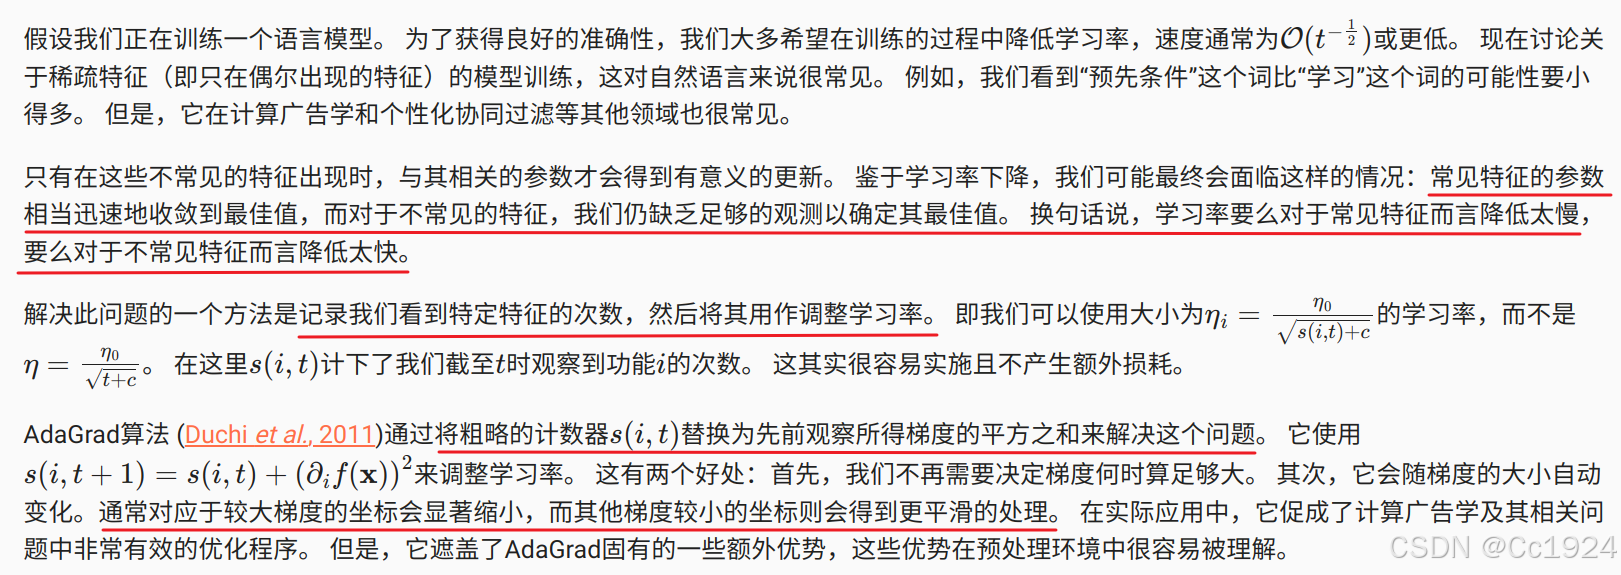
11.7.1. 稀疏特征和学习率
11.7.2. 预处理
都是理论推导,可以直接去看原文:https://zh.d2l.ai/chapter_optimization/adagrad.html
11.7.3. 算法
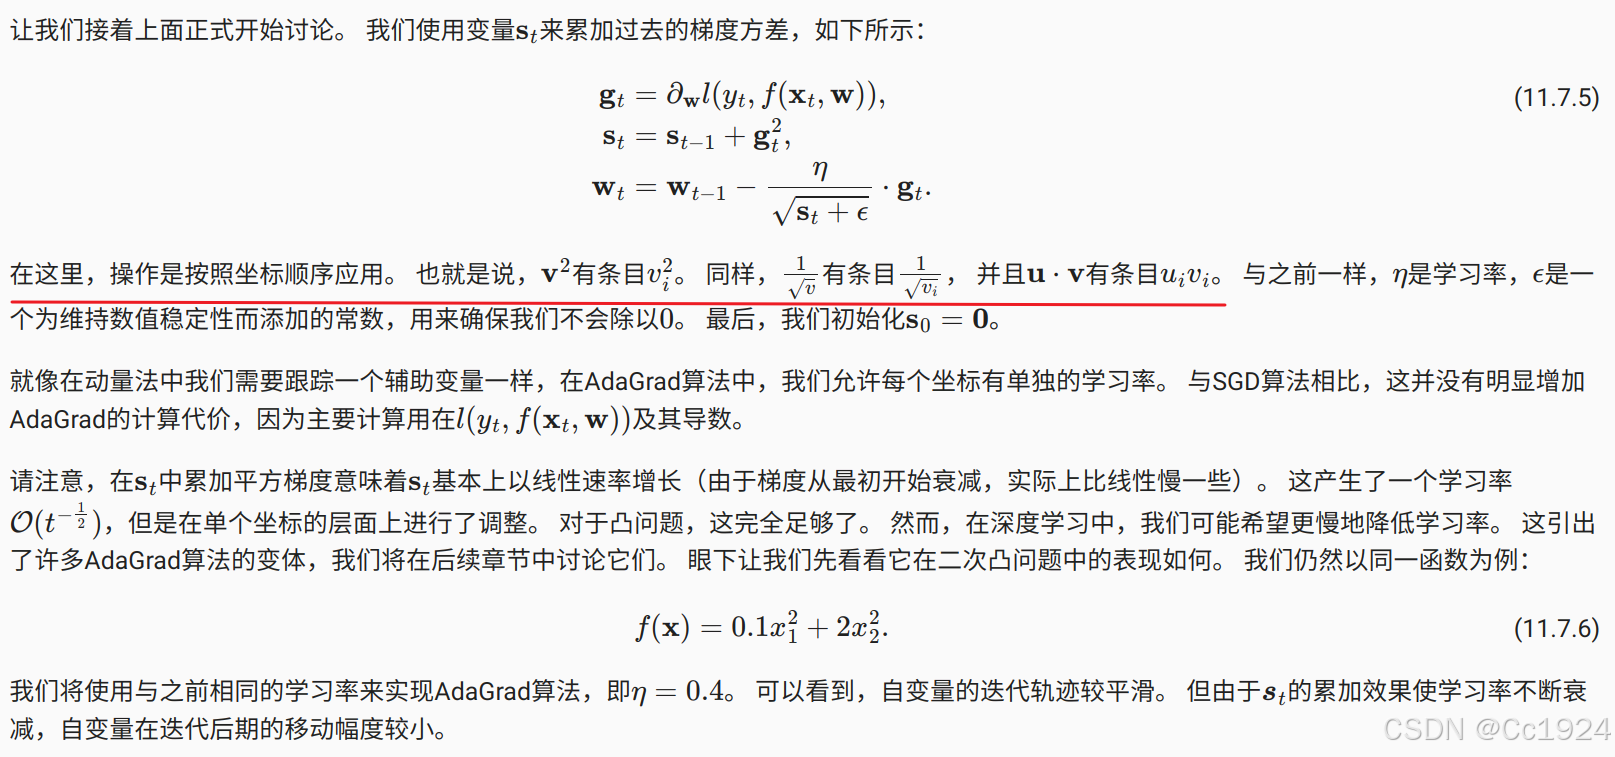
解释:这里的意思就是在计算梯度平方的时候,是逐元素计算的,而不是计算整个 tensor 的平方。然后计算 s_t 的时候也是逐个元素计算的。
%matplotlib inline
import math
import torch
from d2l import torch as d2l

def adagrad_2d(x1, x2, s1, s2):
    eps = 1e-6
    g1, g2 = 0.2 * x1, 4 * x2
    # 梯度平方是逐元素计算的
    s1 += g1 ** 2
    s2 += g2 ** 2
    x1 -= eta / math.sqrt(s1 + eps) * g1
    x2 -= eta / math.sqrt(s2 + eps) * g2
    return x1, x2, s1, s2

def f_2d(x1, x2):
    return 0.1 * x1 ** 2 + 2 * x2 ** 2

eta = 0.4
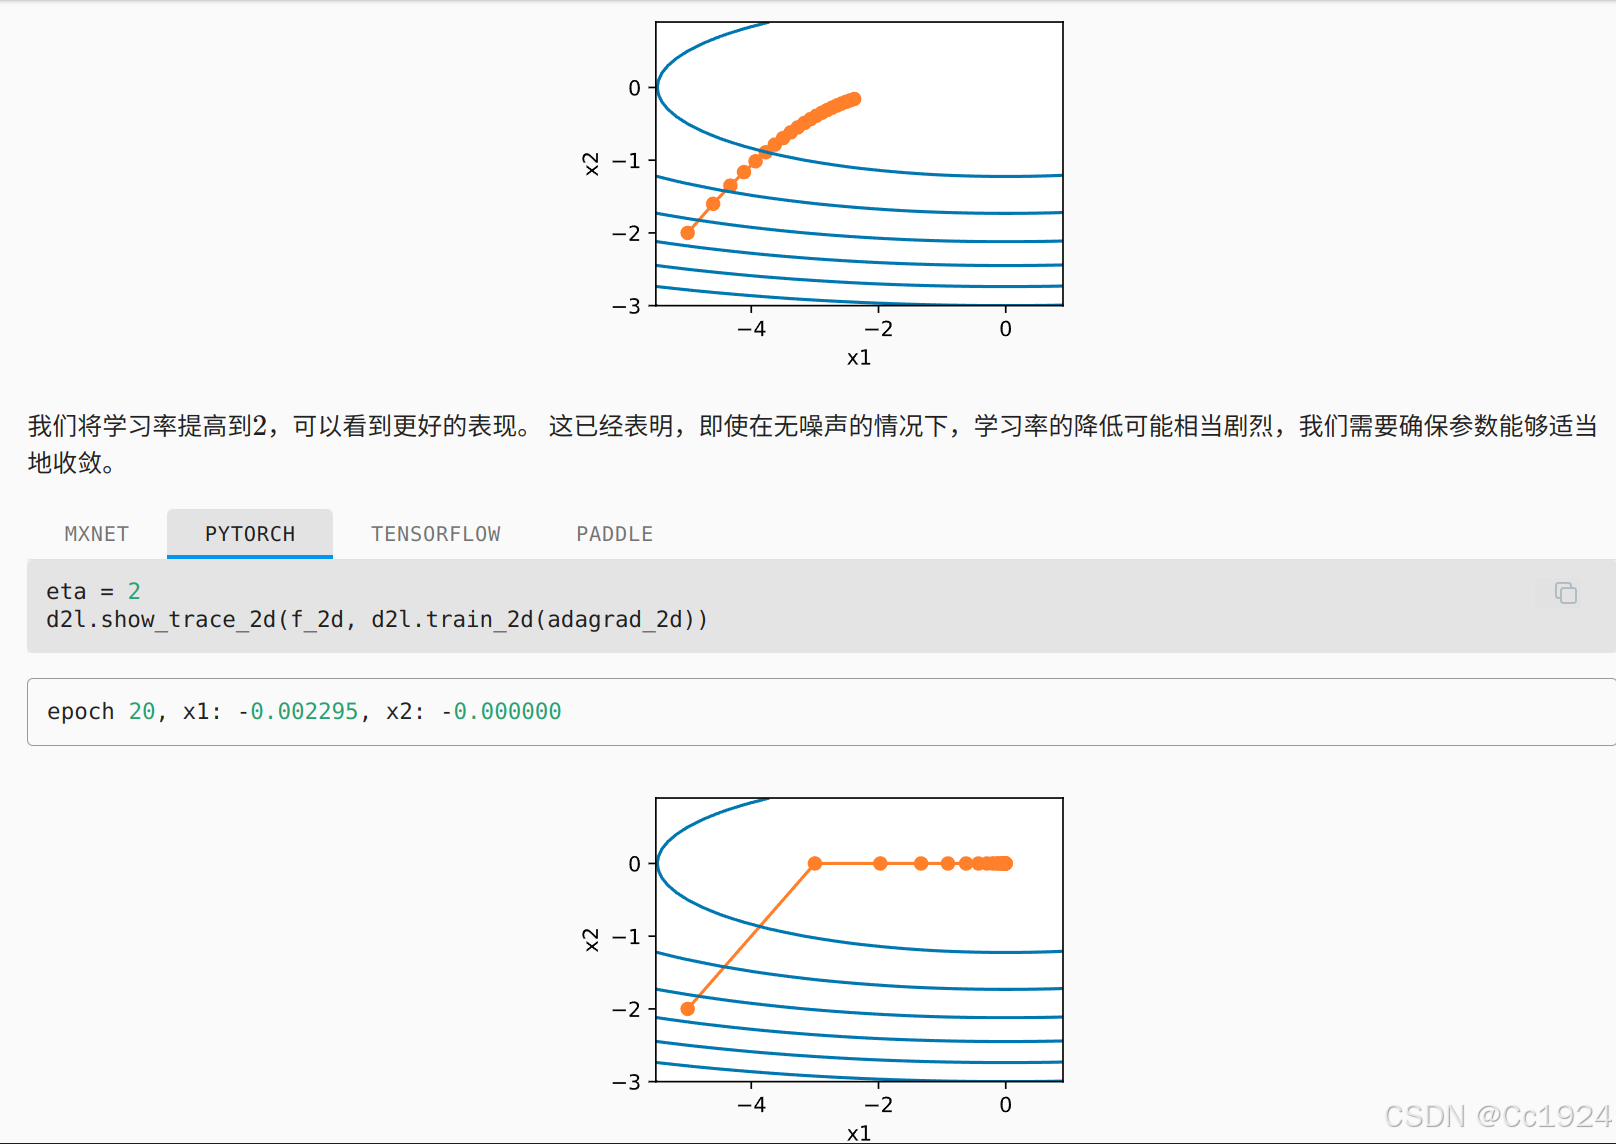
d2l.show_trace_2d(f_2d, d2l.train_2d(adagrad_2d))
11.7.4. 从零开始实现
同动量法一样,AdaGrad算法需要对每个自变量维护同它一样形状的状态变量。
def init_adagrad_states(feature_dim):
    s_w = torch.zeros((feature_dim, 1))
    s_b = torch.zeros(1)
    return (s_w, s_b)

def adagrad(params, states, hyperparams):
    eps = 1e-6
    for p, s in zip(params, states):
        with torch.no_grad():
        	# torch.square是逐元素计算的
            s[:] += torch.square(p.grad)
            p[:] -= hyperparams['lr'] * p.grad / torch.sqrt(s + eps)
        p.grad.data.zero_()
11.7.5. 简洁实现
我们可直接使用深度学习框架中提供的AdaGrad算法来训练模型。
trainer = torch.optim.Adagrad
d2l.train_concise_ch11(trainer, {'lr': 0.1}, data_iter)
11.7.6. 小结
- AdaGrad算法会在单个坐标层面动态降低学习率。
- AdaGrad算法利用梯度的大小作为调整进度速率的手段:用较小的学习率来补偿带有较大梯度的坐标。
- 在深度学习问题中,由于内存和计算限制,计算准确的二阶导数通常是不可行的。梯度可以作为一个有效的代理。
- 如果优化问题的结构相当不均匀,AdaGrad算法可以帮助缓解扭曲。(这里实际上还是第二条说的根据梯度大小来调整学习率,从而类似缩放了不同轴上的坐标)
- AdaGrad算法对于稀疏特征特别有效,在此情况下由于不常出现的问题,学习率需要更慢地降低。
- 在深度学习问题上,AdaGrad算法有时在降低学习率方面可能过于剧烈。我们将在 11.10节一节讨论缓解这种情况的策略。
11.8. RMSProp算法
11.8.1. 算法
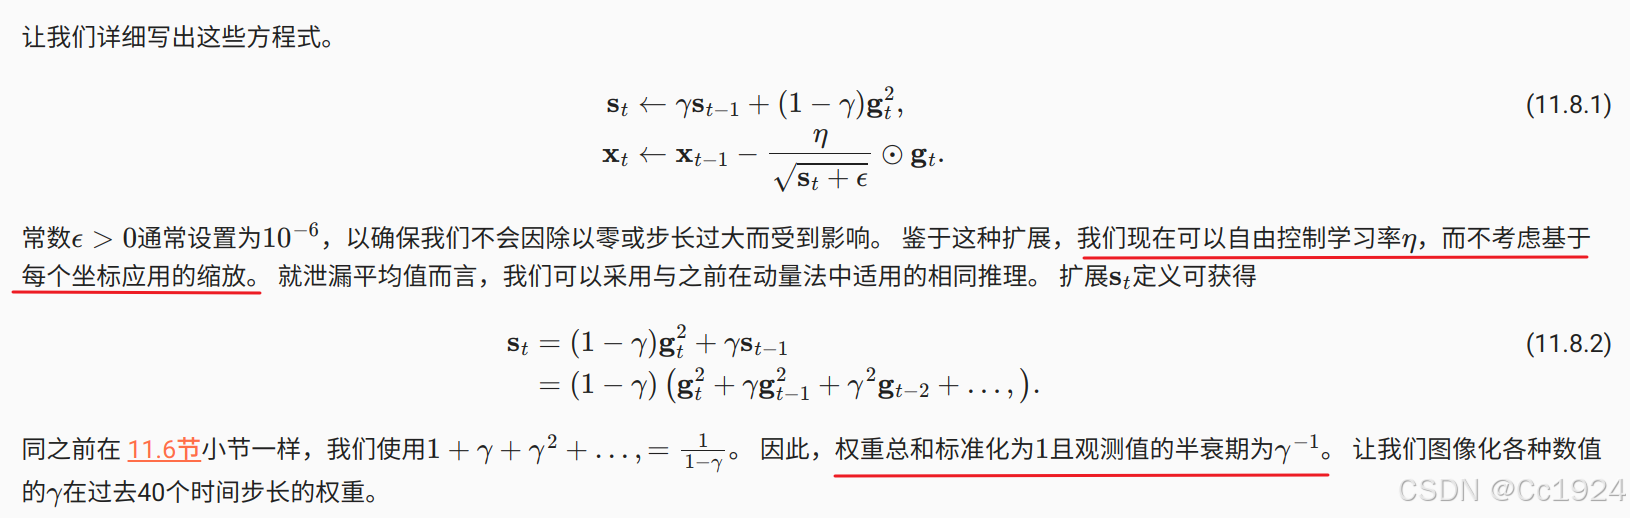
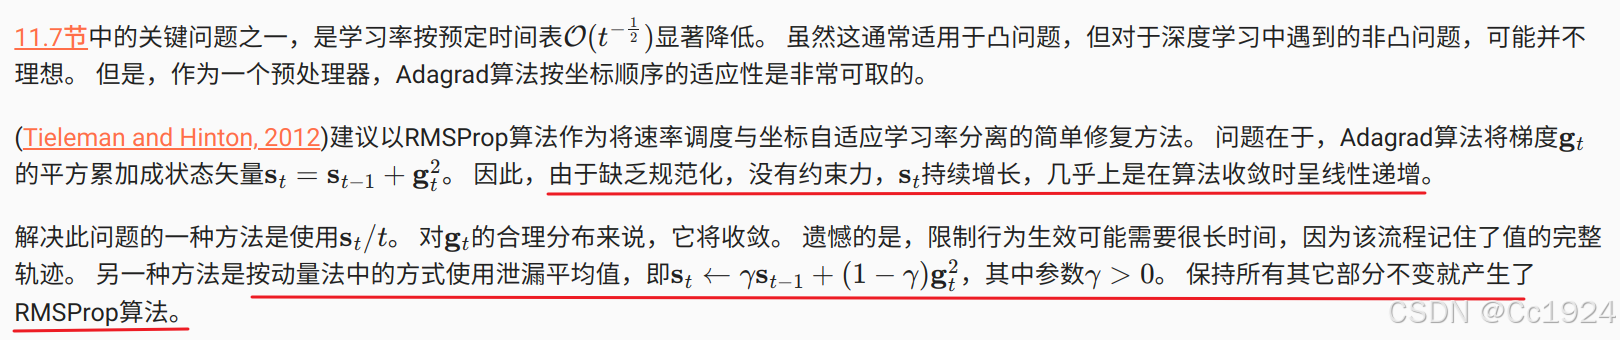
TODO:没太懂 可以自由控制学习率,而不考虑基于每个坐标应用的缩放 是什么意思?
11.8.2. 从零开始实现
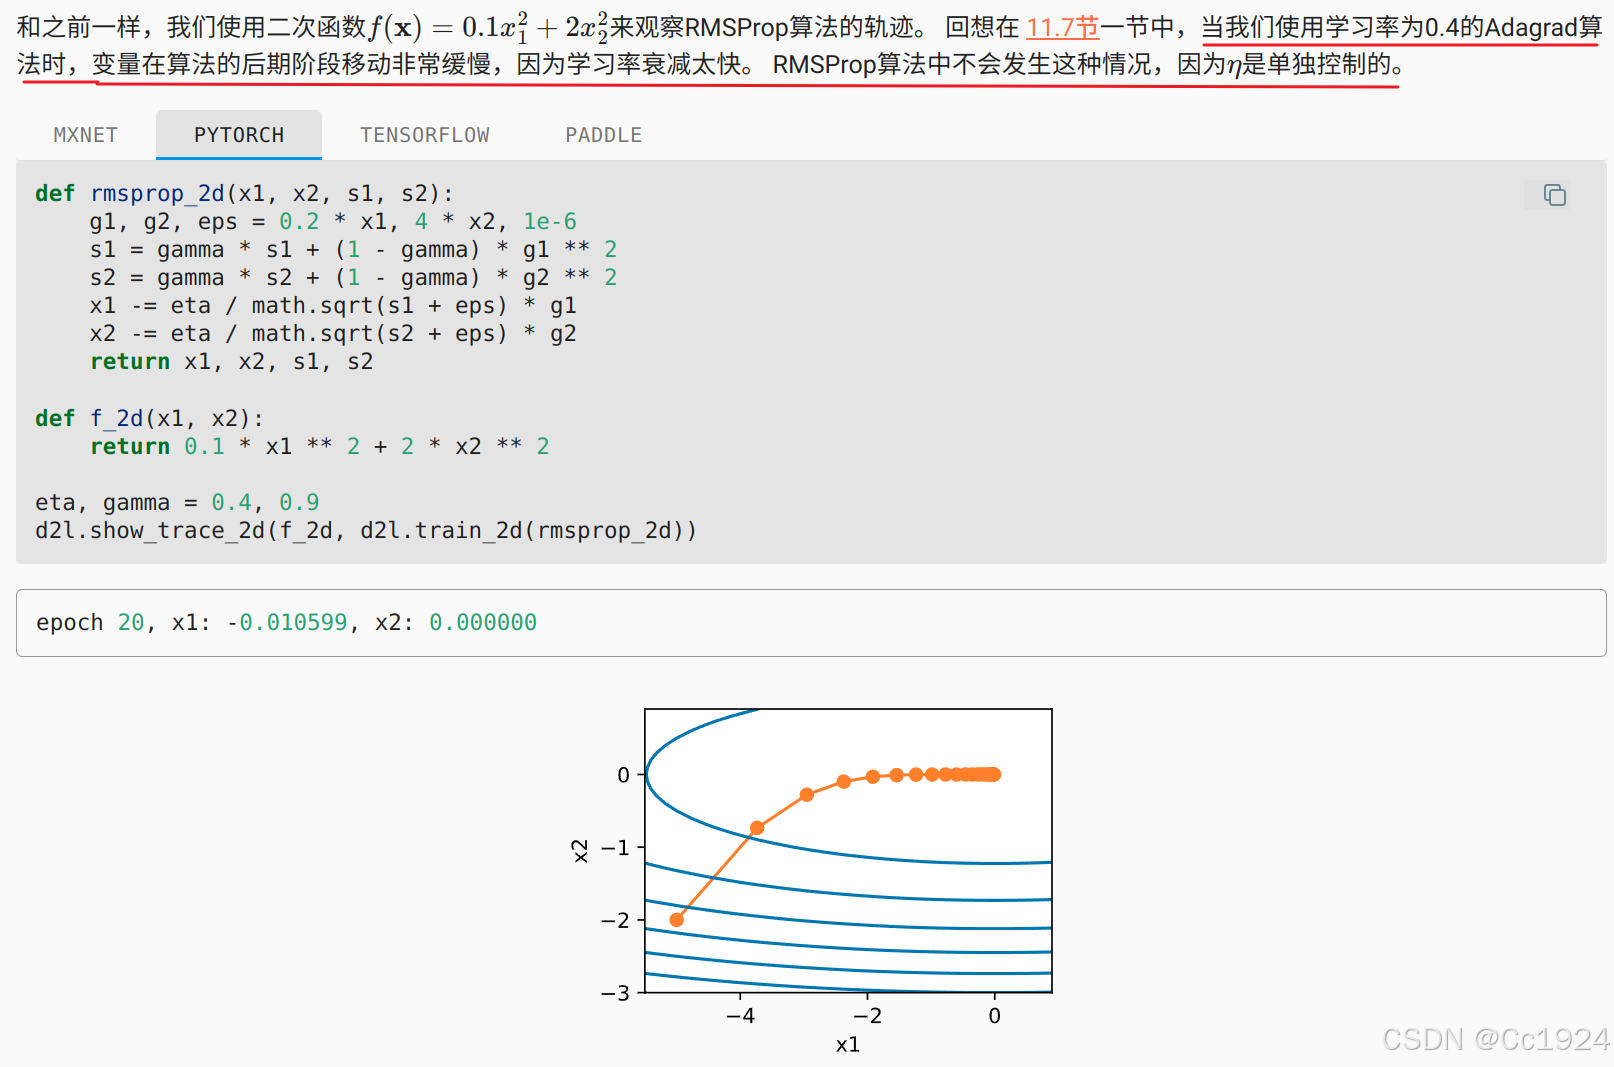
def init_rmsprop_states(feature_dim):
    s_w = torch.zeros((feature_dim, 1))
    s_b = torch.zeros(1)
    return (s_w, s_b)

def rmsprop(params, states, hyperparams):
    gamma, eps = hyperparams['gamma'], 1e-6
    for p, s in zip(params, states):
        with torch.no_grad():
            s[:] = gamma * s + (1 - gamma) * torch.square(p.grad)
            p[:] -= hyperparams['lr'] * p.grad / torch.sqrt(s + eps)
        p.grad.data.zero_()
11.8.3. 简洁实现
我们可直接使用深度学习框架中提供的RMSProp算法来训练模型。
trainer = torch.optim.RMSprop
# 这里的alpha应该就是上面公式中的gamma
d2l.train_concise_ch11(trainer, {'lr': 0.01, 'alpha': 0.9},
                       data_iter)
11.8.4. 小结
- RMSProp算法与Adagrad算法非常相似,因为两者都使用梯度的平方来缩放系数。
- RMSProp算法与动量法都使用泄漏平均值。但是,RMSProp算法使用该技术来调整按系数顺序的预处理器。
- 在实验中,学习率需要由实验者调度。
- 系数 γ \gamma γ 决定了在调整每坐标比例时历史记录的时长。
11.9. Adadelta
Adadelta是AdaGrad的另一种变体( 11.7节), 主要区别在于前者减少了学习率适应坐标的数量。 此外,广义上Adadelta被称为没有学习率,因为它使用变化量本身作为未来变化的校准。 Adadelta算法是在 (Zeiler, 2012)中提出的。
11.9.1. Adadelta算法
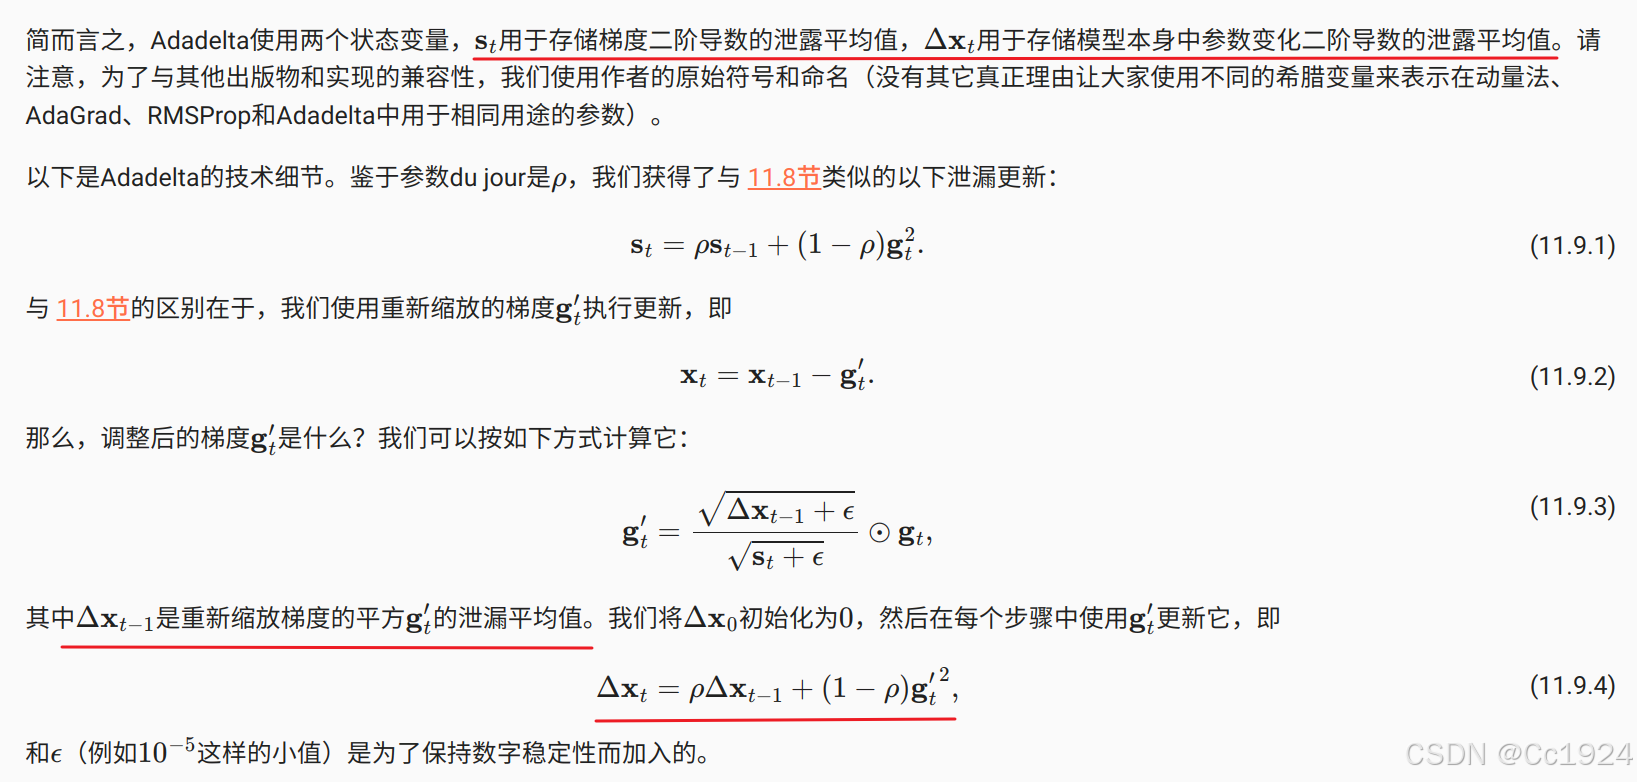
解释:相比 RMSProp,起始这里就是把学习率
η
\eta
η 换成了重新缩放之后的梯度
g
t
′
g'_t
gt′ 的加权平均值。
11.9.2. 代码实现
Adadelta需要为每个变量维护两个状态变量,即 s t s_t st 和 Δ x t \Delta {x_t} Δxt。这将产生以下实现。
%matplotlib inline
import torch
from d2l import torch as d2l


def init_adadelta_states(feature_dim):
    s_w, s_b = torch.zeros((feature_dim, 1)), torch.zeros(1)
    delta_w, delta_b = torch.zeros((feature_dim, 1)), torch.zeros(1)
    return ((s_w, delta_w), (s_b, delta_b))

def adadelta(params, states, hyperparams):
    rho, eps = hyperparams['rho'], 1e-5
    for p, (s, delta) in zip(params, states):
        with torch.no_grad():
            # In-placeupdatesvia[:]
            s[:] = rho * s + (1 - rho) * torch.square(p.grad)
            # 注意缩放的g'的计算使用的是上一时刻的delta
            g = (torch.sqrt(delta + eps) / torch.sqrt(s + eps)) * p.grad
            p[:] -= g
            # 更新当前时刻的delta
            delta[:] = rho * delta + (1 - rho) * g * g
        p.grad.data.zero_()
对于每次参数更新,选择
相当于10个半衰期。由此我们得到:
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
#注意参数中没有学习率lr了
d2l.train_ch11(adadelta, init_adadelta_states(feature_dim),
               {'rho': 0.9}, data_iter, feature_dim);
为了简洁实现,我们只需使用高级API中的Adadelta算法。
trainer = torch.optim.Adadelta
d2l.train_concise_ch11(trainer, {'rho': 0.9}, data_iter)
11.9.3. 小结
- Adadelta没有学习率参数。相反,它使用参数本身的变化率来调整学习率。
- Adadelta需要两个状态变量来存储梯度的二阶导数和参数的变化。
- Adadelta使用泄漏的平均值来保持对适当统计数据的运行估计。
11.10. Adam算法
本章我们已经学习了许多有效优化的技术。 在本节讨论之前,我们先详细回顾一下这些技术:
- 在 11.4节中,我们学习了:随机梯度下降在解决优化问题时比梯度下降更有效。
- 在 11.5节中,我们学习了:在一个小批量中使用更大的观测值集,可以通过向量化提供额外效率。这是高效的多机、多GPU和整体并行处理的关键。
- 在 11.6节中我们添加了一种机制,用于汇总过去梯度的历史以加速收敛。
- 在 11.7节中,我们通过对每个坐标缩放来实现高效计算的预处理器。
- 在 11.8节中,我们通过学习率的调整来分离每个坐标的缩放。
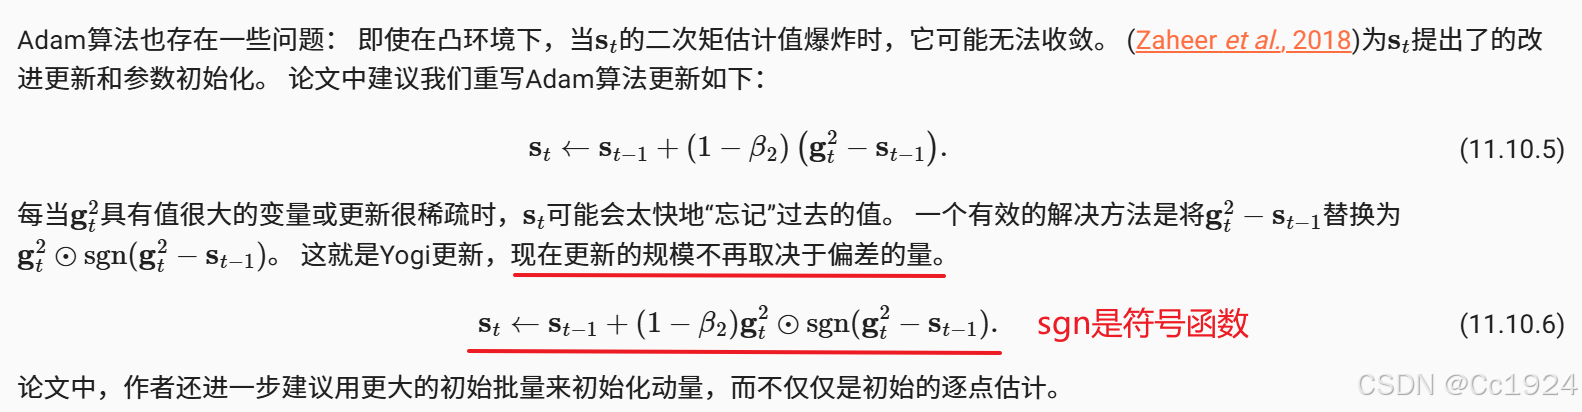
Adam算法 (Kingma and Ba, 2014)将所有这些技术汇总到一个高效的学习算法中。 不出预料,作为深度学习中使用的更强大和有效的优化算法之一,它非常受欢迎。 但是它并非没有问题,尤其是 (Reddi et al., 2019)表明,有时Adam算法可能由于方差控制不良而发散。 在完善工作中, (Zaheer et al., 2018)给Adam算法提供了一个称为Yogi的热补丁来解决这些问题。 下面我们了解一下Adam算法。
11.10.1. 算法
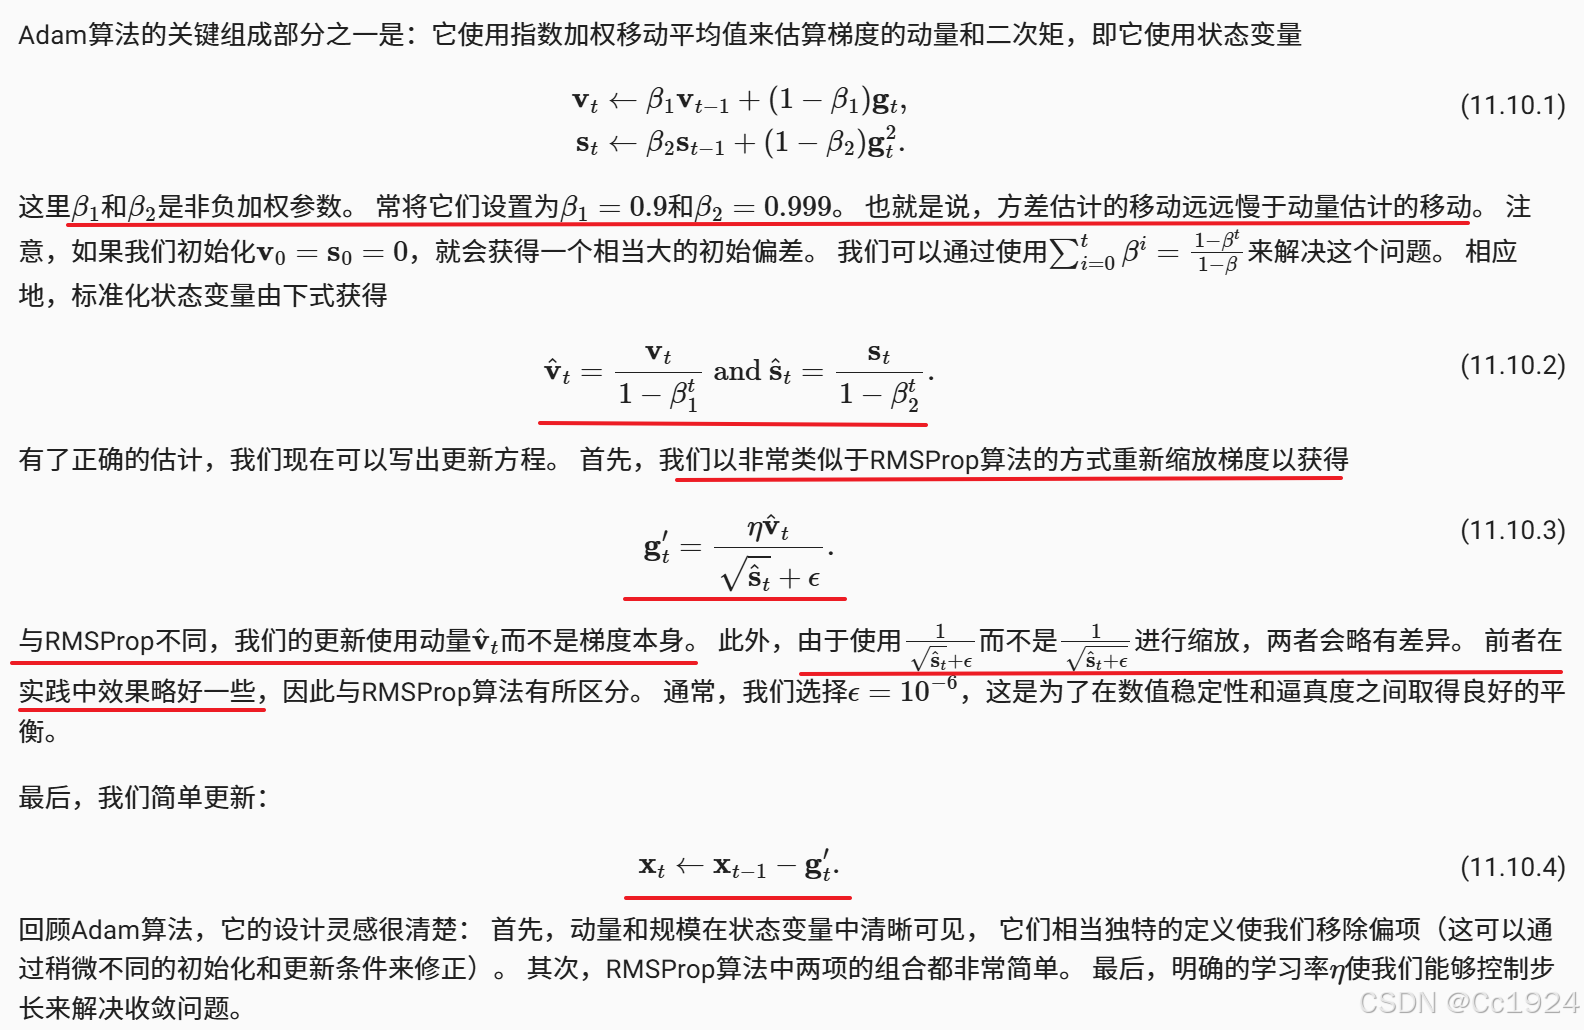
TODO:没太明白公式 (11.10.2) 是在干什么,为什么要这样计算?
11.10.2. 实现
从头开始实现Adam算法并不难。 为方便起见,我们将时间步 t 存储在hyperparams字典中。 除此之外,一切都很简单。
%matplotlib inline
import torch
from d2l import torch as d2l


def init_adam_states(feature_dim):
    v_w, v_b = torch.zeros((feature_dim, 1)), torch.zeros(1)
    s_w, s_b = torch.zeros((feature_dim, 1)), torch.zeros(1)
    return ((v_w, s_w), (v_b, s_b))

def adam(params, states, hyperparams):
    beta1, beta2, eps = 0.9, 0.999, 1e-6
    for p, (v, s) in zip(params, states):
        with torch.no_grad():
            v[:] = beta1 * v + (1 - beta1) * p.grad
            s[:] = beta2 * s + (1 - beta2) * torch.square(p.grad)
            # 公式 (11.10.2)
            v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
            s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
            p[:] -= hyperparams['lr'] * v_bias_corr / (torch.sqrt(s_bias_corr)
                                                       + eps)
        p.grad.data.zero_()
    # 每迭代一次,时间步t就+1
    hyperparams['t'] += 1
现在,我们用以上Adam算法来训练模型,这里我们使用
的学习率。
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(adam, init_adam_states(feature_dim),
               {'lr': 0.01, 't': 1}, data_iter, feature_dim);
此外,我们可以用深度学习框架自带算法应用Adam算法,这里我们只需要传递配置参数。
trainer = torch.optim.Adam
d2l.train_concise_ch11(trainer, {'lr': 0.01}, data_iter)
11.10.3. Yogi
def yogi(params, states, hyperparams):
    beta1, beta2, eps = 0.9, 0.999, 1e-3
    for p, (v, s) in zip(params, states):
        with torch.no_grad():
            v[:] = beta1 * v + (1 - beta1) * p.grad
            s[:] = s + (1 - beta2) * torch.sign(
                torch.square(p.grad) - s) * torch.square(p.grad)
            v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
            s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
            p[:] -= hyperparams['lr'] * v_bias_corr / (torch.sqrt(s_bias_corr)
                                                       + eps)
        p.grad.data.zero_()
    hyperparams['t'] += 1

data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(yogi, init_adam_states(feature_dim),
               {'lr': 0.01, 't': 1}, data_iter, feature_dim);
11.10.4. 小结
- Adam算法将许多优化算法的功能结合到了相当强大的更新规则中。
- Adam算法在RMSProp算法基础上创建的,还在小批量的随机梯度上使用EWMA( 指数加权移动平均法)。
- 在估计动量和二次矩时,Adam算法使用偏差校正来调整缓慢的启动速度。
- 对于具有显著差异的梯度,我们可能会遇到收敛性问题。我们可以通过使用更大的小批量或者切换到改进的估计值 s t s_t st 来修正它们。Yogi提供了这样的替代方案。
11.11. 学习率调度器
到目前为止,我们主要关注如何更新权重向量的优化算法,而不是它们的更新速率。 然而,调整学习率通常与实际算法同样重要,有如下几方面需要考虑:
- 首先,学习率的大小很重要。如果它太大,优化就会发散;如果它太小,训练就会需要过长时间,或者我们最终只能得到次优的结果。我们之前看到问题的条件数很重要(有关详细信息,请参见 11.6节)。直观地说,这是最不敏感与最敏感方向的变化量的比率。
- 其次,衰减速率同样很重要。如果学习率持续过高,我们可能最终会在最小值附近弹跳,从而无法达到最优解。 11.5节比较详细地讨论了这一点,在 11.4节中我们则分析了性能保证。简而言之,我们希望速率衰减,但要比 O ( t − 1 2 ) O(t^{-\frac{1}{2}}) O(t−21) 慢,这样能成为解决凸问题的不错选择。
- 另一个同样重要的方面是初始化。这既涉及参数最初的设置方式(详情请参阅 4.8节),又关系到它们最初的演变方式。这被戏称为预热(warmup),即我们最初开始向着解决方案迈进的速度有多快。一开始的大步可能没有好处,特别是因为最初的参数集是随机的。最初的更新方向可能也是毫无意义的。
- 最后,还有许多优化变体可以执行周期性学习率调整。这超出了本章的范围,我们建议读者阅读 (Izmailov et al., 2018)来了解个中细节。例如,如何通过对整个路径参数求平均值来获得更好的解。
鉴于管理学习率需要很多细节,因此大多数深度学习框架都有自动应对这个问题的工具。 在本章中,我们将梳理不同的调度策略对准确性的影响,并展示如何通过学习率调度器(learning rate scheduler)来有效管理。
11.11.1. 一个简单的问题
我们从一个简单的问题开始,这个问题可以轻松计算,但足以说明要义。 为此,我们选择了一个稍微现代化的LeNet版本(激活函数使用relu而不是sigmoid,汇聚层使用最大汇聚层而不是平均汇聚层),并应用于Fashion-MNIST数据集。 此外,我们混合网络以提高性能。 由于大多数代码都是标准的,我们只介绍基础知识,而不做进一步的详细讨论。如果需要,请参阅 6节进行复习。
%matplotlib inline
import math
import torch
from torch import nn
from torch.optim import lr_scheduler  # 导入学习率调度器
from d2l import torch as d2l


def net_fn():
    model = nn.Sequential(
        nn.Conv2d(1, 6, kernel_size=5, padding=2), nn.ReLU(),
        nn.MaxPool2d(kernel_size=2, stride=2),
        nn.Conv2d(6, 16, kernel_size=5), nn.ReLU(),
        nn.MaxPool2d(kernel_size=2, stride=2),
        nn.Flatten(),
        nn.Linear(16 * 5 * 5, 120), nn.ReLU(),
        nn.Linear(120, 84), nn.ReLU(),
        nn.Linear(84, 10))

    return model

loss = nn.CrossEntropyLoss()
device = d2l.try_gpu()

batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size=batch_size)

# 代码几乎与d2l.train_ch6定义在卷积神经网络一章LeNet一节中的相同
def train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
          scheduler=None):
    net.to(device)
    animator = d2l.Animator(xlabel='epoch', xlim=[0, num_epochs],
                            legend=['train loss', 'train acc', 'test acc'])

    for epoch in range(num_epochs):
        metric = d2l.Accumulator(3)  # train_loss,train_acc,num_examples
        for i, (X, y) in enumerate(train_iter):
            net.train()
            trainer.zero_grad()
            X, y = X.to(device), y.to(device)
            y_hat = net(X)
            l = loss(y_hat, y)
            l.backward()
            trainer.step()
            with torch.no_grad():
                metric.add(l * X.shape[0], d2l.accuracy(y_hat, y), X.shape[0])
            train_loss = metric[0] / metric[2]
            train_acc = metric[1] / metric[2]
            if (i + 1) % 50 == 0:
                animator.add(epoch + i / len(train_iter),
                             (train_loss, train_acc, None))

        test_acc = d2l.evaluate_accuracy_gpu(net, test_iter)
        animator.add(epoch+1, (None, None, test_acc))

        if scheduler:
            if scheduler.__module__ == lr_scheduler.__name__:
                # Using PyTorch In-Built scheduler
                scheduler.step()
            else:
                # Using custom defined scheduler
                for param_group in trainer.param_groups:
                	# 自定义的调度器,是一个函数
                    param_group['lr'] = scheduler(epoch)

    print(f'train loss {train_loss:.3f}, train acc {train_acc:.3f}, '
          f'test acc {test_acc:.3f}')
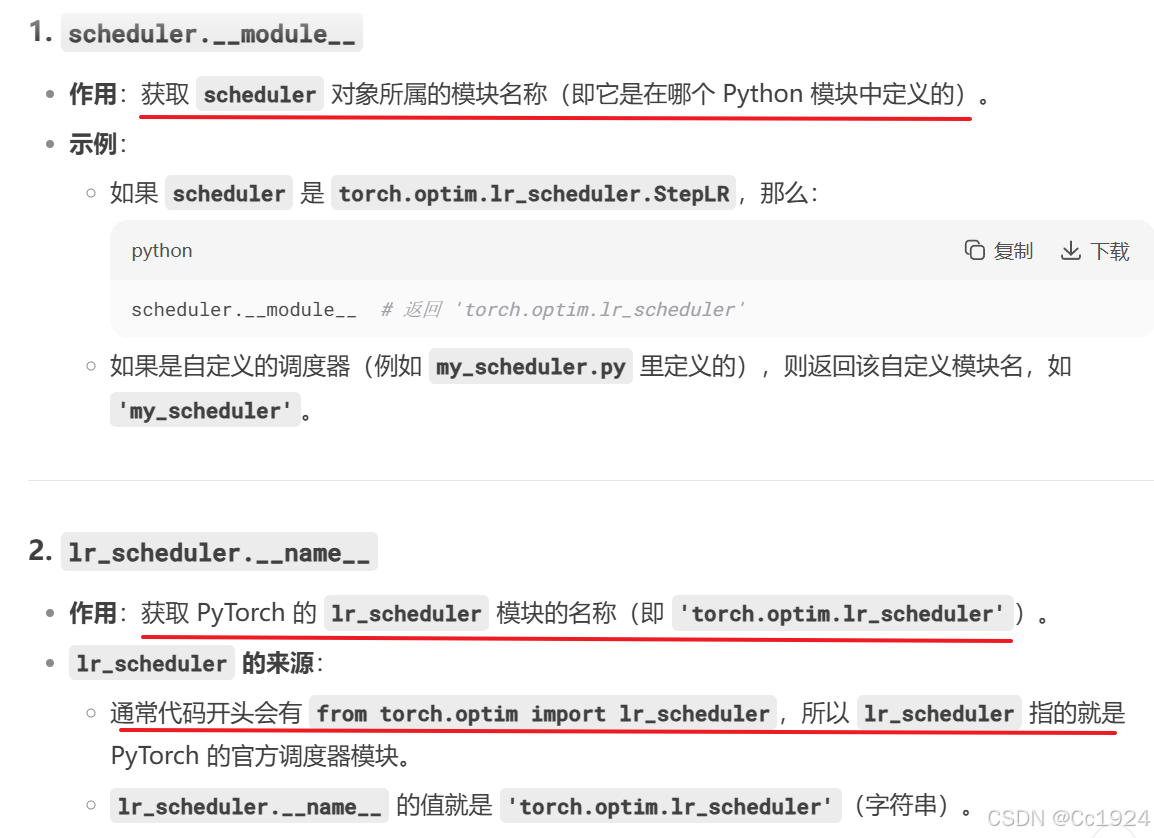
解释:if scheduler.__module__ == lr_scheduler.__name__: 这一行代码是用于判断当前使用的学习率调度器(scheduler)是否是 PyTorch 内置的调度器(来自 torch.optim.lr_scheduler 模块)。下面详细拆解它的含义:
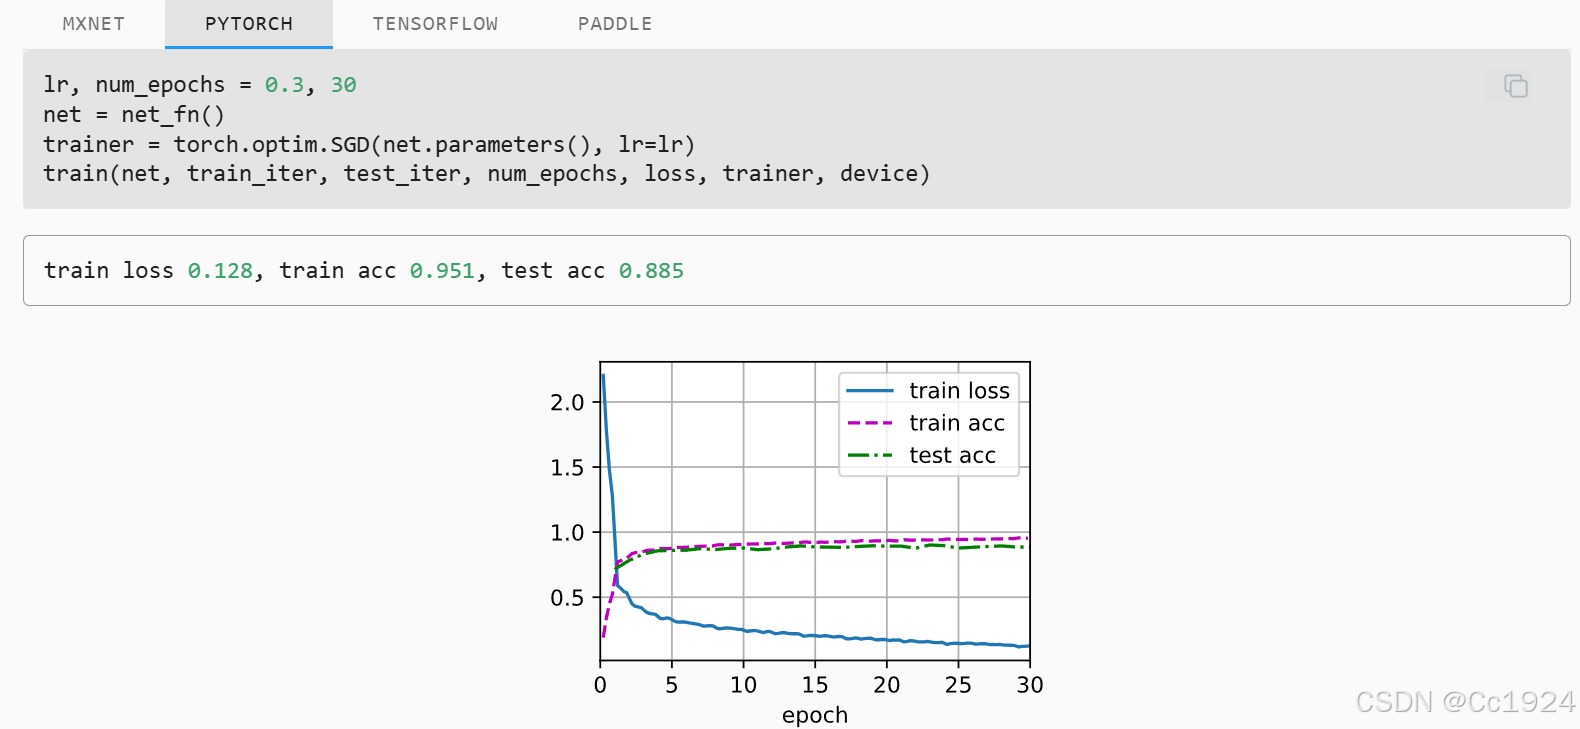
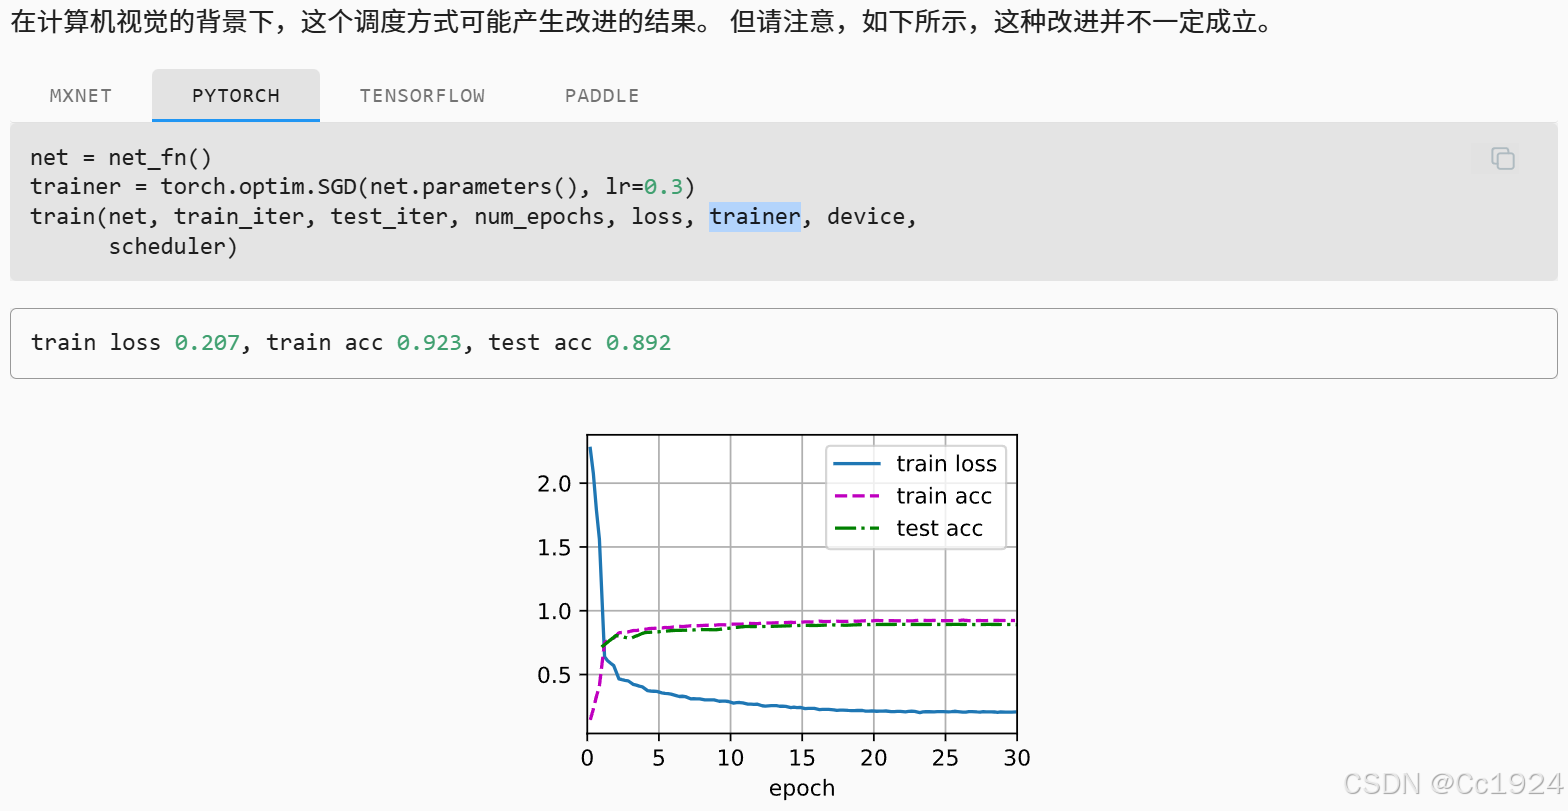
让我们来看看如果使用默认设置,调用此算法会发生什么。 例如设学习率为 0.3 并训练 30 次迭代。 留意在超过了某点、测试准确度方面的进展停滞时,训练准确度将如何继续提高。 两条曲线之间的间隙表示过拟合。
11.11.2. 学习率调度器
我们可以在每个迭代轮数(甚至在每个小批量)之后向下调整学习率。 例如,以动态的方式来响应优化的进展情况。
lr = 0.1
trainer.param_groups[0]["lr"] = lr
print(f'learning rate is now {trainer.param_groups[0]["lr"]:.2f}')
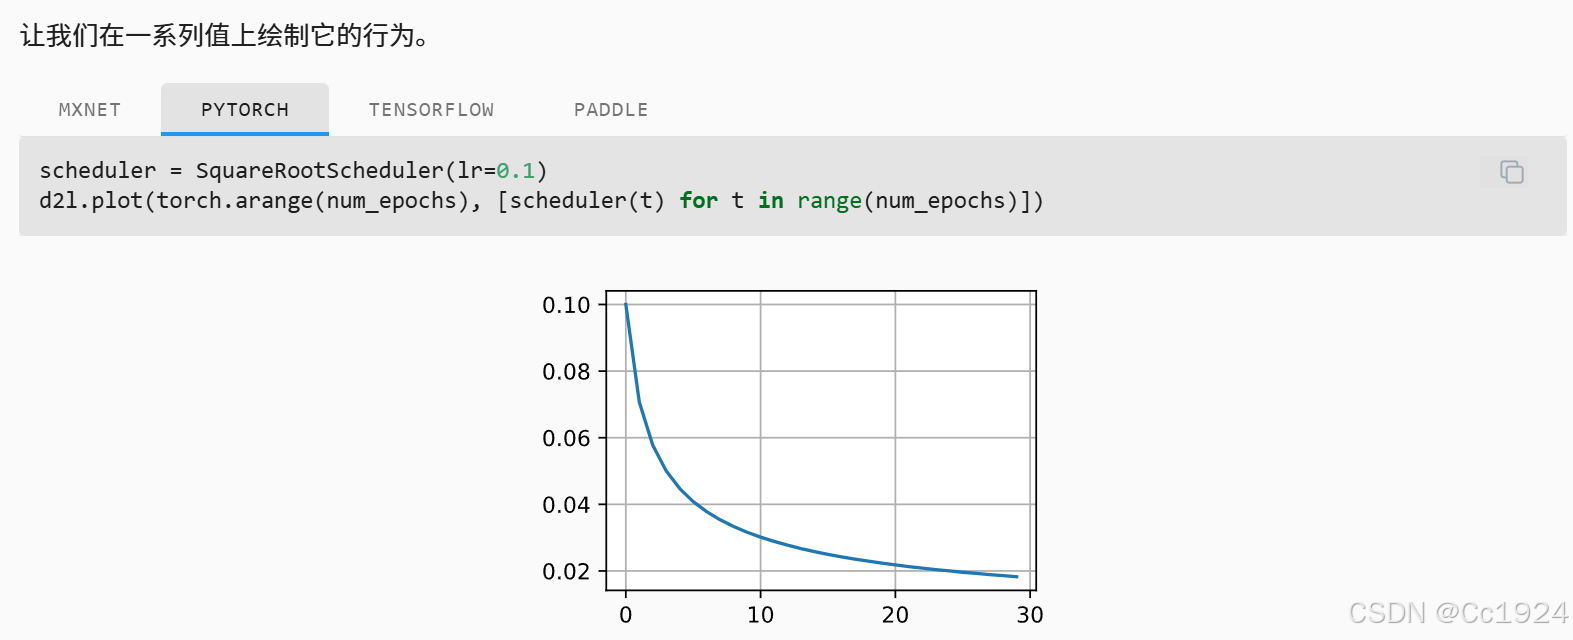
更通常而言,我们应该定义一个调度器。 当调用更新次数时,它将返回学习率的适当值。 让我们定义一个简单的方法,将学习率设置为 η = η 0 ( t + 1 ) − 1 2 \eta = \eta_0 (t+1)^{-\frac{1}{2}} η=η0(t+1)−21。
class SquareRootScheduler:
    def __init__(self, lr=0.1):
        self.lr = lr

    def __call__(self, num_update):
        return self.lr * pow(num_update + 1.0, -0.5)
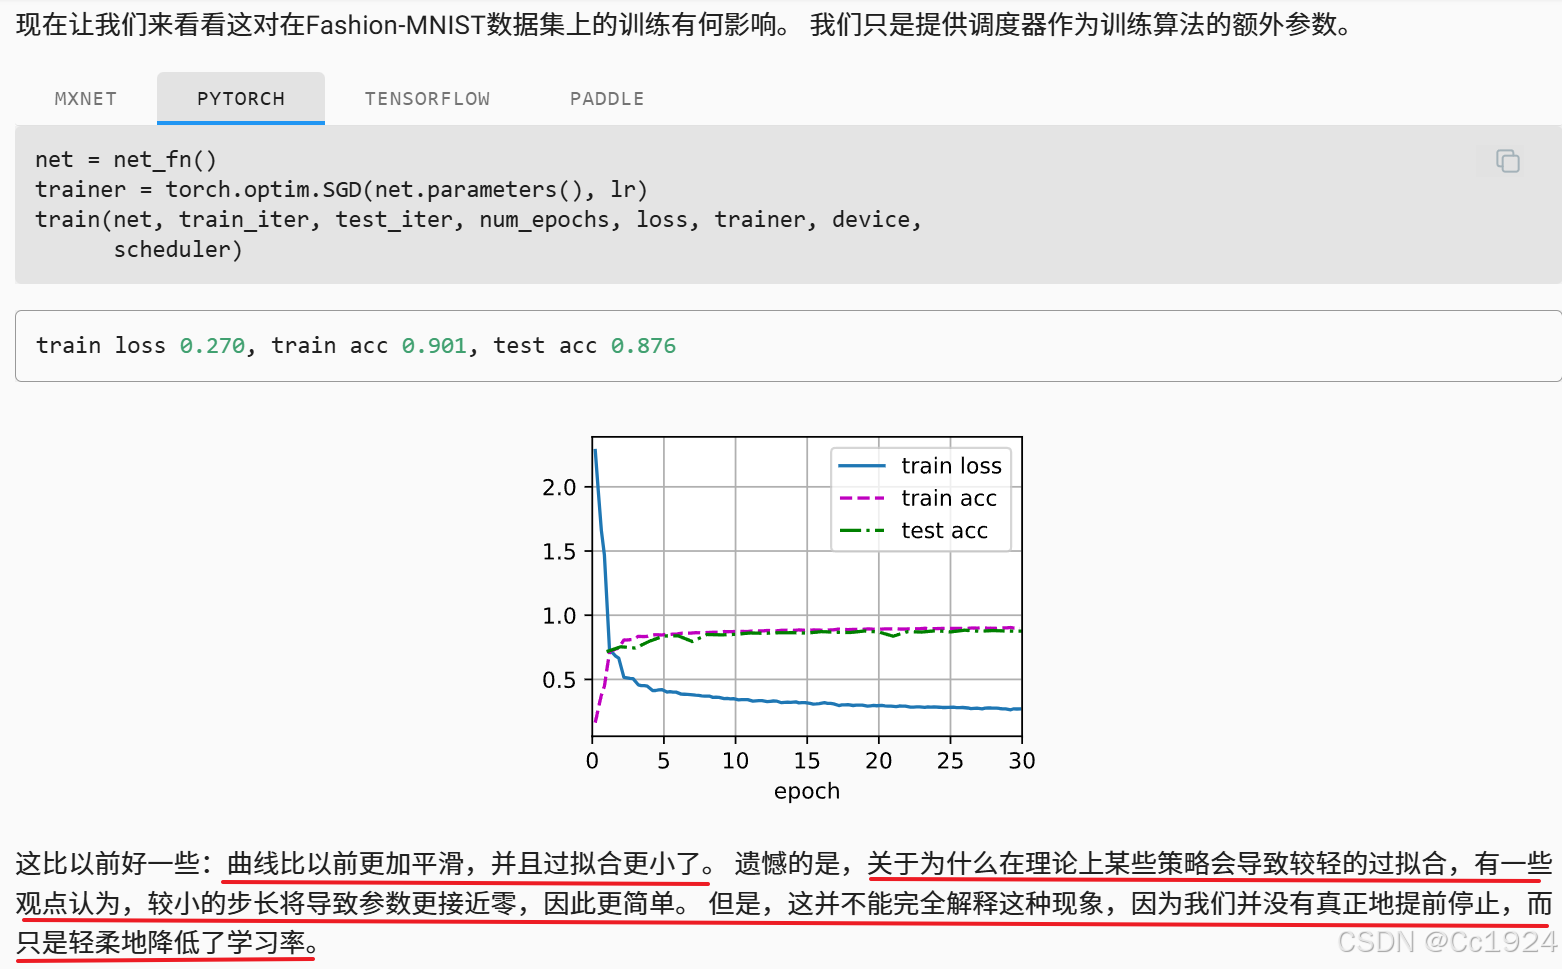
11.11.3. 策略
虽然我们不可能涵盖所有类型的学习率调度器,但我们会尝试在下面简要概述常用的策略:多项式衰减和分段常数表。 此外,余弦学习率调度在实践中的一些问题上运行效果很好。 在某些问题上,最好在使用较高的学习率之前预热优化器。
11.11.3.1. 单因子调度器
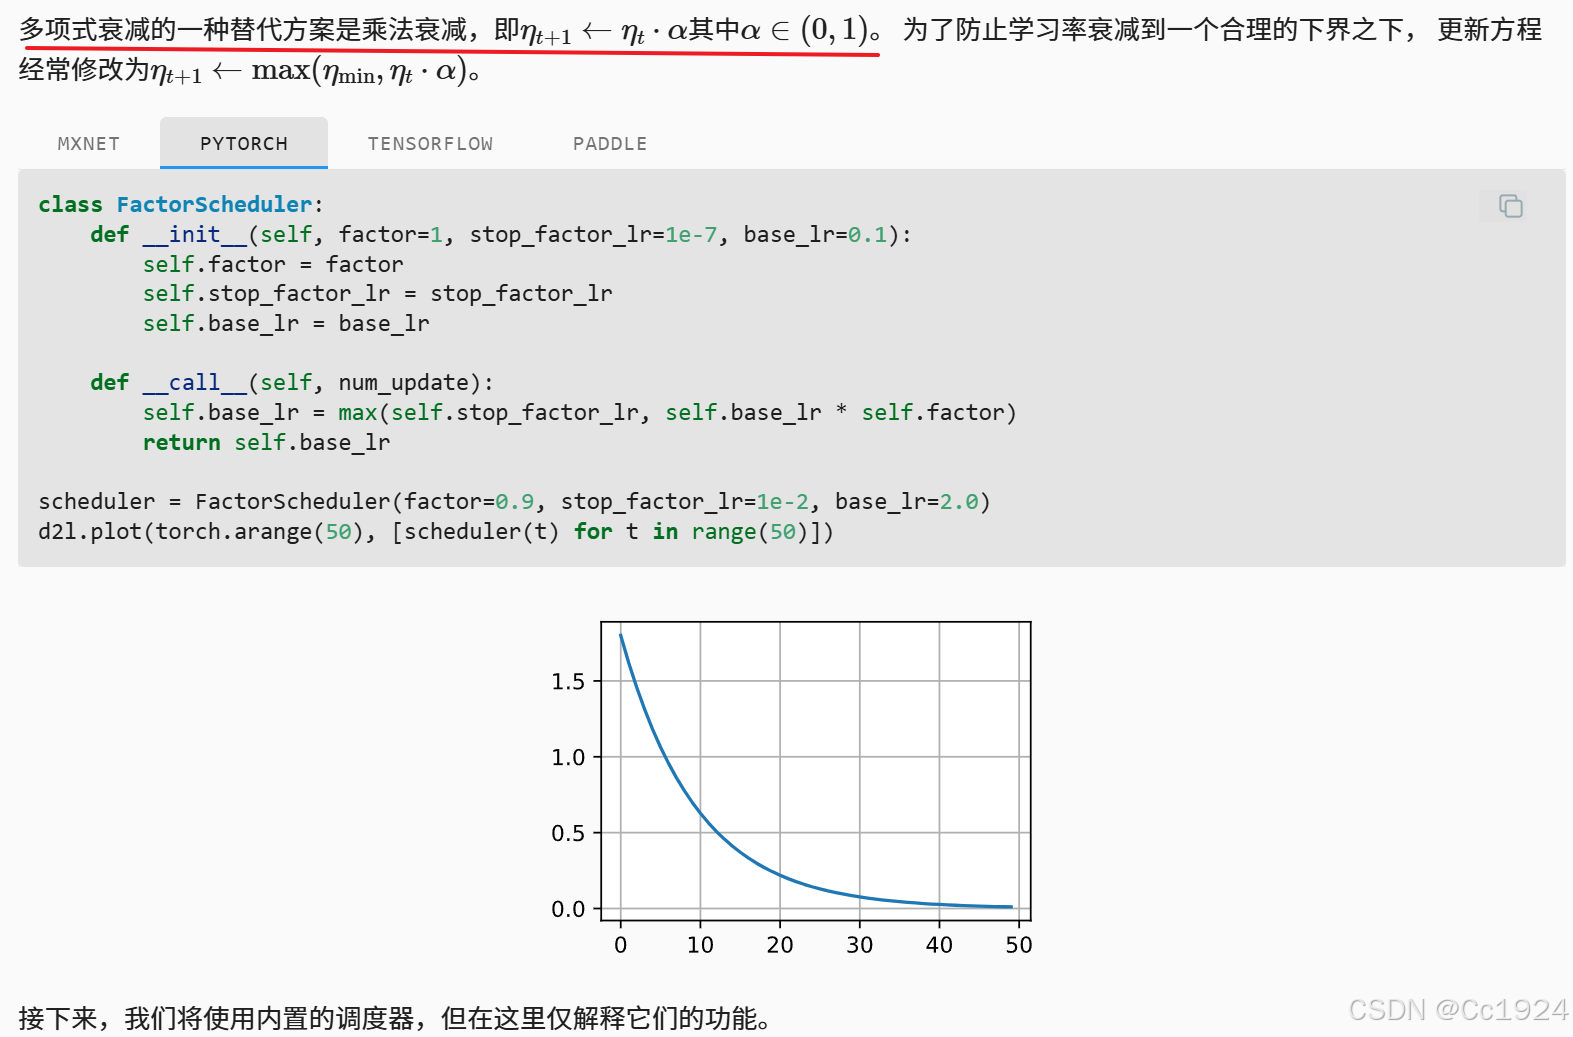
11.11.3.2. 多因子调度器
训练深度网络的常见策略之一是保持学习率为一组分段的常量,并且不时地按给定的参数对学习率做乘法衰减。 具体地说,给定一组降低学习率的时间点,例如 { 5 , 10 , 20 } \{5, 10, 20 \} {5,10,20}, 每当 t ∈ s t \in s t∈s 时,降低 η t + 1 ← η t α \eta_{t+1} \leftarrow \eta_t \alpha ηt+1←ηtα。 假设每步中的值减半,我们可以按如下方式实现这一点。
net = net_fn()
trainer = torch.optim.SGD(net.parameters(), lr=0.5)
# 分段学习率,这里的gamma就是上面公式中的alpha
scheduler = lr_scheduler.MultiStepLR(trainer, milestones=[15, 30], gamma=0.5)

def get_lr(trainer, scheduler):
	# 优化器可能有多个参数组,因此这里会返回所有组的学习率列表
    lr = scheduler.get_last_lr()[0]
    trainer.step()
    scheduler.step()
    return lr

d2l.plot(torch.arange(num_epochs), [get_lr(trainer, scheduler)
                                  for t in range(num_epochs)])
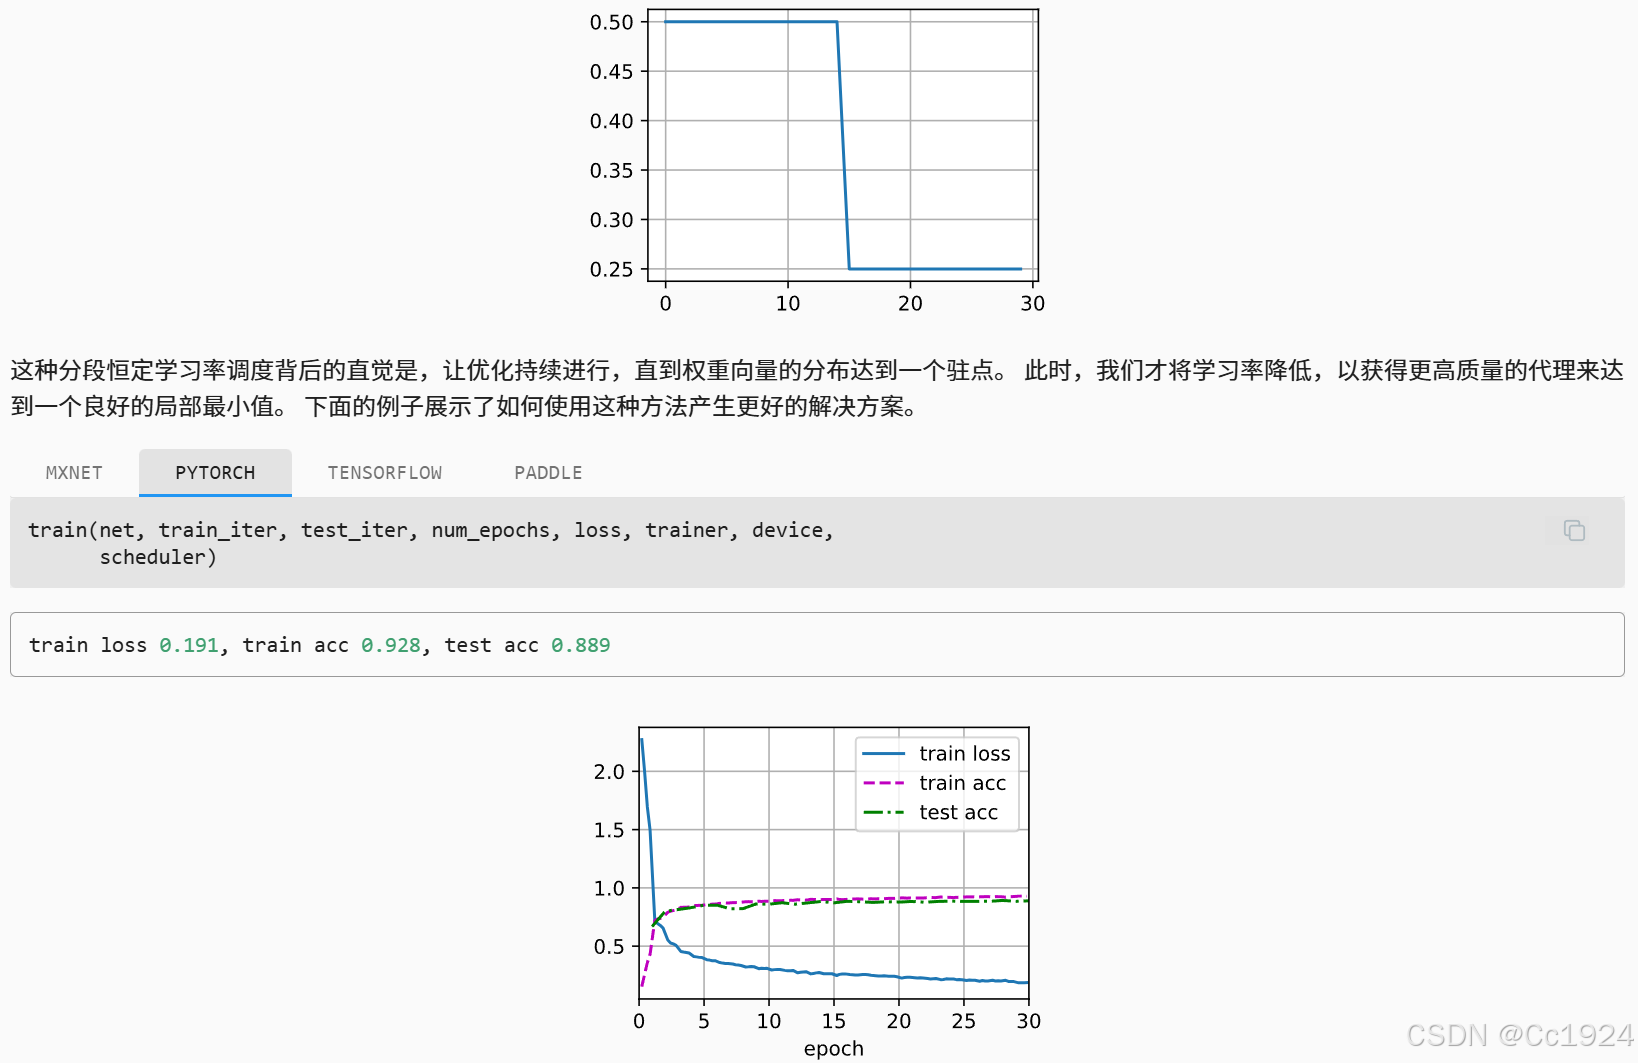
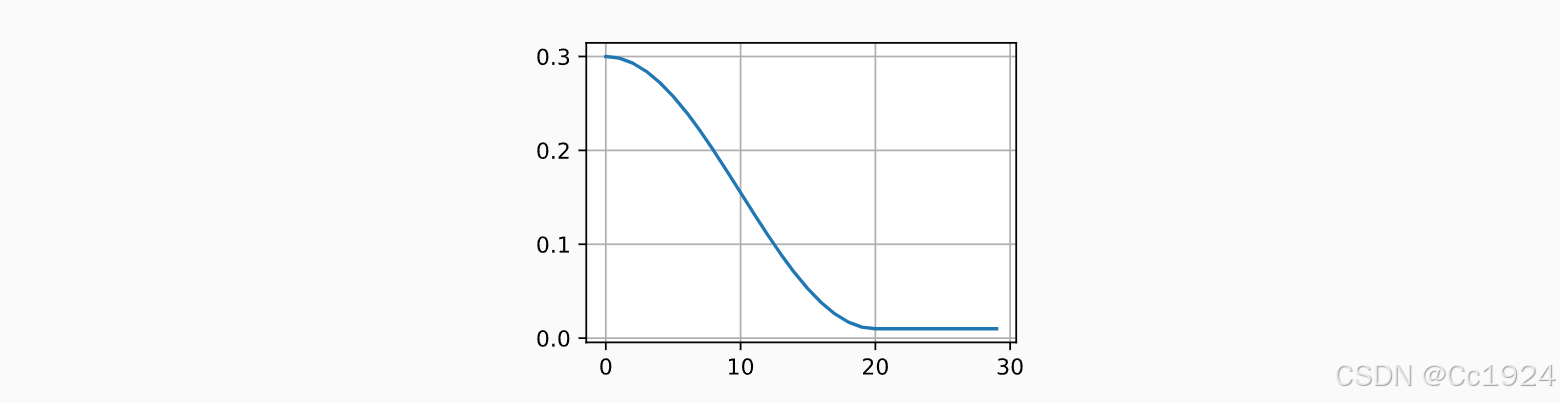
11.11.3.3. 余弦调度器
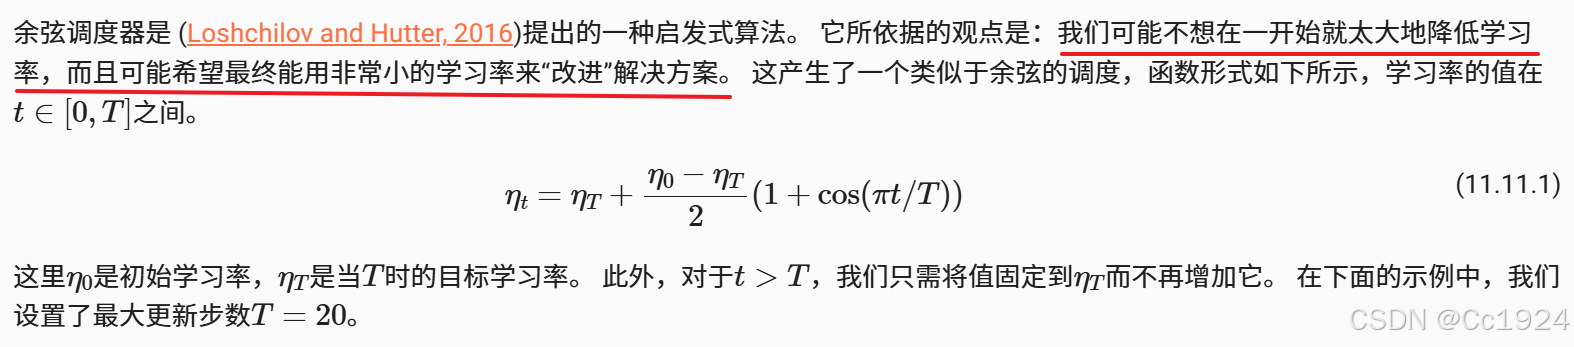
class CosineScheduler:
    def __init__(self, max_update, base_lr=0.01, final_lr=0,
               warmup_steps=0, warmup_begin_lr=0):
        self.base_lr_orig = base_lr  # 初始学习率, 公式中的\eta_0
        self.max_update = max_update  # 最大更新步数T
        self.final_lr = final_lr  # 最终的学习率 \eta_T
        self.warmup_steps = warmup_steps  # warmup的步数
        self.warmup_begin_lr = warmup_begin_lr  # warmup的初始学习率
        # 去掉warmup之后,cos调度的迭代步数
        self.max_steps = self.max_update - self.warmup_steps

    def get_warmup_lr(self, epoch):
    	# warmup阶段学习率是线性增长的,这里计算斜率*步数
        increase = (self.base_lr_orig - self.warmup_begin_lr) \
                       * float(epoch) / float(self.warmup_steps)
        # warmup的初始学习率 + 学习率的线性增量
        return self.warmup_begin_lr + increase

    def __call__(self, epoch):
        if epoch < self.warmup_steps:
            return self.get_warmup_lr(epoch)
        if epoch <= self.max_update:
        	# 就是按照上面的公式计算
            self.base_lr = self.final_lr + (
                self.base_lr_orig - self.final_lr) * (1 + math.cos(
                math.pi * (epoch - self.warmup_steps) / self.max_steps)) / 2
        # 如果 epoch > self.max_update,则将保持最后一次计算的值(也就是 \eta_T)
        return self.base_lr

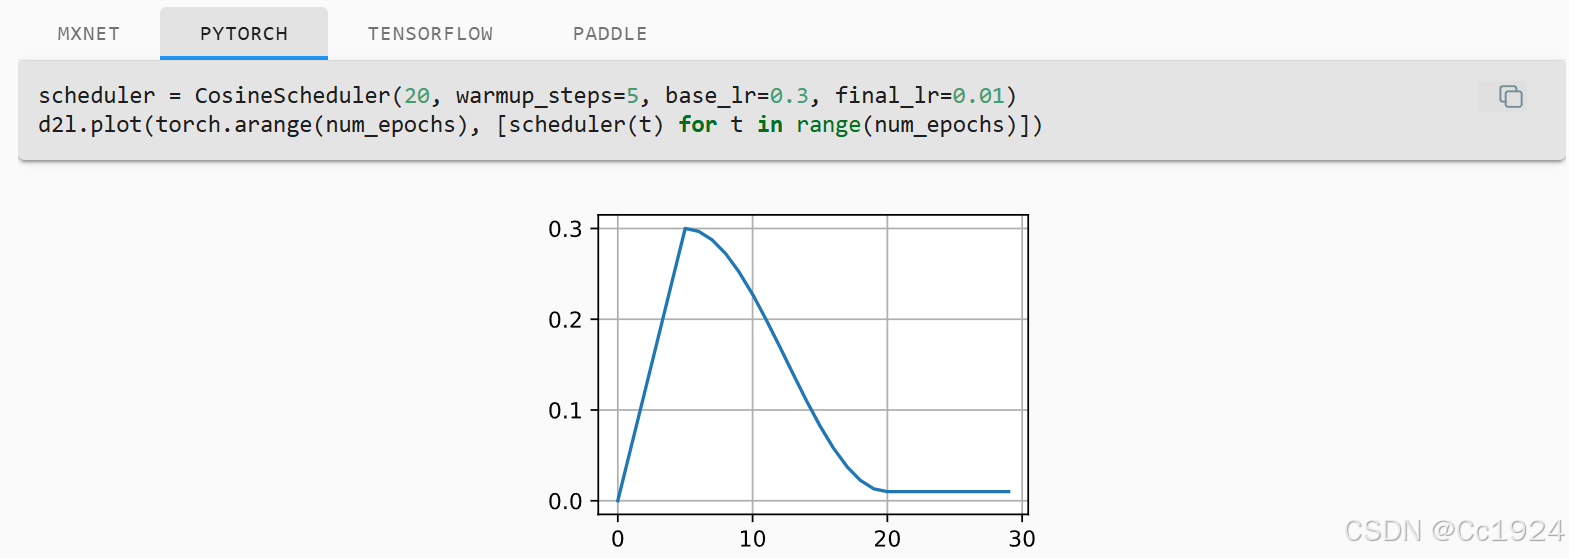
scheduler = CosineScheduler(max_update=20, base_lr=0.3, final_lr=0.01)
d2l.plot(torch.arange(num_epochs), [scheduler(t) for t in range(num_epochs)])
11.11.3.4. 预热
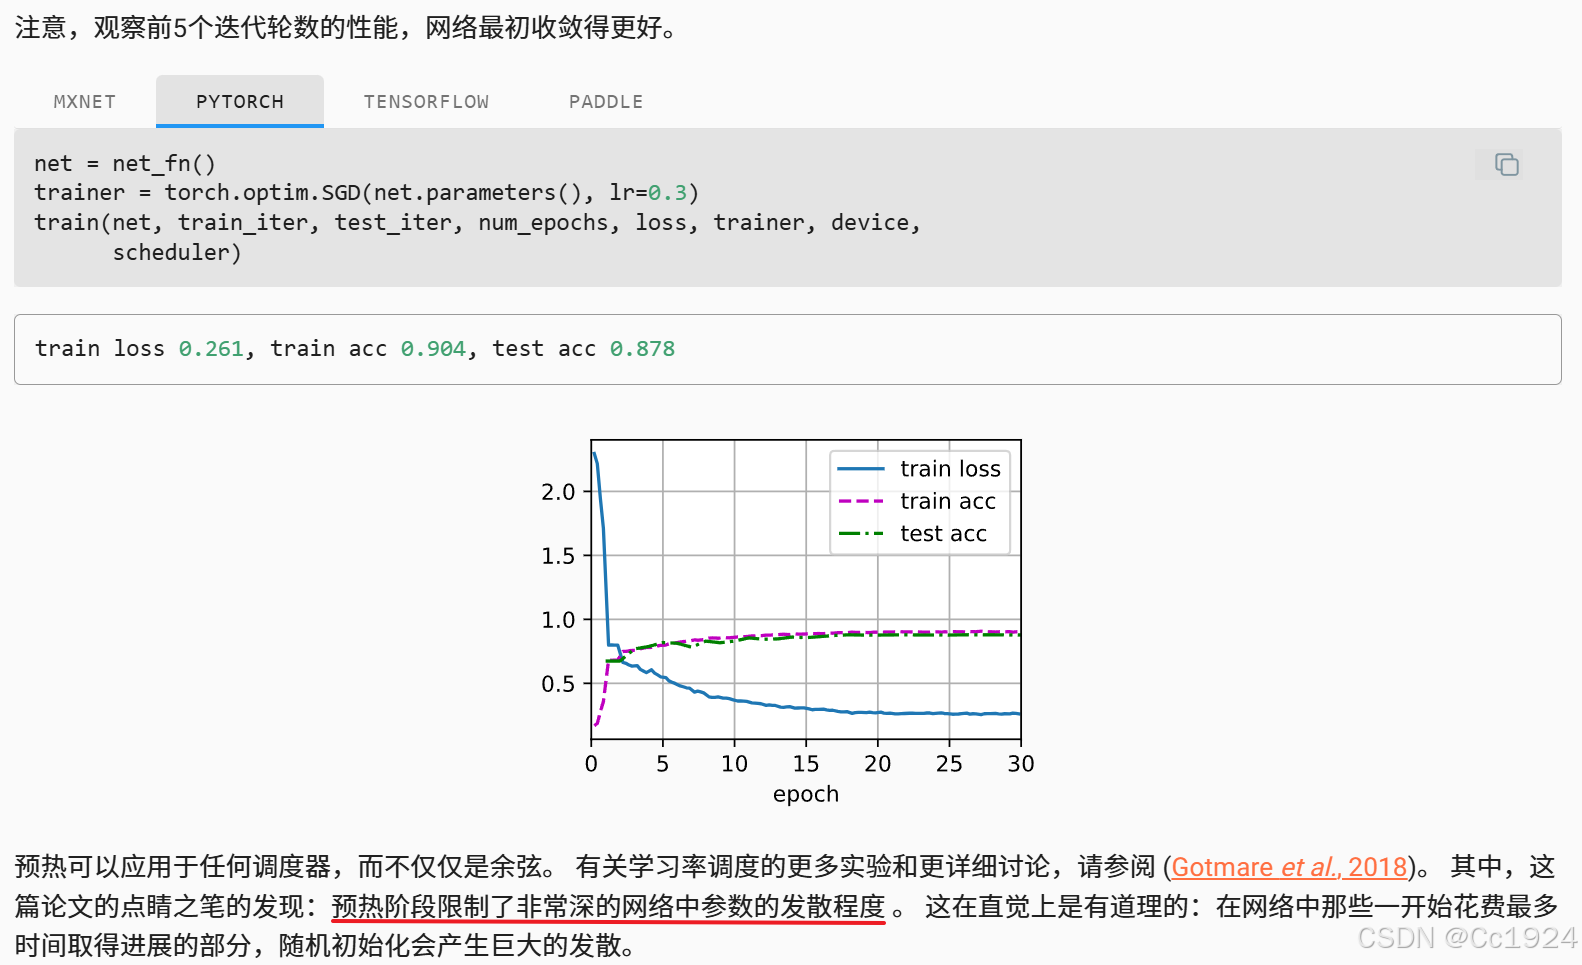
在某些情况下,初始化参数不足以得到良好的解。 这对某些高级网络设计来说尤其棘手,可能导致不稳定的优化结果。 对此,一方面,我们可以选择一个足够小的学习率, 从而防止一开始发散,然而这样进展太缓慢。 另一方面,较高的学习率最初就会导致发散。
解决这种困境的一个相当简单的解决方法是使用预热期,在此期间学习率将增加至初始最大值,然后冷却直到优化过程结束。 为了简单起见,通常使用线性递增。 这引出了如下表所示的时间表。
11.11.4. 小结
- 在训练期间逐步降低学习率可以提高准确性,并且减少模型的过拟合。
- 在实验中,每当进展趋于稳定时就降低学习率,这是很有效的。从本质上说,这可以确保我们有效地收敛到一个适当的解,也只有这样才能通过降低学习率来减小参数的固有方差。
- 余弦调度器在某些计算机视觉问题中很受欢迎。
- 优化之前的预热期可以防止发散。
- 优化在深度学习中有多种用途。对于同样的训练误差而言,选择不同的优化算法和学习率调度,除了最大限度地减少训练时间,可以导致测试集上不同的泛化和过拟合量。


 扫一扫


 177

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


