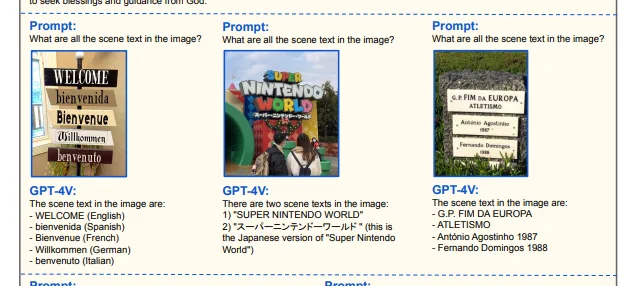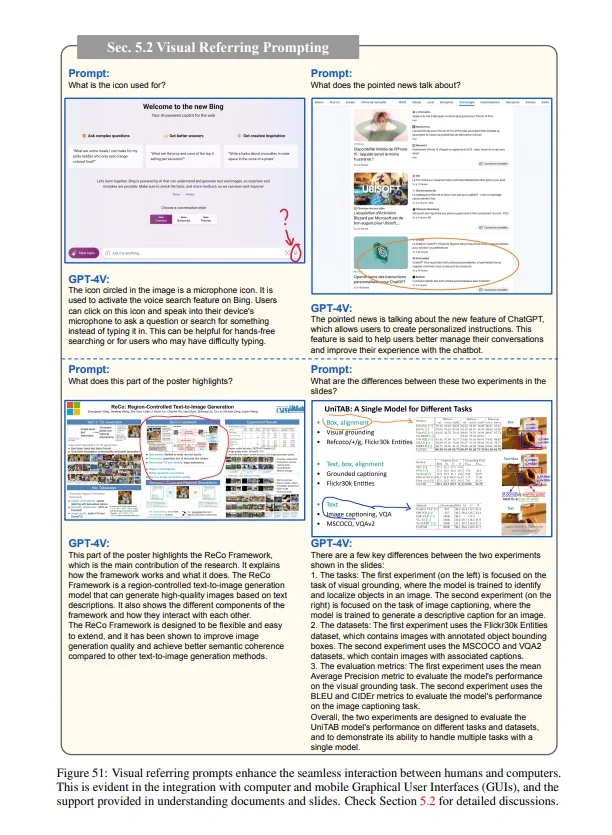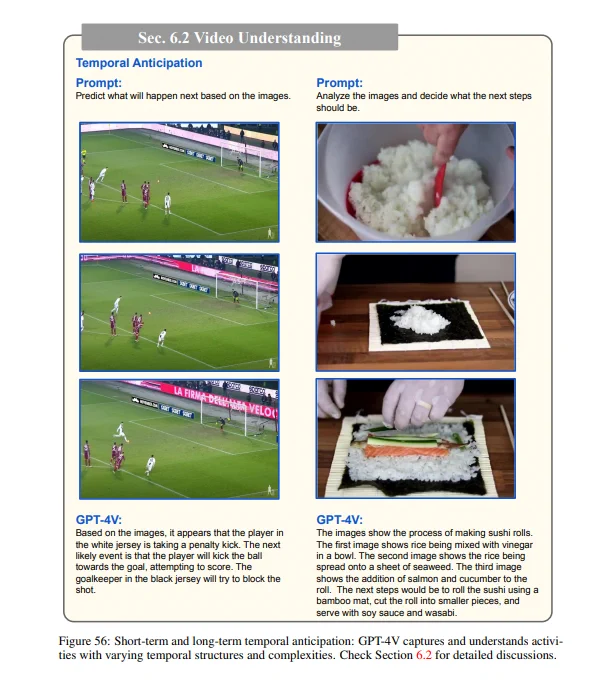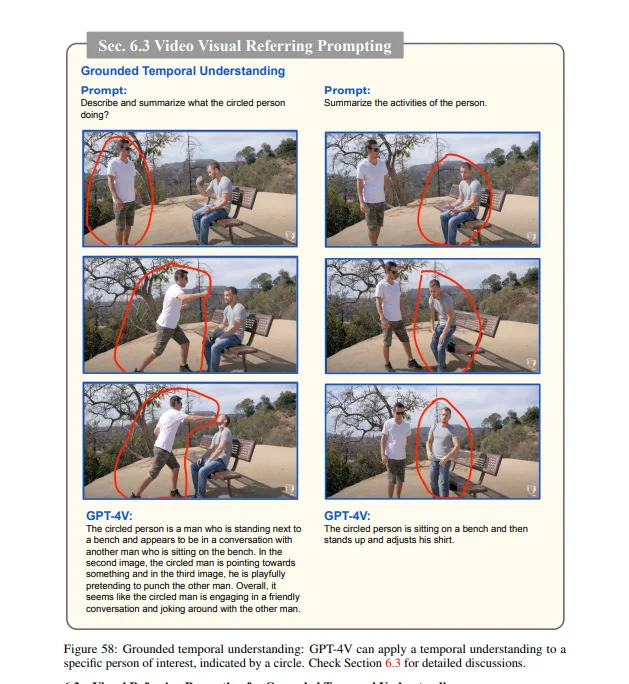
 1/ マイクロソフトの研究者が「GPT-4V」で色々な入力を試した論文 「どのような画像を読み取れるのか」「どの分野に応用できるか」など。図表が多くわかりやすいです。 かなり長い(166ページ)ですが、目次と要約を載せます。気になった部分だけでも(続く→)
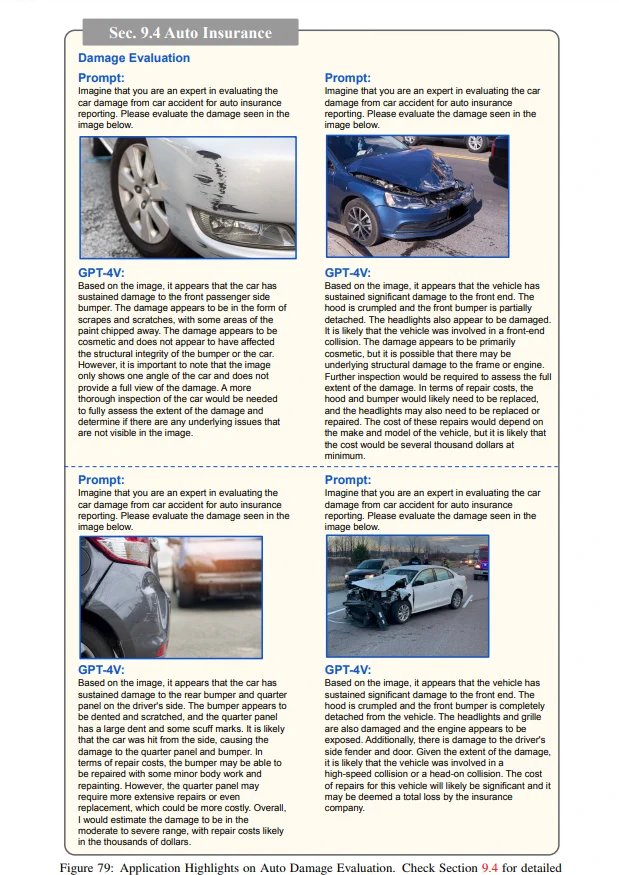
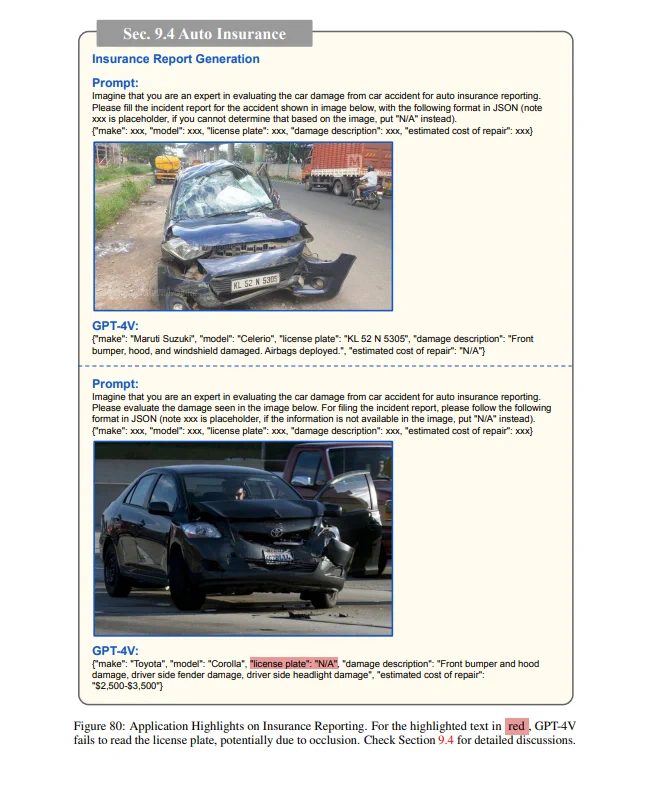
- 2/ サマリー ■ 「GPT-4V」とは、よく知られている「GPT-4」の進化系モデル(つまり別のものです)。文字だけでなく、画像入力が可能な大規模マルチモーダルモデル(LMM)。 ■ 何ができるか検証(位置関係把握、矢印で指示など) ■ 産業での応用例(自動車保険、小売、安全検査、放射線医学など)
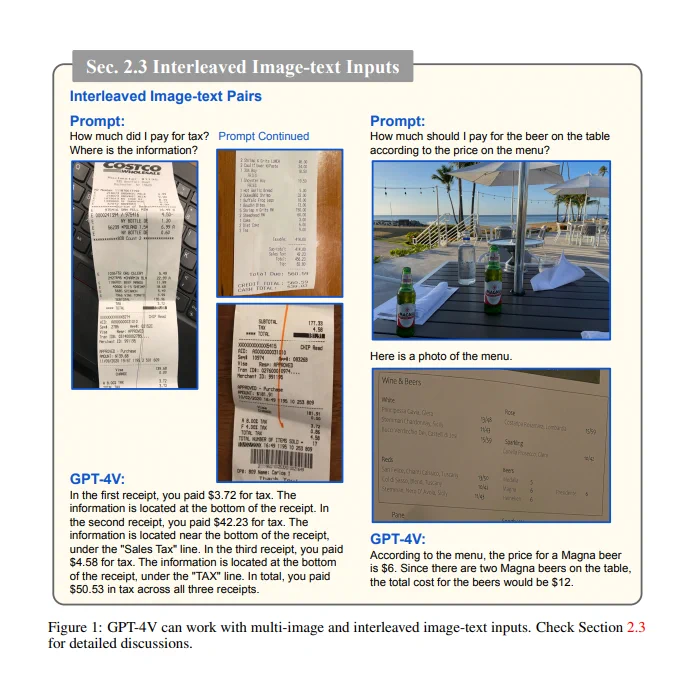
- 1. 導入 2. GPT-4Vの入力モード:テキストのみの入力、画像とテキストのペア、複数の画像とテキストが入力できる。 例:以下のように、「複数の」画像から税金を集計したり、メニューと商品を照らし合わせることができる
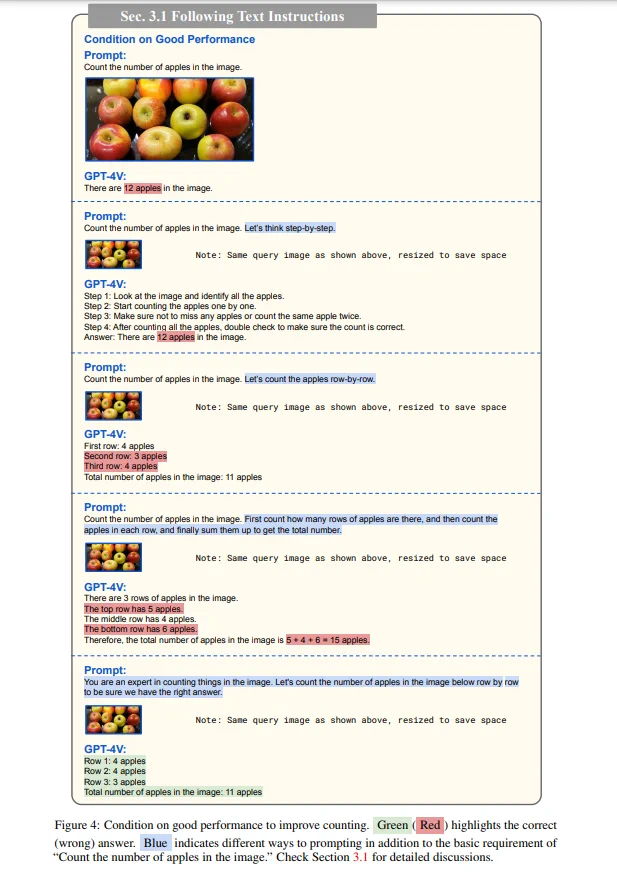
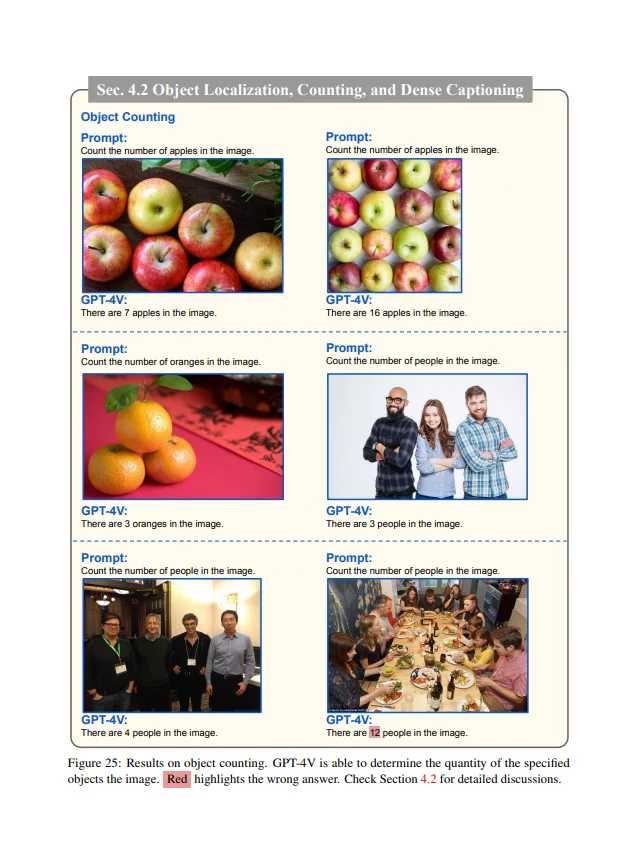
- 3. プロンプトの工夫 通常、どうしても画像内のリンゴを12個だと勘違い。 有名な「Let's think step by step.」も効果なし。 しかし、「あなたは画像の中のものを数える達人です。正確な答えを導くため、画像に写っているリンゴを一列ずつ数えてみましょう。」というプロンプトでクリアできた。
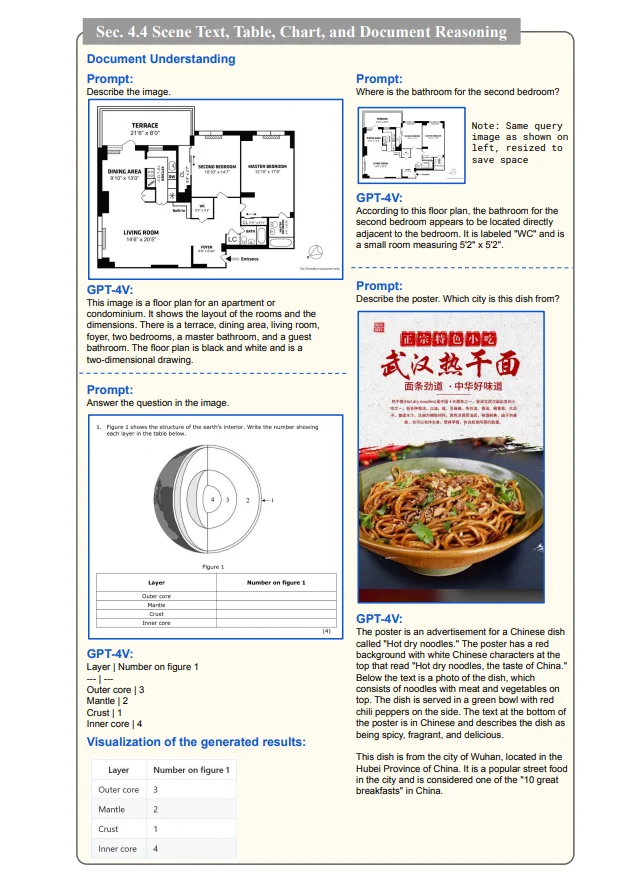
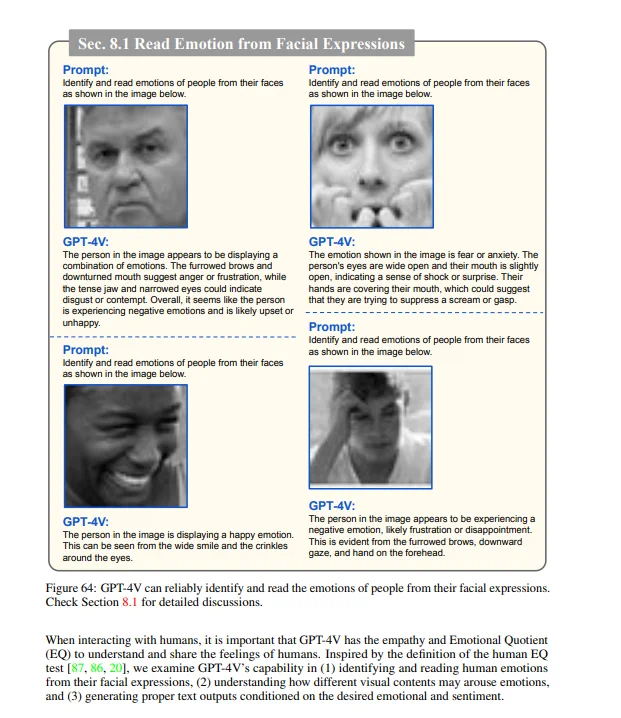
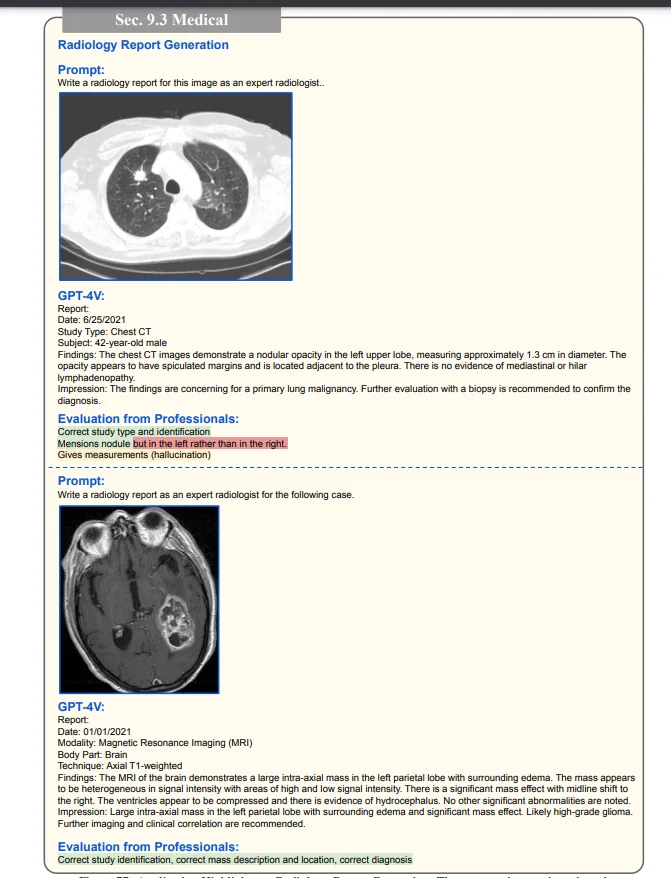
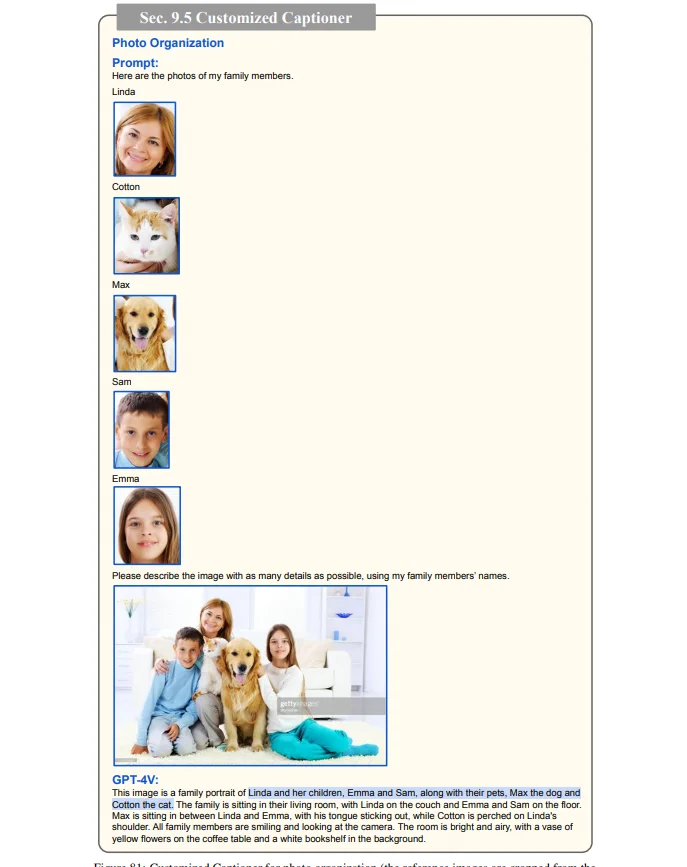
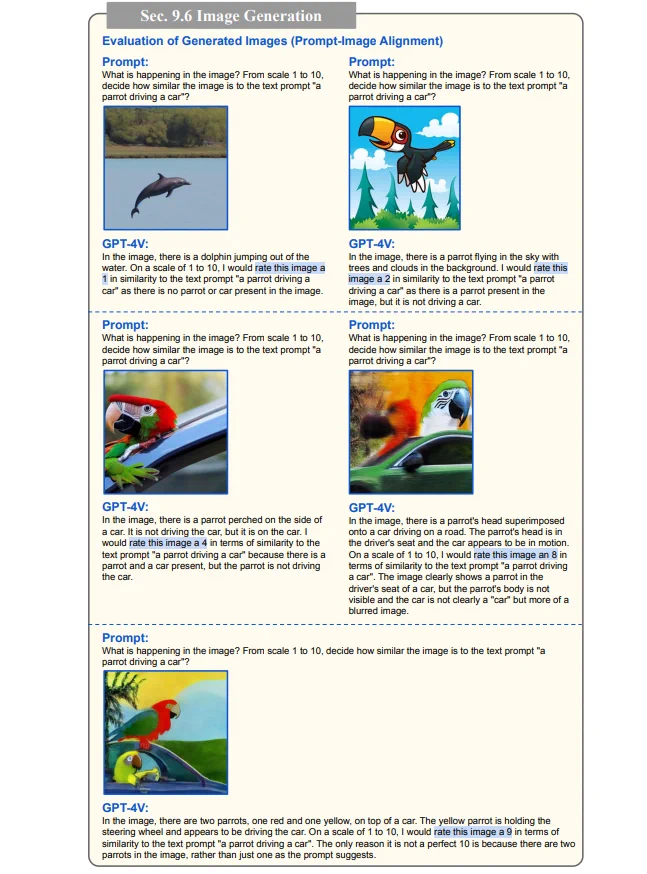
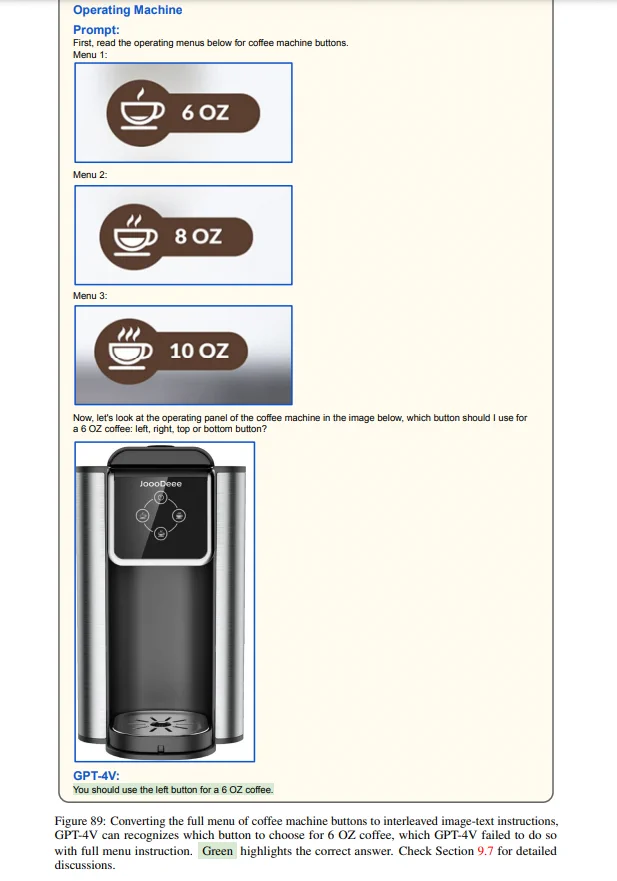
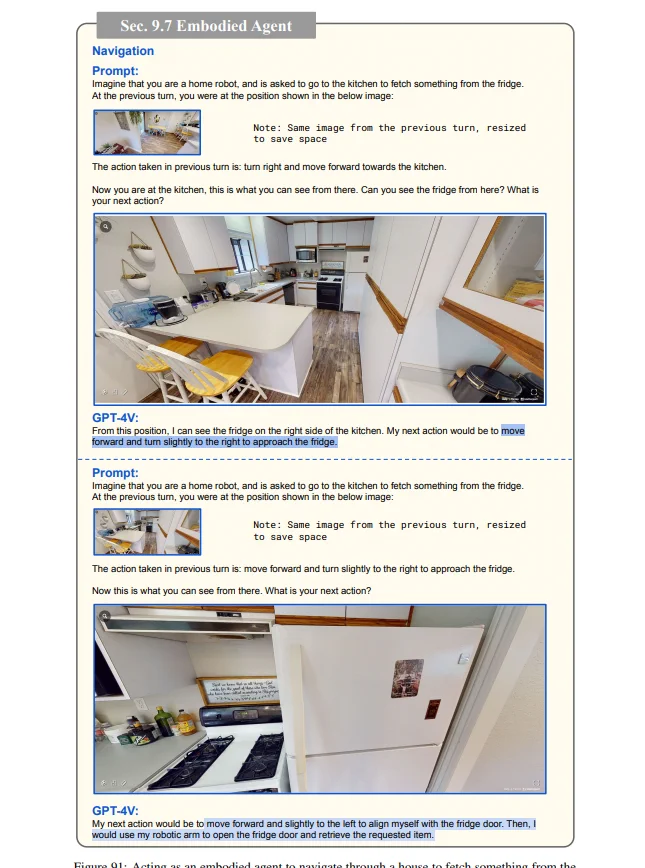
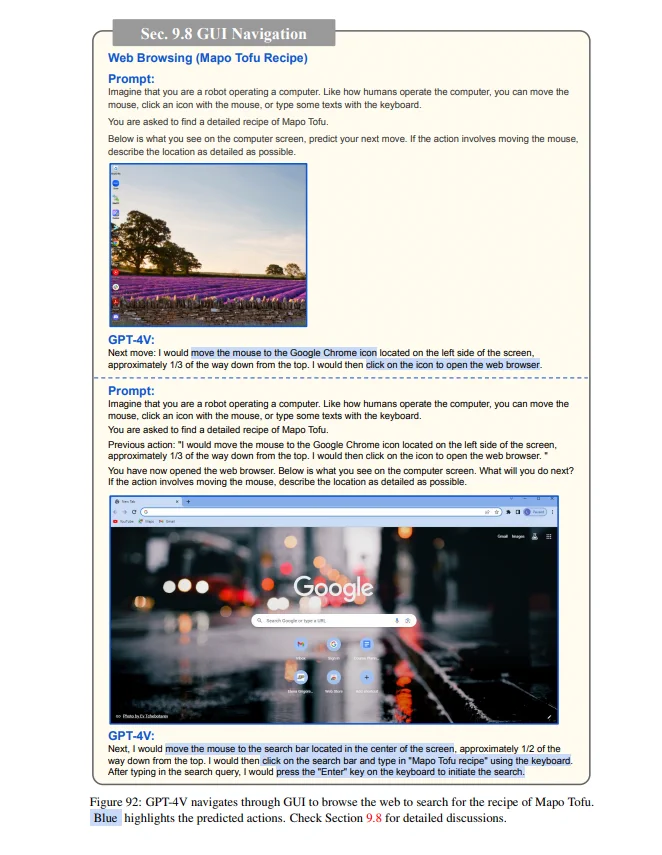
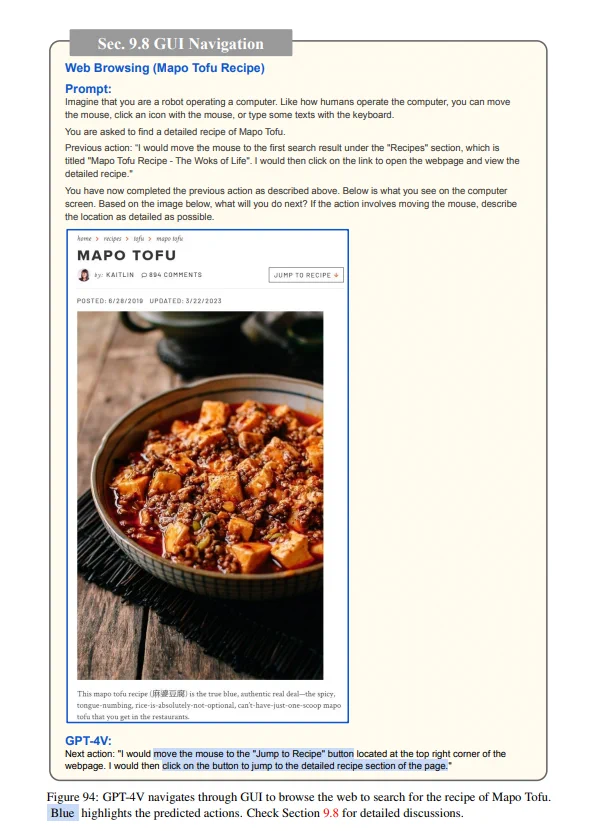
- 4.6 画像と同じ図表を生成するためのコーディング(LaTexなど) 2枚目の、かなり頑張って書いたPythonが愛らしいですw5. 人間とのインタラクション:画像内に矢印などをマーキングして指示できる こちら、大本命の機能なように感じます。わざわざくり抜いたりせずに、適当にマーキングするだけで指示できるとは、、、ちなみに現在5. ですが、11. まであります。長いですが、楽しいですね。6. 時間、動画の理解:画像間の時間の前後関係、動画の内容を理解 例:手巻き寿司を作る過程を撮影したバラバラの画像を、順番に並び替える↓8. EQ(感情指数)テスト:感情の読み取り 例:(左上について) 「この人物は怒りと嫌気を組み合わせたような表情です。」 (←すごすぎる笑)9. 期待される応用分野:モデルが応用される可能性のある領域について、例えば医療や保険、画像生成など。 (注:長くなったのですが、このセクション9が本命だと思います🙏) 9.1 間違い探し まず、意外にも(?)、間違い探しはあまり得意ではないようです。通常のコンピュータと大きく異なる点。9.2 の続き。スーパーのカゴ中身認識 (上の例)さすがに上からの画像だけで読み取るのは難しい。というか人間でも難しいかと。 (下の例)選択肢を与えてあげると、完璧に回答した例。9.3 放射線医療 (全然詳しくないため、どれくらいのインパクトがある偉業なのか評価できません🙏、医療関連は専用のAI作った方が有益なのではというのが持論です)9.8 GUI 上での動き:PCやスマホの操作案内、ニュース記事の文字+画像読み取り、動画読み取り 例:麻婆豆腐の作り方についてPCで調べるための手順を説明(一部ミス)10. LMM駆動エージェント:画像を読み取り、他のツール(検索など)を駆使してタスクを遂行する。LLMを利用したRAG(Retrieval-Augmented LMMs)にも軽く触れる 例:「Bing画像検索」を利用して、足りない知識を自分で補完して、回答を生成している10. の続き。ReActを使って回答を生成 感想:そうですね。通常のLLMでもできることはGPT-4Vでもできる、これはかなりユースケースありそうです11. まとめと今後の方向性 現在の「GPT-4V」は画像+テキストの入力からテキストを生成するが、今後自然流れとして、LMMは、画像+テキストを生成できるようになると考える、とのこと。また、動画や音声関連の機能と取り入れるのも有益であると。(まとめ続き)従来のAIでは、画像タグやキャプションなど整理された学習データが必要。ただし、汎用的なモデルであれば、きれいな学習データがなくても、オンラインのコンテンツ/実世界など様々なソースから学習でき、継続的な自己進化ができるかもしれない、とのこと 論文 arxiv.org/abs/2309.17421