hj_caas
码龄6年
求更新 关注
提问 私信
  • 博客:200,319
    社区:20
    200,339
    总访问量
  • 148
    原创
  • 4,057
    粉丝
  • 65
    关注
IP属地以运营商信息为准,境内显示到省(区、市),境外显示到国家(地区)
IP 属地:北京市
加入CSDN时间: 2020-05-22

个人简介:目前研究生在读,主要研究方向是自然语言处理领域,研究知识图谱、方面级情感分析等。目前熟悉python爬虫、机器学习、深度学习、NLP等相关技术,由于本人比较懒散,不会定期更新,后期会慢慢充实相关专题。

博客简介:

HJ_blog

博客描述:
个人学习记录,不定期更新
查看详细资料
个人成就
  • 获得1,295次点赞
  • 内容获得46次评论
  • 获得1,363次收藏
  • 代码片获得4,826次分享
  • 博客总排名1,106,698名
创作历程
  • 33篇
    2024年
  • 74篇
    2023年
  • 35篇
    2022年
  • 6篇
    2021年
成就勋章
TA的专栏
  • LLM
    付费
    7篇
  • 领域模型三阶段训练
    付费
    7篇
  • Linux学习
    付费
    37篇
  • 每日外文推荐
    付费
    16篇
  • 机器学习
    8篇
  • Python爬虫
    8篇
  • bug解决
    14篇
  • python知识
    12篇
  • pytorch学习
    7篇
  • Streamlit
    1篇
  • 自然语言处理
    12篇
  • Vscode Problem
    1篇
  • mac
    1篇
  • 数据挖掘
    3篇
  • 小波分析
    1篇

TA关注的专栏 0

TA关注的收藏夹 0

TA关注的社区 2

TA参与的活动 1

兴趣领域 设置
  • Python
    python
  • 人工智能
    数据挖掘人工智能深度学习神经网络自然语言处理知识图谱bert数据分析
创作活动更多

【多重好礼】鸿蒙心迹 · 开发录原创征稿活动

鸿蒙开发者的实战经验,值得被记录。从踩坑排查到项目复盘,从工具脚本到学习笔记,每一段真实的开发经历,都是社区最宝贵的技术资产。「鸿蒙心迹 · 开发录」正式启航,不限主题、随时可写,只要是鸿蒙开发相关的真实经验都欢迎投稿。 本活动为 [HarmonyOS 7.0 创新内容共创季](https://builderx.csdn.net/activity-site/harmonyos/activity2026)双轨征文之一,与[「共创季 · 稿事节」](https://harmonyosdev.csdn.net/6a97f0de2b83d06f0ecadec5.html)深度征文互补——「稿事节」写深度技术长文,「开发录」写日常开发实战笔记。 「开发录」每月一期,12月截止,本季共三期,投稿即有机会获得京东卡、CSDN博客流量券、亿万Token、社区定制周边好礼!

126人参与 去参加
  • 最近
  • 文章
  • 专栏
  • 代码仓
  • 资源
  • 收藏
  • 关注/订阅/互动
更多
  • 最近

  • 文章

  • 专栏

  • 代码仓

  • 资源

  • 收藏

  • 关注/订阅/互动

  • 社区

  • 帖子

  • 问答

  • 课程

  • 视频

搜索 取消

python中append的用法

发布资源 2022.08.20 ·
md

如何将传统的关键字搜索与现代向量搜索相结合,找到更相关的搜索结果

混合搜索是一种搜索技术,它结合了两种或两种以上的搜索算法,以提高搜索结果的相关性。虽然没有明确定义是哪种算法的组合,但混合搜索最常见的是指传统的基于关键字的搜索和现代的向量搜索的组合。传统上,基于关键词的搜索是搜索引擎的不二选择。但随着机器学习(ML)算法的出现,向量嵌入带来了一种新的搜索技术——向量或语义搜索——使我们能够对数据进行语义搜索。
原创
博文更新于 2024.02.27 ·
1384 阅读 ·
13 点赞 ·
0 评论 ·
18 收藏

检索增强生成(RAG):从理论到 LangChain 实现

检索增强生成(RAG)的概念是为 LLM 提供来自外部知识源的额外信息。这使他们能够生成更准确、更符合上下文的答案,同时减少幻觉。本文介绍了 2020 年发表的论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》中提出的 RAG 概念。在介绍了这一概念背后的一些理论(包括动机和问题解决方案)之后,本文转换了其在 Python 中的实现。
原创
博文更新于 2024.02.26 ·
1025 阅读 ·
4 点赞 ·
0 评论 ·
6 收藏

改进RAG:自查询检索

每日推荐一篇专注于解决实际问题的外文,精准翻译并深入解读其要点,助力读者培养实际问题解决和代码动手的能力。
原创
博文更新于 2024.02.26 ·
930 阅读 ·
6 点赞 ·
0 评论 ·
6 收藏

检索增强生成(RAG)-重新排序方法

如图 1 所示,重新排序的任务就像一个智能过滤器。当检索器从索引集合中检索出多个上下文时,这些上下文可能与用户的查询具有不同的相关性。有些上下文可能非常相关(图 1 中红色方框中突出显示的内容),而其他上下文可能只是略有相关甚至不相关(图 1 中绿色和蓝色方框中突出显示的内容)。重新排序的任务是评估这些上下文的相关性,并优先选择最有可能提供准确和相关答案的上下文。这样,LLM 就能在生成答案时优先考虑这些排名靠前的上下文,从而提高答案的准确性和质量。
原创
博文更新于 2024.02.25 ·
1932 阅读 ·
33 点赞 ·
0 评论 ·
28 收藏

提高自定义词汇的 RAG 性能

检索增强生成(RAG)由检索、增强和生成三部分组成。首先,将用户问题转换为搜索查询。其次,通过应用程序接口从各种来源获取相关文本数据。第三,将相关文本数据与用户问题一起插入 LLM(大语言模型)提示。第四,LLM 根据相关文本数据生成对用户问题的回复。最后,将答案与相关数据源一起显示给用户,这样用户就可以轻松验证聊天机器人的答案。这一过程具有透明度和可扩展性。最后一步是显示聊天机器人回答问题的理由,这对于提高透明度至关重要。
原创
博文更新于 2024.02.25 ·
812 阅读 ·
11 点赞 ·
0 评论 ·
19 收藏

检索增强生成(RAG)——提示工程方法

在检索增强生成(RAG)过程中,提示工程也是一个不可忽略的部分。提示工程可以降低 RAG 应用出现的幻觉,提高 RAG 应用回答的质量。下面简单介绍一些关于提示工程的论文。
原创
博文更新于 2024.02.24 ·
1276 阅读 ·
29 点赞 ·
0 评论 ·
30 收藏

可视化 RAG 数据 - 用于检索增强生成的 EDA

每日推荐一篇专注于解决实际问题的外文,精准翻译并深入解读其要点,助力读者培养实际问题解决和代码动手的能力。
原创
博文更新于 2024.02.24 ·
1111 阅读 ·
26 点赞 ·
0 评论 ·
17 收藏

为什么先进的 RAG 方法对 AI 的未来至关重要?

检索增强生成(RAG)是生成式人工智能领域的一大进步,它将高效的数据检索与大型语言模型的强大功能结合在一起。RAG 的核心工作是利用向量搜索挖掘相关的现有数据,将这些检索到的信息与用户的查询结合起来,然后通过类似 ChatGPT 的大型语言模型进行处理。这种 RAG 方法可确保生成的响应不仅精确,而且还能反映当前的信息,从而大大减少输出中的不准确或 “幻觉”。然而,随着人工智能应用领域的不断扩大,对 RAG 提出的要求也变得更加复杂多样。
原创
博文更新于 2024.02.23 ·
1493 阅读 ·
30 点赞 ·
0 评论 ·
8 收藏

RAG 语义分块实践

每日推荐一篇专注于解决实际问题的外文,精准翻译并深入解读其要点,助力读者培养实际问题解决和代码动手的能力。原文标题:Semantic chunking in practice原文地址:https://medium.com/@boudhayan-dev/semantic-chunking-in-practice-23a8bc33d56d。
原创
博文更新于 2024.02.23 ·
1036 阅读 ·
10 点赞 ·
0 评论 ·
28 收藏

Sora-OpenAI 的 Text-to-Video 模型:制作逼真的 60s 视频片段

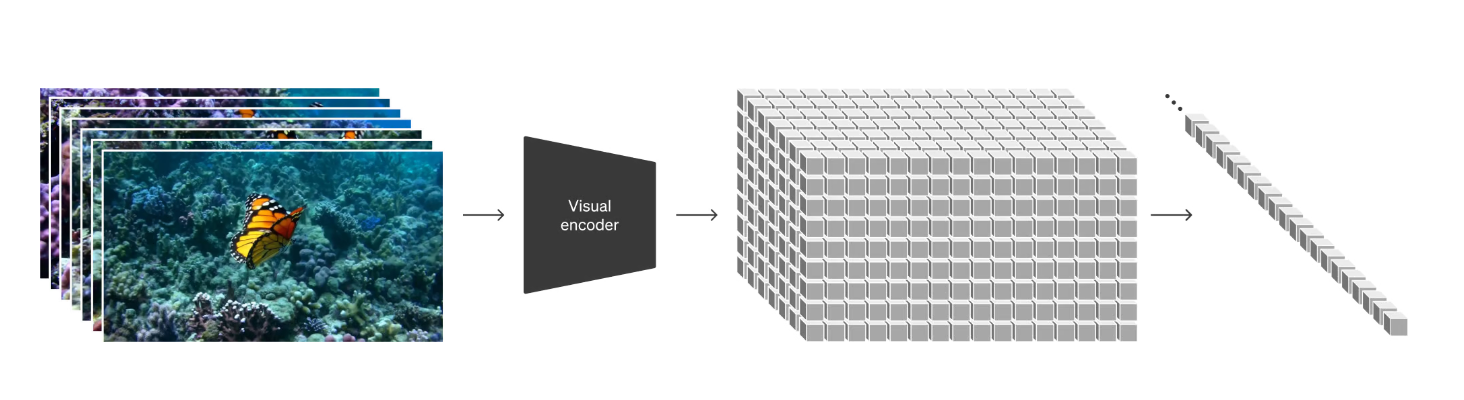
种类型的视觉数据转换为统一表示的方法,以实现大规模生成模型的训练,以及 (2) 对 Sora 的能力和局限性进行定性评估。Sora 是一种视觉数据的通用模型——它能够生成持续时间、宽高比和分辨率多样化的视频和图像,最长可达一分钟的高清视频。我们将 Sora 与我们的模型的一个版本进行了比较,这个版本模型将所有训练视频裁剪为正方形,这在训练生成模型时是常见做法。我们在我们的登陆页面上列举了模型的其他常见失败模式——例如,在长时间样本中发展的不一致性或对象的突然出现。我们训练了一个降低视觉数据维度的网络。
原创
博文更新于 2024.02.23 ·
1458 阅读 ·
22 点赞 ·
0 评论 ·
24 收藏

释放语义分块的力量:LlamaIndex之旅

在不断扩展的语言模型领域中,最大化应用潜力通常需要将大块文本分解为更易消化的部分。这个被称为语义分块的过程,在增强ChatGPT等模型性能和促进应用的长期记忆方面发挥了关键作用。语义分块也称为分割,是指将大量文本数据分解成更小、更易于处理的片段。在多模态环境中,这个概念不仅限于文本,还包括图像。在本教程中,我们将深入研究文本分割的 5 个层次,探索各种策略,包括与 LlamaIndex 的有趣整合。
原创
博文更新于 2024.02.21 ·
443 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

实现RAG管道中的上下文压缩和过滤

检索面临的一个挑战是,我们通常不知道在将数据输入系统时,我们的文档存储系统会面临哪些具体查询。这意味着,与查询最相关的信息可能会被埋藏在包含大量无关文本的文档中。在应用程序中传递完整的文档可能会导致更昂贵的 LLM 调用和更差的响应。因此,"上下文压缩 "的概念就派上了用场。这个想法是:-我们有某种基础检索器,可以检索到大量不同的信息。然后,我们将这些信息添加到文件压缩器中。压缩器对这些信息进行过滤和处理,只提取对回答问题有用的信息。要使用上下文压缩检索器,您需要:一个基础检索器文件压缩器。
原创
博文更新于 2024.02.21 ·
455 阅读 ·
11 点赞 ·
0 评论 ·
0 收藏

提高RAG性能的高级查询转换

每日推荐一篇专注于解决实际问题的外文,精准翻译并深入解读其要点,助力读者培养实际问题解决和代码动手的能力。
原创
博文更新于 2024.02.20 ·
138 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

使用主动检索增强生成 FLARE 实现更优越的 RAG

FLARE 是前瞻性主动检索增强生成(Forward-Looking Active Retrieval Augmented Generation)的缩写。这是一种补充 LLM 的方法,在模型生成内容的过程中主动纳入外部信息。这一过程大大降低了产生幻觉的风险,确保内容不断得到外部数据的检查和支持。传统的检索-增强生成在传统的检索-增强生成模型中,通常的方法是在生成过程开始时执行一次检索。该方法涉及使用初始查询,例如“总结 Narendra Modi 的维基百科页面”,并根据此查询检索相关文档。
原创
博文更新于 2024.02.20 ·
595 阅读 ·
11 点赞 ·
0 评论 ·
0 收藏

实测:ValueError: FP16 Mixed precision training with AMP or APEX (`--fp16`) and FP16 h alf precision

降低transformers版本。经过上面两步后,解决了这个问题。
原创
博文更新于 2024.02.20 ·
3706 阅读 ·
8 点赞 ·
7 评论 ·
5 收藏

检索增强生成中的创新

每日推荐一篇专注于解决实际问题的外文,精准翻译并深入解读其要点,助力读者培养实际问题解决和代码动手的能力。
原创
博文更新于 2024.01.22 ·
247 阅读 ·
5 点赞 ·
0 评论 ·
0 收藏

构建开源的多模态 RAG 系统

检索增强生成(RAG):增强AI的理解和产出在人工智能领域,“检索增强生成”(RAG)作为一种变革性技术脱颖而出,完善了大型语言模型(LLM)的功能。从本质上讲,RAG 允许模型从外部来源动态检索实时信息,从而增强了人工智能响应的特异性。大型语言模型(如 GPT-3)在生成类人语言方面表现出色,但在提供最新信息或特定领域信息方面存在局限性。RAG 通过整合检索机制来解决这一问题,该机制可从外部知识库中提取相关事实,确保回答既语言合理,又事实准确。
原创
博文更新于 2024.01.22 ·
727 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

在不同的 RAG 阶段注入知识图谱

每日推荐一篇专注于解决实际问题的外文,精准翻译并深入解读其要点,助力读者培养实际问题解决和代码动手的能力。原文标题:Injecting Knowledge Graphs in different RAG stages原文地址:https://medium.com/enterprise-rag/injecting-knowledge-graphs-in-different-rag-stages-a3cd1221f57b在本文中,我想准确地介绍知识图谱 (KG) 在 RAG 中的应用。
原创
博文更新于 2024.01.21 ·
450 阅读 ·
0 点赞 ·
0 评论 ·
1 收藏

基于LLM+RAG的问答

每日推荐一篇专注于解决实际问题的外文,精准翻译并深入解读其要点,助力读者培养实际问题解决和代码动手的能力。
原创
博文更新于 2024.01.21 ·
380 阅读 ·
5 点赞 ·
0 评论 ·
0 收藏
加载更多