元直数字电路验证
码龄15年
求更新 关注
提问 私信
  • 博客:3,028,492
    社区:9,442
    动态:31,825
    3,069,759
    总访问量
  • 873
    原创
  • 1,605
    排名
  • 92,943
    粉丝
  • 102
    关注
IP属地以运营商信息为准,境内显示到省(区、市),境外显示到国家(地区)
IP 属地:四川省
目前就职: 联发科技
加入CSDN时间: 2012-03-27

个人简介:天地本無心,生民自有命,往聖無絕學,萬世不太平。硅農,因bug而生,與bug為伴,以debug為生。

博客简介:

元直的博客

博客描述:
不積跬步,無以至千里;不積小流,無以成江海。
查看详细资料
个人成就
  • 领域专家: 嵌入式与硬件开发技术领域
  • 获得7,847次点赞
  • 内容获得325次评论
  • 获得21,806次收藏
  • 代码片获得4,779次分享
  • 原力等级
    原力等级
    9
    原力分
    11,905
    本月获得
    77
创作历程
  • 174篇
    2026年
  • 212篇
    2025年
  • 32篇
    2024年
  • 19篇
    2023年
  • 48篇
    2022年
  • 72篇
    2021年
  • 260篇
    2020年
  • 123篇
    2019年
成就勋章
TA的专栏
  • 异构计算芯片中数据加解密方案及验证策略
    付费
    21篇
  • 深入解析 NLP & UPF 标准
    付费
    38篇
  • SoC上常见的总线协议详解
    付费
    87篇
  • IC行业常用EDA工具使用及技巧
    付费
    103篇
  • SystemVerilog从入门到实战
    付费
    164篇
  • PCIe/CXL/IOMMU/ATS 学习笔记
    付费
    58篇
  • SystemC从入门到实战
    付费
    51篇
  • UVM从入门到实战
    付费
    90篇
  • 软件工程与数字化转型
    付费
    60篇
  • AI Agent 工程化全栈指南
    付费
    19篇
  • AI赋能IC验证:从大模型到EDA Agent
    33篇
  • 寄存器模型在SoC驗證中的应用
    20篇
  • 一步一步搭建高质量UVM验证环境
    8篇
  • 验证工程师养成笔记
    82篇
  • Python数据分析从入门到实战
    26篇
  • CShell/Tcl语法详解与实战技巧
    29篇
  • Perl语法详解与实战应用
    24篇
  • CMOS集成電路設計
    26篇
  • 数模混合电路设计与仿真
    24篇
  • MIPI M-PHY Spec Study Share
    4篇
  • DigRF v4 Spec Study Share
    2篇
  • 通信原理
    9篇
  • 數字後端
    9篇

TA关注的专栏 3

TA关注的收藏夹 0

TA关注的社区 13

TA参与的活动 14

兴趣领域 设置
  • 硬件开发
    硬件工程fpga开发dsp开发arm开发射频工程基带工程硬件架构
数字电路验证专栏
本专栏主要介绍数字电路验证基础知识,验证方法学,以及IC领域的前沿知识。
创作活动更多

【多重好礼】鸿蒙心迹 · 开发录原创征稿活动

鸿蒙开发者的实战经验,值得被记录。从踩坑排查到项目复盘,从工具脚本到学习笔记,每一段真实的开发经历,都是社区最宝贵的技术资产。「鸿蒙心迹 · 开发录」正式启航,不限主题、随时可写,只要是鸿蒙开发相关的真实经验都欢迎投稿。 本活动为 [HarmonyOS 7.0 创新内容共创季](https://builderx.csdn.net/activity-site/harmonyos/activity2026)双轨征文之一,与[「共创季 · 稿事节」](https://harmonyosdev.csdn.net/6a97f0de2b83d06f0ecadec5.html)深度征文互补——「稿事节」写深度技术长文,「开发录」写日常开发实战笔记。 「开发录」每月一期,12月截止,本季共三期,投稿即有机会获得京东卡、CSDN博客流量券、亿万Token、社区定制周边好礼!

125人参与 去参加
  • 最近
  • 文章
  • 专栏
  • 代码仓
  • 资源
  • 收藏
  • 关注/订阅/互动
更多
  • 最近

  • 文章

  • 专栏

  • 代码仓

  • 资源

  • 收藏

  • 关注/订阅/互动

  • 社区

  • 帖子

  • 问答

  • 课程

  • 视频

搜索 取消

通过 ACM 论文模板学习 LaTeX 语法:从零到顶刊投稿

本文以ACM acmart模板为载体,系统讲解LaTeX论文写作核心语法,涵盖编译环境配置、模板使用、文档结构、图文表格、公式算法、参考文献引用等顶刊必备技能。通过真实可运行代码示例,手把手指导零基础用户从安装工具到独立排版,掌握规范排版与错误排查能力,实现快速迁移至IEEE/Springer等主流模板,助力科研论文高效投稿。
原创
博文更新于 2026.09.14 ·
39 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

DFT 系列(03):ATPG、故障模型与 Coverage——别被 99% 这个数字骗了

文章指出没有故障模型和分母定义的“99% coverage”没有可比性,可能是stuck-at coverage或排除大量untestable/X-blocked faults。拆解ATPG原理、故障模型语义、coverage分母陷阱及pattern仿真与X处理,强调aborted不等于proven untestable,coverage公式必须给出类别与分母,避免被表面数字误导。
原创
博文更新于 2026.09.03 ·
35 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

DFT 系列(02):Scan Cell、Scan Chain 与 Shift/Capture 协议

本文否定Scan chain单纯“灌入移出”的验证法,建立最小概念体系:muxed-D scan cell行为模型、链方向作为单一事实源、shift/capture/unload协议、lockup latch必要性,以及DV参考模型与首错分类。强调参考模型必须与chain manifest同源,按首错偏移分类可快速定位断链、跨域、capture语义等问题。
原创
博文更新于 2026.09.03 ·
146 阅读 ·
3 点赞 ·
0 评论 ·
0 收藏

DFT 系列(01):先别急着插 Scan——DFT 的目标、架构与职责边界

本文阐述DFT须在微架构阶段定义,通过扫描链等结构提升可控性与可观测性,覆盖制造测试、诊断与系统内测试三类目标。强调DFT架构规格需明确扫描、时钟、存储、访问等细节,并区分DE、DFT、DV、PD等角色责任。DFT验证需分层,从RTL到ATE逐级确认,否则易产生量产风险。
原创
博文更新于 2026.09.03 ·
50 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

08 分类微调:把 GPT 变成垃圾邮件分类器

本文介绍如何将预训练GPT微调为垃圾邮件分类器。预训练模型输出词表概率,需替换输出头为二分类层。微调可仅训练输出头或全量微调,后者效果更好。数据使用UCI SMS数据集,需分层划分并填充样本。关键点:取最后一个token嵌入进行分
原创
博文更新于 2026.09.03 ·
62 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

07 预训练(下):温度采样、Top-k 与加载官方 GPT-2 权重

本文介绍了提升文本生成质量的两项技术:温度采样与Top-k截断,使输出多样且合理;并讲解了模型保存/加载方法,以及如何加载官方GPT-2权重,跳过预训练直接体验成熟模型。
原创
博文更新于 2026.09.03 ·
39 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

06 预训练(上):损失、困惑度与训练循环

本文介绍GPT预训练核心:通过“预测下一个词”的自监督任务学习语言规律。用交叉熵损失衡量预测误差,困惑度=exp(损失)直观反映模型平均候选词数。训练循环周期性地计算损失并生成样例,结合定量与定性评估,验证模型语言能力。
原创
博文更新于 2026.09.03 ·
406 阅读 ·
14 点赞 ·
0 评论 ·
0 收藏

12 前置知识:PyTorch 速览(张量、自动微分与模块)

本文是对PyTorch关键机制的速览,涵盖张量(含多维约定、形状操作与广播)、自动微分(计算图、梯度累积及no_grad优化)、nn.Module(模型构建、参数保存与模式切换)以及DataLoader等,帮助读者补齐理解GPT代码所需的PyTorch编程基础。
原创
博文更新于 2026.09.02 ·
76 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

11 训练进阶:学习率预热、余弦衰减与梯度裁剪

本文讲解LLM训练三大技巧:学习率预热避免起步震荡,余弦衰减平滑收敛,梯度裁剪防梯度爆炸;给出get_lr函数与PyTorch实现,实测可显著降低验证损失,是免费性能提升。
原创
博文更新于 2026.09.02 ·
99 阅读 ·
3 点赞 ·
0 评论 ·
0 收藏

10 高效微调:LoRA 实战(把参数量压到 1%)

本文介绍高效微调方法LoRA,通过低秩分解将权重更新压缩为两个小矩阵,仅训练约1%参数即可接近全量微调效果。采用替换Q/V投影层、冻结原权重策略,推理时合并权重零额外开销,省显存且实现简单,是推荐的默认PEFT方案。
原创
博文更新于 2026.09.02 ·
140 阅读 ·
5 点赞 ·
0 评论 ·
0 收藏

05 从零搭建 GPT 模型:LayerNorm、GELU 与解码器堆叠

本文介绍从零搭建GPT模型的关键组件:LayerNorm对特征维归一化,GELU平滑激活,前馈网络扩展收缩,残差连接缓解梯度消失。随后组装TransformerBlock(多头注意力+前馈,Pre-LN),最终构建GPTModel并实现文本生成,附参数量核算。
原创
博文更新于 2026.09.02 ·
1010 阅读 ·
11 点赞 ·
0 评论 ·
0 收藏

04 注意力机制(下):因果掩码与多头注意力

本文介绍了因果掩码与多头注意力:因果掩码通过上三角置-∞使GPT只关注过去,保障自回归训练与推理一致;多头注意力并行捕捉不同模式。并涵盖dropout正则化及CausalAttention类实现细节,为构建大模型奠定基础。
原创
博文更新于 2026.09.02 ·
176 阅读 ·
5 点赞 ·
0 评论 ·
0 收藏

03 注意力机制(上):从 RNN 困境到自注意力与缩放点积注意力

本文讲解注意力机制:针对RNN长句信息瓶颈,提出自注意力,让每个token动态加权全部token,获得上下文相关表示。实现分三步:点积算分数、softmax归一化权重、加权求和得上下文向量;矩阵化可并行。最后引入可学习的QKV投影,使注意力具备学习能力,为缩放点积注意力打下基础。
原创
博文更新于 2026.09.02 ·
259 阅读 ·
8 点赞 ·
0 评论 ·
0 收藏

02 文本数据处理:分词、BPE 与词嵌入——给 LLM 准备“燃料”

本文讲解LLM文本数据处理的完整流水线:原始文本经分词(推荐BPE子词)、映射为token ID,再经嵌入层变为稠密向量。文章从朴素正则分词器讲起,说明词汇表构建、编码解码配对,并引入<|unk|>和<|endoftext|>等特殊token处理未知词与文档边界。最后强调嵌入向量将语义相近的词映射到相近位置,是模型理解语言的基础。
原创
博文更新于 2026.09.02 ·
123 阅读 ·
4 点赞 ·
0 评论 ·
0 收藏

09 指令微调:训练一个能听懂指令的 AI 助手

指令样本长度不一,默认 collate 无法把变长序列堆成一个张量。需要自定义 collate:每批内填充到最长长度。# 把填充位置的 pad token 替换为 -100(保留第一个作为结束标记)关键理解(对应-100输入 = 原序列 + 一个 pad 再去掉最后一个(长度对齐)。目标 = 原序列右移一位+ 末尾补 pad。目标中的 pad 位置全部替换为-100,但保留一个 50256(让模型学会"何时结束回答")。交叉熵的默认会自动跳过 -100 的位置。
原创
博文更新于 2026.09.02 ·
30 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

00 工程篇:环境搭建与项目结构(从零开发 GPT 的开工准备)

系列第 0 篇。本文提供完整的环境清单、项目目录结构、与常见工程问题速查,是整套系列可落地开发的"开工手册"。
原创
博文更新于 2026.09.02 ·
167 阅读 ·
5 点赞 ·
0 评论 ·
0 收藏

01 理解大模型:为什么从零构建?——LLM 全景与学习路线图

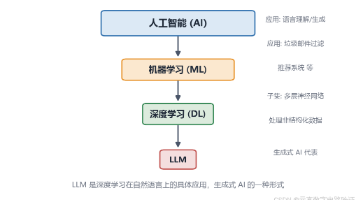
大语言模型(Large Language Model, LLM)是一种基于深度学习的神经网络模型,专门用于理解、生成和处理自然语言。它以「预测下一个词」为核心任务,在海量文本上自监督训练后,具备了填空、续写、问答、翻译、摘要、对话等能力。输入: "今天天气真"输出: "好,我们出去走走吧。关键在于:模型并没有「理解」天气,它只是学会了根据上下文推断下一个词的概率分布。这种「模仿」能力足够强时,就会在行为上表现为"智能"。
原创
博文更新于 2026.09.02 ·
60 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

DFT 设计与验证系列(专业版):从 Scan 到 SoC/Chiplet Sign-off

面向 DE、DV、DFT Engineer 的系统教程与项目查阅手册。全系列 15 篇:1 篇导读 + 14 篇专题。每篇可独立阅读,也可作为项目执行时的查阅手册。
原创
博文更新于 2026.08.27 ·
49 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

DFT 系列(14):DE/DV 项目落地——Milestone、Testplan、Case 与 Sign-off 模板

DFT 是贯穿 spec、architecture、RTL、netlist、pattern、timing、power、安全与量产的系统工程;验证的价值,是让这些交付物之间的意图保持可追溯、可复现、可证伪。工具会换代,工艺会演进,标准会更新——但"先定义证据,再谈覆盖率"这条纪律不会过时。
原创
博文更新于 2026.08.27 ·
42 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏

DFT 系列(13):Coverage、Sign-off 与 Debug——先分类,再看波形

单一 coverage dashboard 容易制造虚假的确定性。DFT readiness 至少需要 requirement、structural、protocol、scenario、assertion、fault、pattern 和 waiver 八类证据。本篇给出覆盖率的多维框架、requirement trace、waiver 纪律、debug 决策树、失败签名表与首错证据包——这是全系列"证据观"的收敛。
原创
博文更新于 2026.08.27 ·
45 阅读 ·
1 点赞 ·
0 评论 ·
0 收藏
加载更多