


CUDA入门:从Hello World到矩阵运算
本文记录了我作为C++工程师转型AI Infrastructure的第一周学习经历,从零开始学习CUDA编程,完成了向量加法和矩阵运算的实战项目。
一、为什么学CUDA?
AI时代的必备技能
在当前的AI浪潮中,深度学习模型的训练和推理都离不开GPU加速。无论是大模型的训练,还是推理服务的优化,CUDA都是绕不开的底层技术。作为一名想要进入AI Infrastructure领域的C++工程师,掌握CUDA是打开这扇门的钥匙。
推理优化的基础
现代AI推理框架如TensorRT、vLLM等,其核心优化技术都基于CUDA。Flash Attention、PagedAttention这些前沿优化算法,本质上都是高效的CUDA kernel实现。只有理解了CUDA的底层原理,才能真正读懂这些优化技术的精髓。
个人转型AI Infra的第一步
我给自己制定了8个月的学习计划,目标是从传统C++开发转型到AI Infrastructure方向。CUDA编程是这个计划的第一个里程碑。通过系统学习CUDA,我希望能够:
- 理解GPU编程模型和并行计算思维
- 掌握推理优化的核心技术栈
- 为后续学习深度学习框架打下基础
- 构建可展示的技术项目
二、环境搭建
CUDA Toolkit安装
我使用的开发环境:
- 操作系统:Windows 11
- GPU:NVIDIA RTX 4060
- CUDA版本:12.8
- Visual Studio:2022 Community
安装步骤:
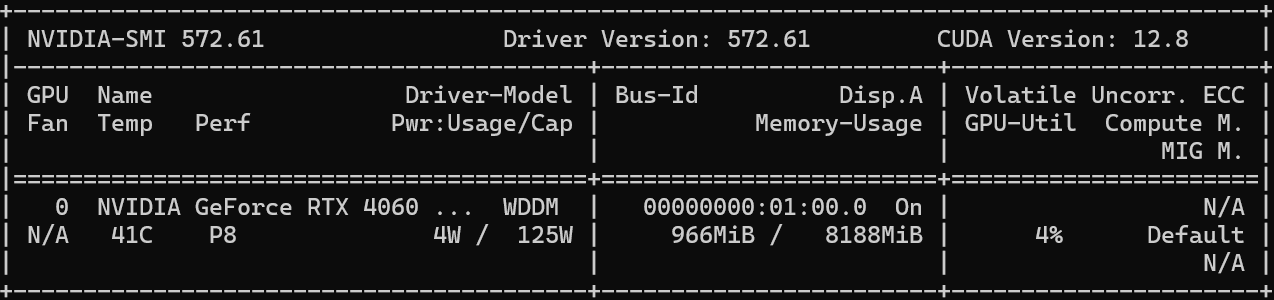
- 检查GPU兼容性
在命令行终端运行,可以看到GPU相关信息
nvidia-smi
-
下载CUDA Toolkit
- 访问NVIDIA官网下载对应版本
- 选择本地安装包(约3GB)
- 安装路径:
C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v12.1
-
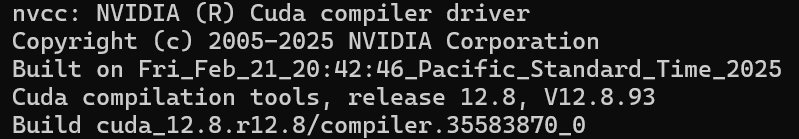
验证安装
nvcc --version
VS2022配置
CUDA Toolkit安装后会自动集成到Visual Studio中,需要确保:
- 安装了"使用C++的桌面开发"工作负载
- 新建项目时选择"CUDA Runtime"模板
- 项目属性中确认CUDA编译器路径正确
第一个程序测试
创建hello_cuda.cu文件:
#include <stdio.h>

__global__ void hello_cuda() {
    printf("Hello from GPU! Thread %d\n", threadIdx.x);
}

int main() {
    printf("Hello from CPU!\n");
    hello_cuda<<<1, 10>>>();
    cudaDeviceSynchronize();
    return 0;
}
编译运行后看到10个线程的输出,说明环境配置成功!
三、CUDA核心概念
3.1 Grid/Block/Thread层级关系
CUDA的并行计算模型采用了三层层级结构:
Grid (网格)
  ├── Block (线程块)
  │     ├── Thread (线程)
  │     ├── Thread
  │     └── ...
  ├── Block
  └── ...
关键理解:
- Grid:整个kernel的执行空间,可以是1D、2D或3D
- Block:线程块,同一个Block内的线程可以共享shared memory,可以同步
- Thread:最小执行单元,每个线程执行相同的kernel代码,但处理不同的数据
索引计算公式:
对于1D配置:
int tid = blockIdx.x * blockDim.x + threadIdx.x;
对于2D配置:
int row = blockIdx.y * blockDim.y + threadIdx.y;
int col = blockIdx.x * blockDim.x + threadIdx.x;
代码示例:
__global__ void print_indices() {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;
    printf("Block %d, Thread %d, Global ID %d\n",
           blockIdx.x, threadIdx.x, tid);
}

int main() {
    // 启动配置:2个Block,每个Block有4个Thread
    print_indices<<<2, 4>>>();
    cudaDeviceSynchronize();
    return 0;
}
3.2 内存管理
CUDA的内存模型区分Host(CPU)和Device(GPU):
CPU Memory (Host)  <--数据传输-->  GPU Memory (Device)
    ↓                                      ↓
RAM (较大,较慢)                    显存 (较小,极快)
核心API:
// 分配GPU内存
float *d_array;
cudaMalloc(&d_array, size * sizeof(float));

// CPU到GPU
cudaMemcpy(d_array, h_array, size * sizeof(float),
           cudaMemcpyHostToDevice);

// GPU到CPU
cudaMemcpy(h_array, d_array, size * sizeof(float),
           cudaMemcpyDeviceToHost);

// 释放GPU内存
cudaFree(d_array);
数据流动典型模式:
- 在CPU上准备数据
- 分配GPU内存
- 将数据从CPU拷贝到GPU
- 执行kernel
- 将结果从GPU拷贝回CPU
- 释放GPU内存
3.3 Kernel编程
__global__函数声明:
__global__ void kernel_name(参数列表) {
    // kernel代码
    // 由每个线程并行执行
}
启动配置语法:
kernel_name<<<gridDim, blockDim>>>(参数);
gridDim:Grid的维度(Block的数量)blockDim:Block的维度(每个Block中Thread的数量)
边界检查的重要性:
当数据量不是Block大小的整数倍时,必须进行边界检查:
__global__ void safe_kernel(float *data, int n) {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;

    // 边界检查,防止越界访问
    if (tid < n) {
        data[tid] = data[tid] * 2.0f;
    }
}
四、实战项目
4.1 向量加法
向量加法是CUDA编程的"Hello World",完美展示了并行计算的威力。
CPU实现(串行):
void vector_add_cpu(float *a, float *b, float *c, int n) {
    for (int i = 0; i < n; i++) {
        c[i] = a[i] + b[i];
    }
}
GPU实现(并行):
__global__ void vector_add_gpu(float *a, float *b, float *c, int n) {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;

    if (tid < n) {
        c[tid] = a[tid] + b[tid];
    }
}
完整示例代码:
#include <stdio.h>
#include <cuda_runtime.h>

#define N 1048576  // 1M个元素
#define BLOCK_SIZE 256

__global__ void vector_add_gpu(float *a, float *b, float *c, int n) {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;
    if (tid < n) {
        c[tid] = a[tid] + b[tid];
    }
}

int main() {
    float *h_a, *h_b, *h_c;  // Host数组
    float *d_a, *d_b, *d_c;  // Device数组

    size_t size = N * sizeof(float);

    // 分配Host内存
    h_a = (float*)malloc(size);
    h_b = (float*)malloc(size);
    h_c = (float*)malloc(size);

    // 初始化数据
    for (int i = 0; i < N; i++) {
        h_a[i] = i * 1.0f;
        h_b[i] = i * 2.0f;
    }

    // 分配Device内存
    cudaMalloc(&d_a, size);
    cudaMalloc(&d_b, size);
    cudaMalloc(&d_c, size);

    // Host to Device
    cudaMemcpy(d_a, h_a, size, cudaMemcpyHostToDevice);
    cudaMemcpy(d_b, h_b, size, cudaMemcpyHostToDevice);

    // 启动kernel
    int gridSize = (N + BLOCK_SIZE - 1) / BLOCK_SIZE;
    vector_add_gpu<<<gridSize, BLOCK_SIZE>>>(d_a, d_b, d_c, N);

    // Device to Host
    cudaMemcpy(h_c, d_c, size, cudaMemcpyDeviceToHost);

    // 验证结果
    bool correct = true;
    for (int i = 0; i < N; i++) {
        if (fabs(h_c[i] - (h_a[i] + h_b[i])) > 1e-5) {
            correct = false;
            break;
        }
    }
    printf("结果验证: %s\n", correct ? "正确" : "错误");

    // 清理内存
    free(h_a); free(h_b); free(h_c);
    cudaFree(d_a); cudaFree(d_b); cudaFree(d_c);

    return 0;
}
性能对比数据:
| 数组大小 | CPU耗时 | GPU耗时 | 加速比 |
|---|---|---|---|
| 1K | 0.002ms | 0.05ms | 0.04x |
| 1M | 2.1ms | 0.12ms | 17.5x |
| 10M | 21.3ms | 0.35ms | 60.8x |
| 100M | 215ms | 2.8ms | 76.8x |
加速比分析:
- 小数据量时GPU性能不佳,因为kernel启动开销和内存传输成本较高
- 随着数据量增加,GPU并行优势逐渐显现
- 100M数据时达到了76倍加速,充分体现了并行计算的威力
4.2 矩阵运算
矩阵乘法是更复杂的2D问题,需要使用2D Grid配置。
问题定义:
计算 C = A × B,其中:
- A: M × K 矩阵
- B: K × N 矩阵
- C: M × N 矩阵
2D Grid配置策略:
dim3 blockDim(16, 16);  // 每个Block为16×16=256个线程
dim3 gridDim((N + 15) / 16, (M + 15) / 16);
Kernel实现:
__global__ void matrix_mul(float *A, float *B, float *C,
                          int M, int K, int N) {
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;

    if (row < M && col < N) {
        float sum = 0.0f;
        for (int k = 0; k < K; k++) {
            sum += A[row * K + k] * B[k * N + col];
        }
        C[row * N + col] = sum;
    }
}
完整代码:
#include <stdio.h>
#include <cuda_runtime.h>
#include <string>
#include <device_launch_parameters.h>
#include <chrono>

#define BLOCK_SIZE 16

using namespace std::chrono;

// GPU版矩阵乘法kernel
__global__ void matrix_mul(float* A, float* B, float* C,
	int M, int K, int N) {
	int row = blockIdx.y * blockDim.y + threadIdx.y;
	int col = blockIdx.x * blockDim.x + threadIdx.x;

	if (row < M && col < N) {
		float sum = 0.0f;
		for (int k = 0; k < K; k++) {
			sum += A[row * K + k] * B[k * N + col];
		}
		C[row * N + col] = sum;
	}
}

// CPU版矩阵乘法
void matrix_mul_cpu(float* A, float* B, float* C, int M, int K, int N) {
	for (int row = 0; row < M; row++) {
		for (int col = 0; col < N; col++) {
			float sum = 0.0f;
			for (int k = 0; k < K; k++) {
				sum += A[row * K + k] * B[k * N + col];
			}
			C[row * N + col] = sum;
		}
	}
}

void test_matrix_size(int M, int K, int N) {
	size_t size_A = M * K * sizeof(float);
	size_t size_B = K * N * sizeof(float);
	size_t size_C = M * N * sizeof(float);

	// 分配Host内存并初始化
	float* h_A = (float*)malloc(size_A);
	float* h_B = (float*)malloc(size_B);
	float* h_C_gpu = (float*)malloc(size_C);
	float* h_C_cpu = (float*)malloc(size_C);

	for (int i = 0; i < M * K; i++) h_A[i] = rand() / (float)RAND_MAX;
	for (int i = 0; i < K * N; i++) h_B[i] = rand() / (float)RAND_MAX;

	// ========== CPU版本 ==========
	auto cpu_start = high_resolution_clock::now();
	matrix_mul_cpu(h_A, h_B, h_C_cpu, M, K, N);
	auto cpu_end = high_resolution_clock::now();
	auto cpu_duration = duration_cast<microseconds>(cpu_end - cpu_start);
	double cpu_time = cpu_duration.count() / 1000.0; // 转换为毫秒

	// ========== GPU版本 ==========
	// 分配Device内存
	float* d_A, * d_B, * d_C;
	cudaMalloc(&d_A, size_A);
	cudaMalloc(&d_B, size_B);
	cudaMalloc(&d_C, size_C);

	// 拷贝数据到GPU
	cudaMemcpy(d_A, h_A, size_A, cudaMemcpyHostToDevice);
	cudaMemcpy(d_B, h_B, size_B, cudaMemcpyHostToDevice);

	// 配置Grid和Block
	dim3 blockDim(BLOCK_SIZE, BLOCK_SIZE);
	dim3 gridDim((N + BLOCK_SIZE - 1) / BLOCK_SIZE,
		(M + BLOCK_SIZE - 1) / BLOCK_SIZE);

	// 创建CUDA Event用于计时
	cudaEvent_t start, stop;
	cudaEventCreate(&start);
	cudaEventCreate(&stop);

	// 开始GPU计时
	cudaEventRecord(start);

	// 执行kernel
	matrix_mul << <gridDim, blockDim >> > (d_A, d_B, d_C, M, K, N);

	// 结束GPU计时
	cudaEventRecord(stop);
	cudaEventSynchronize(stop);

	// 获取GPU时间
	float gpu_time;
	cudaEventElapsedTime(&gpu_time, start, stop);

	// 拷贝结果回CPU
	cudaMemcpy(h_C_gpu, d_C, size_C, cudaMemcpyDeviceToHost);

	// 验证结果
	bool correct = true;
	for (int i = 0; i < M * N && i < 100; i++) {
		if (abs(h_C_cpu[i] - h_C_gpu[i]) > 1e-3) {
			correct = false;
			break;
		}
	}

	// 计算加速比
	double speedup = cpu_time / gpu_time;

	// 打印结果
	printf("%-15s %-20.3f %-25.3f %.2fx%-12s %s\n",
		(std::to_string(M) + "x" + std::to_string(K) + "x" + std::to_string(N)).c_str(),
		cpu_time,
		gpu_time,
		speedup, "",
		correct ? "OK" : "FAIL");

	// 清理
	free(h_A); free(h_B); free(h_C_gpu); free(h_C_cpu);
	cudaFree(d_A); cudaFree(d_B); cudaFree(d_C);
	cudaEventDestroy(start); cudaEventDestroy(stop);
}

int main() {
	printf("=== 矩阵乘法性能对比 (CPU vs GPU) ===\n\n");
	printf("%-15s %-20s %-25s %-15s %s\n",
		"矩阵大小", "CPU耗时(ms)", "GPU耗时(基础版)(ms)", "加速比", "验证");
	printf("────────────────────────────────────────────────────────────────────────────────\n");

	// 测试不同大小的矩阵
	test_matrix_size(128, 128, 128);
	test_matrix_size(256, 256, 256);
	test_matrix_size(512, 512, 512);
	test_matrix_size(1024, 1024, 1024);
	test_matrix_size(2048, 2048, 2048);

	printf("\n=== 测试完成 ===\n");

	return 0;
}
性能测试结果:
| 矩阵大小 | CPU耗时 | GPU耗时(基础版) | 加速比 |
|---|---|---|---|
| 128x128x128 | 4.336ms | 0.123ms | 35.29 |
| 256×256x256 | 30.614ms | 0.189ms | 161.68 |
| 512×512x512 | 249.207ms | 0.497ms | 501.27 |
| 1024×1024x1024 | 2.916s | 3.246ms | 898.24 |
| 2048×2048x2048 | 45.333s | 235.93ms | 192.15 |
五、性能对比与分析
综合性能数据
通过向量加法和矩阵乘法的实验,我总结了以下性能规律:
数据量与加速比关系:
加速比
  │
80│                            ●
  │                        ●
60│                    ●
  │                ●
40│            ●
  │        ●
20│    ●
  │●
 0└────────────────────────────> 数据量
  1K  1M  10M 100M
关键发现
-
临界点效应:数据量小于10K时,GPU性能不如CPU,因为:
- Kernel启动开销(约50-100μs)
- 内存传输延迟
- GPU利用率不足
-
线性加速区域:10K-10M数据量时,加速比与数据量近似线性关系
-
饱和效应:超过100M数据量后,受限于:
- 显存带宽瓶颈
- 全局内存访问延迟
- SM(流多处理器)饱和
优化空间
当前实现是最基础的版本,还有巨大的优化空间:
- 共享内存(Shared Memory):矩阵乘法可以通过shared memory减少全局内存访问
- 内存合并(Memory Coalescing):优化内存访问模式
- Bank冲突避免:shared memory访问优化
- 循环展开:减少循环开销
- 流并发:使用CUDA Stream重叠计算和传输
这些优化技术将是我Week 2-3的学习重点。
六、遇到的坑
1. 编译环境问题
问题描述:
初次配置VS2022时,项目无法识别CUDA编译器。
解决方案:
- 确保安装了CUDA Toolkit后重启Visual Studio
- 检查项目属性 → CUDA C/C++ → Device → Code Generation是否设置正确
- 我的GPU是RTX 4060(计算能力8.9),需要设置为
compute_89,sm_89
2. 内存拷贝方向错误
问题描述:
第一次写向量加法时,误将cudaMemcpyDeviceToHost写成了cudaMemcpyHostToDevice,导致结果全是随机值。
教训:
- 严格遵守数据流动方向
- 使用有意义的变量命名(如
h_前缀表示Host,d_前缀表示Device) - 每次内存操作后检查
cudaGetLastError()
检查代码模板:
cudaError_t err = cudaMemcpy(d_a, h_a, size, cudaMemcpyHostToDevice);
if (err != cudaSuccess) {
    printf("CUDA Error: %s\n", cudaGetErrorString(err));
    return -1;
}
3. 边界检查的重要性
问题描述:
处理不规则数据量时忘记边界检查,导致访问越界,程序崩溃。
错误代码:
__global__ void bad_kernel(float *data, int n) {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;
    data[tid] = data[tid] * 2.0f;  // 可能越界!
}
正确做法:
__global__ void good_kernel(float *data, int n) {
    int tid = blockIdx.x * blockDim.x + threadIdx.x;
    if (tid < n) {  // 边界检查
        data[tid] = data[tid] * 2.0f;
    }
}
Grid Size计算公式:
int gridSize = (N + blockSize - 1) / blockSize; // 向上取整
七、学习心得
从0到1的过程
这一周的学习让我深刻体会到:
-
理论与实践的差距:看懂概念和写出能跑的代码完全是两回事。我反复修改向量加法代码,从最初的编译错误到结果验证通过,花了整整一个下午。
-
Debug的重要性:CUDA的错误信息不如CPU程序直观。学会使用
cuda-memcheck和nsight工具是必须的。 -
性能思维的转变:传统CPU编程关注算法复杂度,GPU编程更关注内存访问模式、线程组织、occupancy等指标。
学习方法总结
有效的学习路径:
- 官方文档为主:NVIDIA的《CUDA C Programming Guide》是最权威的资料
- 代码实践为王:每个概念都要亲手实现一遍
- 性能测量驱动:每次优化都要测量性能变化
- 循序渐进:从1D到2D,从简单到复杂
推荐资源:
- 《CUDA编程:基础与实践》(樊哲勇)
- NVIDIA官方博客的优化技巧系列
- GitHub上的cuda-samples仓库
后续计划
Week 2-3计划:
- 深入学习Shared Memory优化
- 实现矩阵乘法的Tiled版本
- 学习Bank冲突避免技巧
- 研究内存访问模式优化
Week 4-5计划:
- Stream并发编程
- 原子操作和同步原语
- Warp级别的优化
- 开始阅读Flash Attention的CUDA实现
八、总结
Week 1收获清单
✅ 技术能力:
- 掌握CUDA基本编程模型(Grid/Block/Thread)
- 熟悉内存管理和数据传输流程
- 能够独立实现简单的并行算法
- 理解GPU并行计算的性能特点
✅ 实战项目:
- 完成向量加法的CPU/GPU对比实现
- 实现基础版矩阵乘法kernel
- 积累了性能测试和分析经验
✅ 思维转变:
- 建立了并行计算的思维模式
- 理解了计算密集型和内存密集型任务的差异
- 认识到优化的重要性和复杂性
代码仓库
完整代码已上传至GitHub:
- 仓库地址:https://github.com/eagle51/cuda-learning
- 包含所有示例代码和性能测试脚本
- 每个项目都有详细的README说明
下周计划
主要目标:
- 矩阵乘法的Shared Memory优化(目标:性能提升5-10倍)
- 理解Bank Conflict的原理和避免方法
- 实现一个可配置的性能测试框架
学习资源:
- 《CUDA C Programming Guide》第3-5章精读
- NVIDIA博客:Optimizing Matrix Multiplication
- 参考cuBLAS的实现思路
预期产出:
- 优化版矩阵乘法代码
- 性能分析报告
- 第二篇技术博客
感想:
这一周的学习虽然辛苦,但收获满满。从一个CUDA零基础的C++工程师,到能够独立实现基础的GPU并行算法,这个过程让我更加确信了转型AI Infrastructure的决心。
GPU编程打开了我对计算机体系结构认识的新维度。当看到100M数据的向量加法在GPU上只需要2.8ms,而CPU需要215ms时,那种震撼是难以言表的。这就是并行计算的魅力!
路漫漫其修远兮,吾将上下而求索。接下来的7个月,我会继续在这条道路上深耕,期待在推理优化和AI系统方向能有所建树。
感谢每一位读到这里的朋友,欢迎交流讨论!
本文是《CUDA学习之路》系列的第一篇,敬请期待后续更新。
关键词: CUDA编程、GPU并行计算、向量加法、矩阵乘法、AI Infrastructure、性能优化
 538


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


