


想让程序「看见」世界,很多人第一反应是:接个摄像头,再写一堆读图、滤波、画框的代码。
真动手才发现——像素格式、色彩空间、相机驱动、编解码、跨平台……每一项都像在重新发明轮子。
OpenCV(Open Source Computer Vision Library) 就是冲着这件事来的:一套开源、偏实时的计算机视觉库,帮你把「读图 → 处理 → 识别 → 画结果」做成可调用的积木,而不是从零抠像素。
- 官网:opencv.org
- 文档:docs.opencv.org
- 源码:github.com/opencv/opencv(约 9 万+ stars)
- 许可:4.5 起多为 Apache 2.0(更早版本多为 BSD,以官方说明为准)
一、它到底解决什么痛点
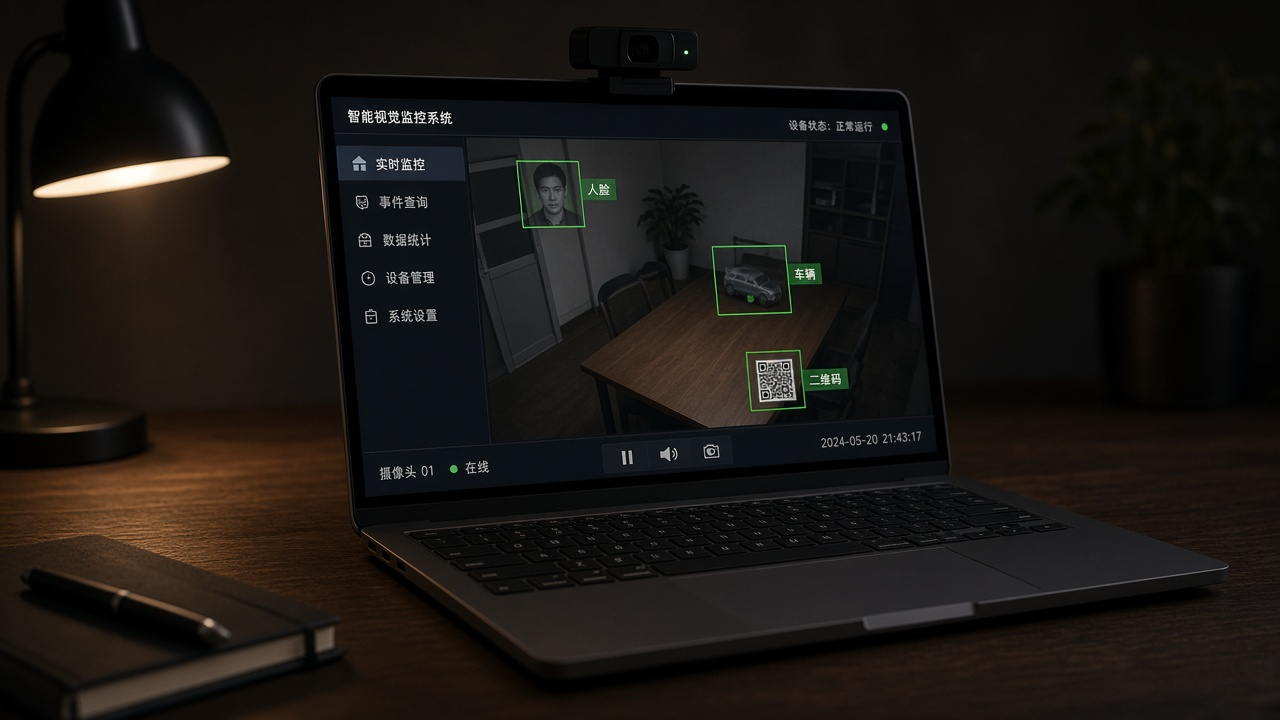
没有 OpenCV 的年代(以及现在仍有人硬刚的方式),常见路径是:
- 自己读 BMP / JPEG:格式多、坑多,还没开始做算法就先摔在 IO 上
- 手写滤波 / 边缘:能写,但慢、难优化、难跨平台
- 只靠肉眼看监控 / 照片:人累、漏检、难规模化
- 直接上重型深度学习框架:能认复杂目标,但启动成本高,简单任务杀鸡用牛刀
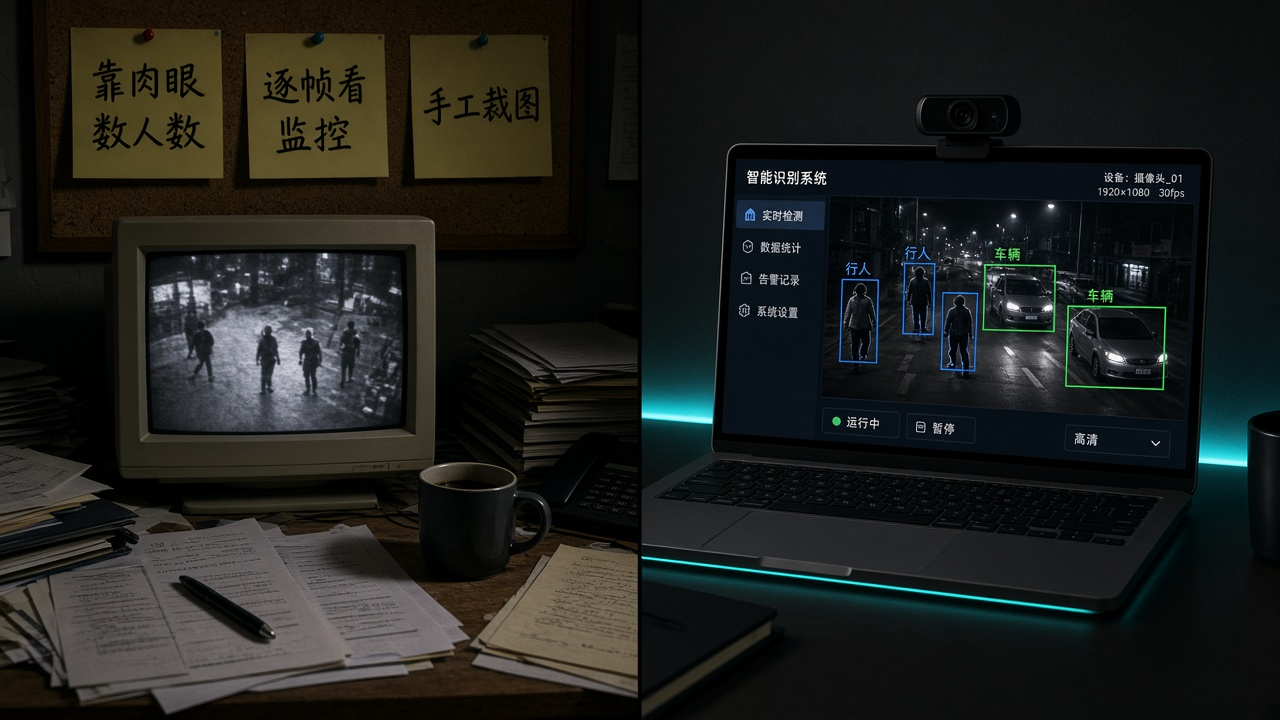
OpenCV 换了思路:先把图像与视频的基础能力做成稳定 API——读摄像头、颜色转换、滤波、轮廓、特征点、模板匹配、二维码、部分经典检测与跟踪,以及和现代 DNN 模型对接的入口。
它不保证「装上就能替代所有 AI 视觉产品」,但比「从零抠每一行像素」更贴近真实工程:做个扫码枪 demo、缺陷检测原型、机器人找色块,往往几天就能跑起来。
二、三个常见误解
误解 1:OpenCV 就是「深度学习 / YOLO」。
不是。OpenCV 核心是计算机视觉基础库。你可以用它做传统图像处理,也可以通过 DNN 模块加载 ONNX 等模型做推理;但「装了 OpenCV ≠ 自动拥有最新大模型」。很多视觉系统里,它常常负责解码、画框、预处理;检测器可以是别的模型或服务。
误解 2:装上 OpenCV 就能替代所有视觉方案。
场景不同。OpenCV 强在 PC、工控机、树莓派一类能跑完整系统的平台,适合自己写算法、接业务。极低功耗的专用相机板、交钥匙的闭源视觉套件、整机监控产品——各自有各自的赛道,别指望一个库包打天下。
误解 3:pip install opencv-python 就等于学会了。
安装只是第一步。相机曝光、光照、畸变、误检、帧率与延迟,才是上线后真正耗时间的地方。库降低的是门槛,不是物理世界的难度。
三、技术架构:从像素到应用
可以把 OpenCV 想成四层积木(概念上):
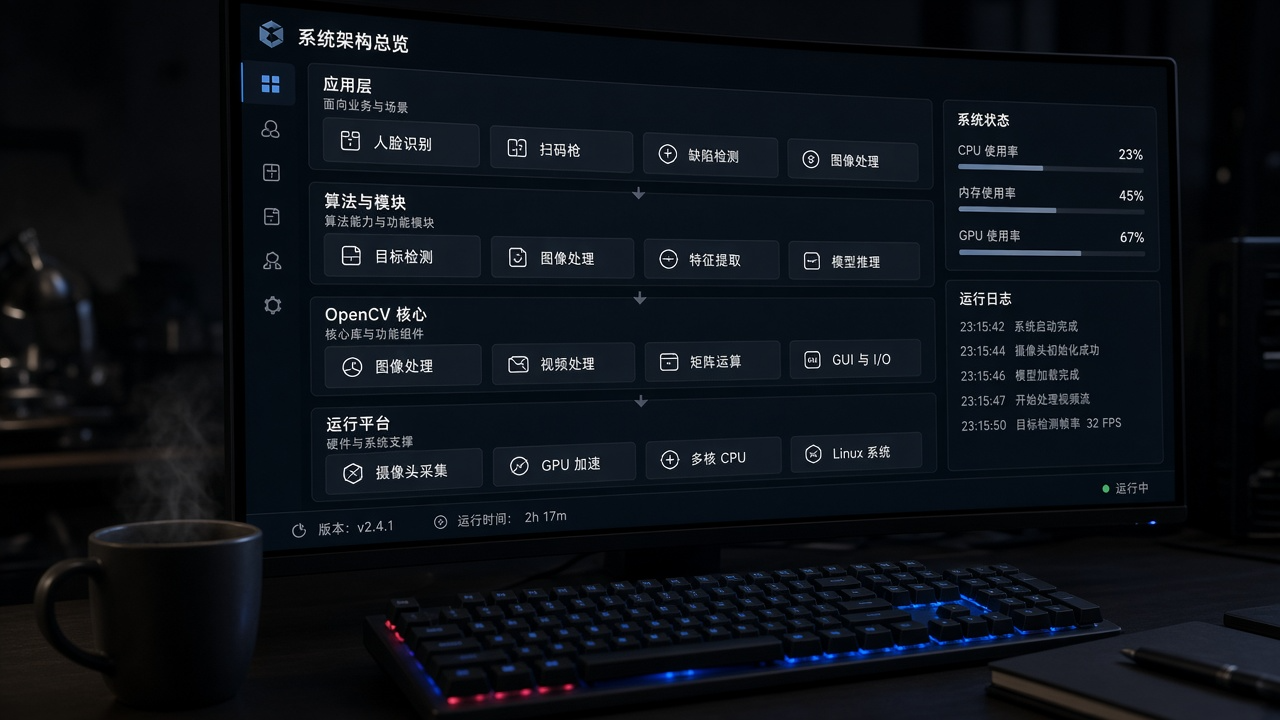
- 应用:业务结果——人脸门禁、扫码、缺陷检测、巡线小车
- 算法与模块:处理与识别——滤波、特征、匹配、跟踪、DNN 推理
- 核心:数据与 IO——
Mat图像矩阵、摄像头、编解码、绘图 - 平台:跑在哪——Windows / Linux / Android / 嵌入式;可选 CPU / GPU 加速
简化流程往往是:
摄像头 / 图片 → 读入与预处理 → 特征或检测 → 画框 / 决策 → 控制或告警
对做过嵌入式或网关的人来说,这很像「采集 → 协议解析 → 策略 → 执行」——只是载体从报文换成了像素。
上手时真正会碰到的,多半是这几块:
- 读图 / 读摄像头
imread、VideoCapture——先保证「看得见」,再谈算法。 - 色彩与滤波
BGR / HSV、高斯模糊、形态学——工业现场一半问题出在光照和噪声。 - 轮廓、特征、匹配
找形状、对齐模板、拼图、简单定位。 - 检测与 DNN
经典 cascade / HOG,或加载外部模型做目标检测——按任务选,别一上来就全上最重的。
四、适合谁,不适合谁
适合:
- 想在 PC / 工控机 / 树莓派上快速验证视觉方案
- 做扫码、测距辅助、色块跟踪、简单缺陷检测、教学实验
- 需要跨语言(C++ / Python / Java 等)和跨平台的同一套思路
- 愿意自己调参、自己接业务逻辑,而不是只买闭源视觉套件
不太适合:
- 只想「买个摄像头 App,点几下就认万物」——那是成品产品,不是库
- 必须在极低功耗 MCU 上跑、又不想碰完整操作系统——更适合专用视觉模组 / 板卡
- 要求开箱即用、零误检的安防 / 医疗级认证产品——库只是原材料
五、怎么动手
- 选语言:入门多用 Python(
opencv-python);要性能与嵌入式集成再上 C++。 - 装环境:确认 Python / 系统包版本;摄像头权限在 Linux 上常要额外开。
- 先跑通三件事:打开图片、打开摄像头、在画面上画矩形。
- 再选一个小目标:认二维码、跟色块、数轮廓——比空学 API 列表有用。
- 需要更强算法时:看官方教程与
opencv_contrib;深度学习模型用 DNN 或外部框架,OpenCV 负责前后处理。 - 上板 / 上产线前:固定镜头与光照,记版本号,别让「本机能跑、现场全花」成为默认结局。
最小心理模型:
图像进门 → 变成矩阵 → 调模块 → 得到坐标 / 类别 / 掩膜 → 你的业务接着干
六、优点与局限
优点:
- 生态大、文档与示例多,搜得到坑
- 传统 CV 与 DNN 入口都有,能从小到大演进
- 跨平台,产学研都在用,简历和项目里都「说得清」
- 和机器人、工控、监控栈容易拼(很多开源项目底层都摸得到它)
局限:
- API 面宽,新手容易迷路——建议「任务驱动」而不是「通读手册」
- 不是端到端业务产品:存储、权限、告警、UI 要自己接
- 复杂场景仍依赖好模型、好数据、好部署;OpenCV 帮不到「数据本身很烂」
- 版本与编译选项(GPU、contrib)不一致时,换机器会踩坑
七、和相关方案怎么选
- OpenCV:通用视觉库——处理、检测、跟踪、和模型对接
- 从零手写:极致可控,但 IO / 算法 / 跨平台成本高
- 闭源视觉 SDK:交钥匙快,但贵、难改、难审计
- 深度学习框架:训练与重推理;常和 OpenCV 做前后处理搭配
- 成品视觉产品:开箱即用,规则与数据路径由厂商决定
八、收尾
如果你已经接受「程序可以读写文件、收发包」,那下一步很自然:
程序能不能也「看见」摄像头里的世界?
OpenCV 给出的答案是:用开源的方式,把读图、处理、检测做成可复用的积木——算法在社区里演进,接口在你代码里调用,像素仍先经过你的机器。
它不是神器,但它把一件很多闭源 SDK 说得很贵的事,做成了全球开发者都能装、能改、能教的机器视觉底座。


 扫一扫


 1315

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


