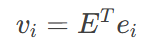
allein_STR
码龄9年
求更新 关注
提问 私信
  • 博客:498,473
    社区:1,440
    动态:171
    500,084
    总访问量
  • 217
    原创
  • 9,082
    粉丝
  • 82
    关注
IP属地以运营商信息为准,境内显示到省(区、市),境外显示到国家(地区)
IP 属地:北京市
加入CSDN时间: 2017-08-14

个人简介:双一流交叉学科,机器学习/深度学习模型实现,20+篇SCI 1/2区top论文,授权专利15件,软著2个。可辅导/修改/润色SCI论文、提供代码支持、承接交叉项目。

博客简介:

allein_STR的博客

查看详细资料
个人成就
  • 获得549次点赞
  • 内容获得184次评论
  • 获得2,524次收藏
  • 代码片获得3,310次分享
  • 博客总排名13,003名
  • 原力等级
    原力等级
    6
    原力分
    2,318
    本月获得
    3
创作历程
  • 11篇
    2026年
  • 12篇
    2025年
  • 43篇
    2023年
  • 34篇
    2022年
  • 49篇
    2021年
  • 36篇
    2020年
  • 37篇
    2019年
  • 29篇
    2018年
  • 14篇
    2017年
成就勋章
TA的专栏
  • 机器学习/深度学习
    付费
    90篇
  • WRF/WPS
    付费
    8篇
  • 【前沿】前沿文章解读
    6篇
  • 【论文+代码】交叉项目研究
    2篇
  • AI交叉论文写作
    2篇
  • 文件处理
    2篇
  • 【附代码】python绘图相关
    10篇
  • 时序相关
    11篇
  • 统计学
    8篇
  • 数据挖掘
    6篇
  • CCUS
    1篇
  • 杂七杂八
    5篇
  • Android
    10篇
  • Java
    11篇
  • linux
    3篇
  • 文学
    3篇
  • MySQL
    2篇
  • 风云卫星
    3篇
  • uc/os-ii
    24篇
  • 蓝桥杯_算法训练
    15篇
  • opengl
    3篇
  • OS
    1篇
  • bootloader
    3篇
  • 微信小程序
    5篇
  • python
    68篇
  • SCI
    7篇
  • bug
    14篇

TA关注的专栏 0

TA关注的收藏夹 0

TA关注的社区 5

TA参与的活动 1

兴趣领域 设置
  • 人工智能
    数据挖掘机器学习人工智能深度学习神经网络tensorflowkeras数据分析集成学习迁移学习
创作活动更多

【多重好礼】鸿蒙心迹 · 开发录原创征稿活动

鸿蒙开发者的实战经验,值得被记录。从踩坑排查到项目复盘,从工具脚本到学习笔记,每一段真实的开发经历,都是社区最宝贵的技术资产。「鸿蒙心迹 · 开发录」正式启航,不限主题、随时可写,只要是鸿蒙开发相关的真实经验都欢迎投稿。 本活动为 [HarmonyOS 7.0 创新内容共创季](https://builderx.csdn.net/activity-site/harmonyos/activity2026)双轨征文之一,与[「共创季 · 稿事节」](https://harmonyosdev.csdn.net/6a97f0de2b83d06f0ecadec5.html)深度征文互补——「稿事节」写深度技术长文,「开发录」写日常开发实战笔记。 「开发录」每月一期,12月截止,本季共三期,投稿即有机会获得京东卡、CSDN博客流量券、亿万Token、社区定制周边好礼!

126人参与 去参加
  • 最近
  • 文章
  • 专栏
  • 代码仓
  • 资源
  • 收藏
  • 关注/订阅/互动
更多
  • 最近

  • 文章

  • 专栏

  • 代码仓

  • 资源

  • 收藏

  • 关注/订阅/互动

  • 社区

  • 帖子

  • 问答

  • 课程

  • 视频

搜索 取消

TiMi:让时间序列Transformer“听懂”人话的多模态混合专家模型

场景类型是否适合说明有外部文本信息(新闻/报告/公告)✅ 强烈推荐TiMi的核心优势纯数值预测(无文本)⚠️ 可用但不必要相当于SMoE在起作用不规则时间间隔数据✅ 适合文本和时序分开建模需要预测可解释性✅ 适合SMoE专家选择可追踪资源受限(无A100 GPU)⚠️ 需权衡需要运行7B LLMTiMi的核心贡献是改变了多模态时序预测的“游戏规则”——从“让文本和数字对齐”转向“用文本推理结果指导数字预测”。
原创
博文更新于 2026.07.10 ·
413 阅读 ·
10 点赞 ·
0 评论 ·
5 收藏

PhysicsFormer:让时间序列模型学会“物理直觉”

论文《Benchmarking Physics-Informed Time-Series Models for Operational Global Station Weather Forecasting》提出全球最大开源站点天气数据集WEATHER-5K(5,672站点,10年,40GB),填补了时间序列天气预报(TSF)领域的数据空白。研究发现:1)纯数据驱动TSF模型在整体精度(如温度MAE差28%)和极端事件预测(SEDI指标低50%以上)上显著落后于数值天气预报(NWP);2)融入物理约束
原创
博文更新于 2026.07.09 ·
457 阅读 ·
17 点赞 ·
0 评论 ·
6 收藏

TiMi:让时间序列Transformer“听懂”人话,多模态混合专家模型

场景类型是否适合说明有外部文本信息(新闻/报告/公告)✅ 强烈推荐TiMi的核心优势纯数值预测(无文本)⚠️ 可用但不必要相当于SMoE在起作用不规则时间间隔数据✅ 适合文本和时序分开建模需要预测可解释性✅ 适合SMoE专家选择可追踪资源受限(无A100 GPU)⚠️ 需权衡需要运行7B LLMTiMi的核心贡献是改变了多模态时序预测的“游戏规则”——从“让文本和数字对齐”转向“用文本推理结果指导数字预测”。
原创
博文更新于 2026.07.09 ·
23 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

11种数据降维方法-代码与结果.rar

发布资源 2026.07.08 ·
rar

蚂蚁集团开源QuitoBench:时间序列预测的“照妖镜”

蚂蚁集团开源QuitoBench时间序列预测基准,解决了当前评测体系三大痛点:领域分类不合理、数据分布偏斜和数据泄露问题。该基准基于17亿真实数据点,创新性地按趋势强度、季节性和可预测性(TSF)划分8类序列,实现均衡评估。评测涵盖10个模型(深度学习、基础模型和统计方法),通过23万次实验得出关键结论:1)上下文长度决定模型选择(短序列选深度学习,长序列选基础模型);2)可预测性是预测难度的核心指标;3)数据规模比模型规模更重要。研究显示,1M参数的CrossFormer在多数场景下优于百倍参数的
原创
博文更新于 2026.07.08 ·
25 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

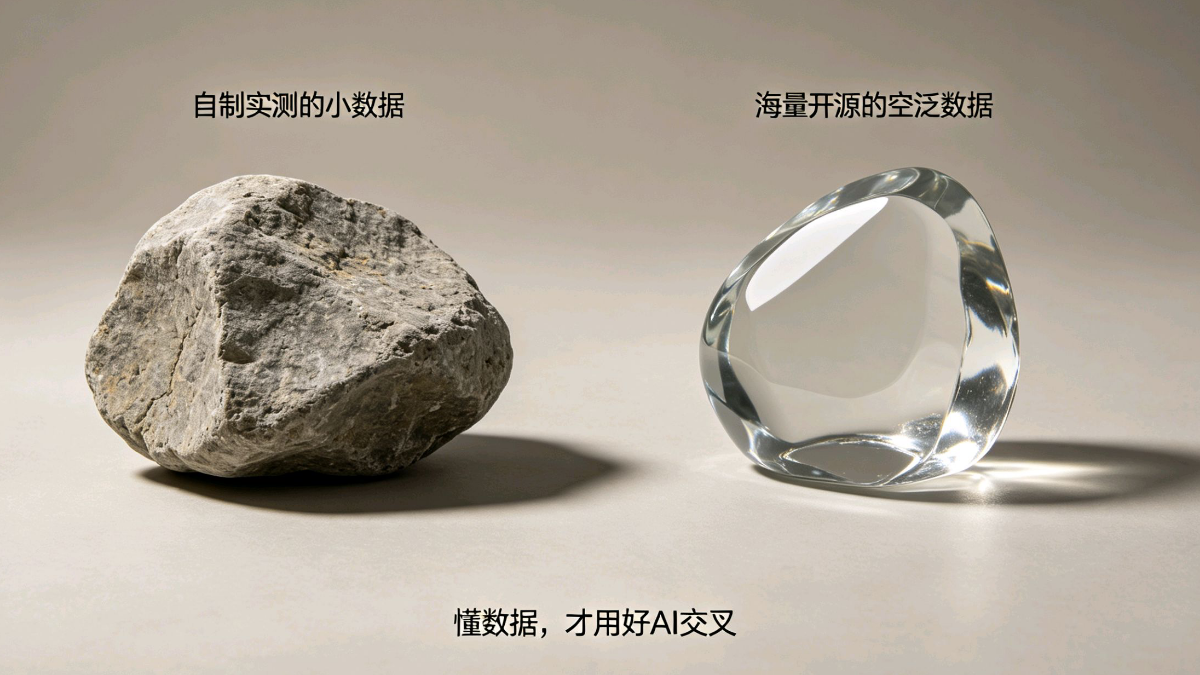
小数据怎么做AI交叉

第二种:用自己的几十组实验数据,用一个简单的方法,但把数据背后的物理背景、实验条件、误差范围都讲清楚了。这恰恰是小数据研究的优势——你比谁都清楚你的数据是怎么来的、有什么限制。另一种思路是:先用一个简单的模型,看看数据里有什么规律,然后用这个规律去指导下一步实验,拿到新数据再更新模型。你的数据不是用来“训一个万能模型”的,是用来“帮你做下一步决策”的。AI交叉研究,比的从来不是谁的数据多。你的数据是实验来的,是有成本的、有时间窗的、有物理背景的。因为审稿人看的不是你的数据有多少,是你有没有把你的数据用透。
原创
博文更新于 2026.06.04 ·
713 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

【审稿人思维】审稿人怎么看出来你用AI的?

你有没有这种经历:用AI大模型给你写了一段话,读着挺顺,语法没毛病,逻辑也没断。你检查了一遍,觉得没问题,放进论文里。导师看了一眼,说:“这是AI写的吧?你心里不服:哪里像了?然后你投出去。等了两个月,收到拒稿信。审稿人写了一条意见:“语言流畅但内容空洞,缺乏深度,建议作者认真修改。你开始怀疑:是不是我写得不够好?还是审稿人就是不喜欢AI?都不是。。这两个动作,差很多。先看一段真实的AI生成文字这是一段典型的学生作业。
原创
博文更新于 2026.06.03 ·
229 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

手把手教你使用SHAP(机器学习模型解释工具)

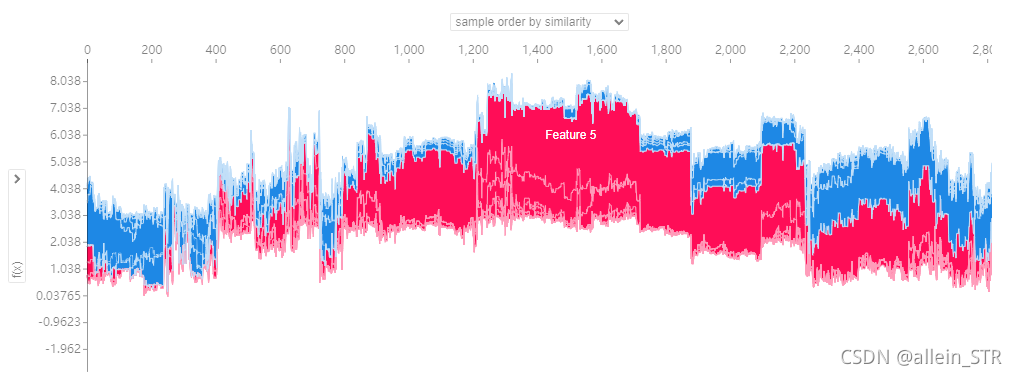
目录SHAP简介SHAP优点:缺点应用方法SHAP简介SHAP(SHapleyAdditive exPlanation)是解决模型可解释性的一种方法。SHAP基于Shapley值,该值是经济学家Lloyd Shapley提出的博弈论概念。“博弈”是指有多个个体,每个个体都想将自己的结果最大化的情况。 该方法为通过计算在合作中个体的贡献来确定该个体的重要程度。SHAP优点:解决了多重共线性问题 不仅考虑单个变量的影响,而且考虑变量之间的协同效应缺点...
原创
博文更新于 2026.06.03 ·
3725 阅读 ·
2 点赞 ·
24 评论 ·
14 收藏

【Transformer拆解】-7.编码器-解码器注意力(Cross-Attention)和输出层(Linear + Softmax)

编码器-解码器注意力是Transformer架构中连接编码器和解码器的核心机制,用于实现。让解码器动态关注编码器的输出(如翻译时对齐源语言和目标语言的位置)。:解码器的 Query 与编码器的 Key、Value 交互。允许解码器在生成每个目标词时,动态检索编码器输出的相关信息。生成当前目标位置(如"产量")的Query向量。:来自解码器的当前状态(询问需要什么信息)将模型的高维表示转换为具体的单词预测。:来自编码器的输出(提供源序列信息):井A的测井曲线序列。:预测井B的生产参数。
原创
博文更新于 2026.06.03 ·
41 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

【Transformer拆解】-5. 前馈神经网络(FFN)和解码器的掩码自注意力(Masked Self-Attention)

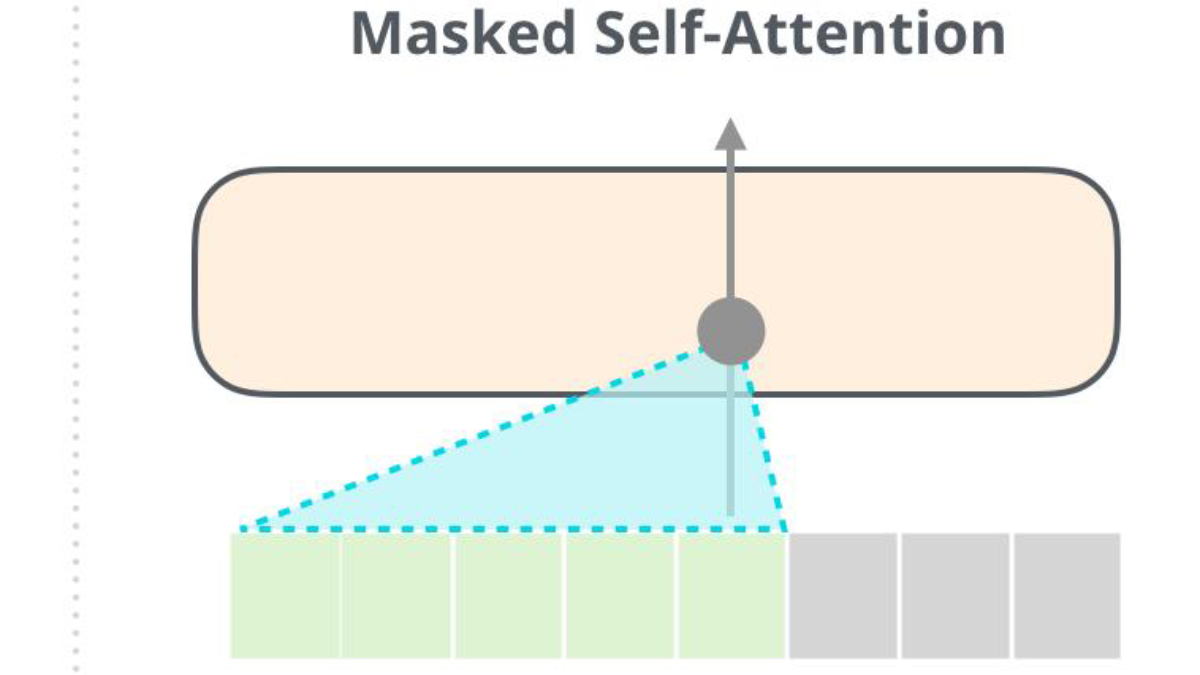
在解码器的自注意力中,将未来位置的注意力分数设为 −∞−∞(通过掩码实现)。生成"主阀"时,模型可能利用"保持5分钟"的信息,导致训练与推理不一致。强制模型仅根据已生成的部分序列(["开启", "主阀"])预测下一个词。确保解码器只能依赖已生成的标记(防止作弊),符合自回归生成的需求。,避免"偷看"未来未生成的词。在Transformer的解码器中,掩码的核心作用是。独立处理每个位置的信息(类似逐点卷积)。:确保解码器只能看到当前位置及之前的信息。:忽略输入序列中的填充符(如。
原创
博文更新于 2026.06.02 ·
34 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

被拒了4次,我才搞明白审稿人到底想要什么

前几天晚上,一个读博的朋友给我发消息。他说:“我这三个月,Python也学了,DeepSeek也装了,教程看了几十个。但打开自己的论文,还是不知道写啥。同门用AI发了论文,我还在摸模型。我问:“那你卡在哪?他想了一下说:“不知道用什么模型。数据也不够。写出来的东西,导师说像AI写的。我说你这不是一个人。我见过最多的几个卡点每天刷AI新闻,但回到自己的领域就懵了。教程里都是图像分类、情感分析,没人告诉你土木/生信/经济该怎么做。你需要的不是更多的AI知识。
原创
博文更新于 2026.06.02 ·
267 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

【Transformer拆解】-4. 残差连接(Residual Connection)与层归一化(LayerNorm)

即使深层网络F(x)学习失效,模型仍能退化为恒等映射y=x,避免性能退化。:缓解深层网络梯度消失,保留原始信息(参考 ResNet)。实验证明:ResNet-1000层比普通网络训练误差更低。层归一化:对每个样本的特征维度归一化(非批量归一化)。F(x):神经网络层的变换(如线性变换+激活函数):反向传播时梯度需逐层连乘,导致底层梯度指数衰减。:稳定训练过程,减少对批量大小的依赖。:反向传播时梯度可绕过复杂变换。:梯度可通过恒等路径直达底层。:原始输入直接传递到高层。
原创
博文更新于 2026.06.02 ·
235 阅读 ·
3 点赞 ·
0 评论 ·
3 收藏

【Transformer拆解】-3. 自注意力机制(Self-Attention)——以油气领域为例

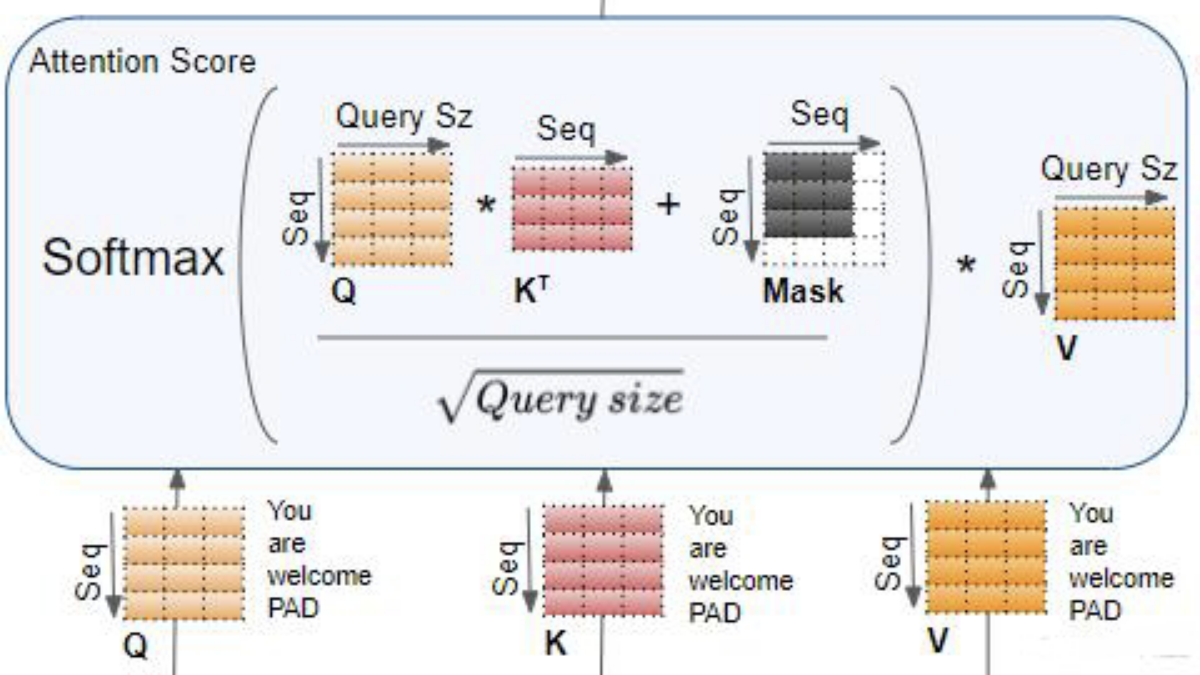
而Q/K/V(Query/Key/Value)机制是其实现自注意力的关键设计。如果没有Q/K/V分离,模型将无法区分“匹配”和“信息传递”两个功能,导致性能下降。每个变换矩阵的维度为dmodel×dk(dk通常=dmodel/h,h=注意力头数):衡量两个词的相关性(如 "apple" 和 "fruit" 的分数较高)。某些任务(如问答)需要更复杂的交互模式,而Q/K/V分离可以提供这种灵活性。虽然多头有h倍Q/K/V矩阵,但dk=dmodel/h保持总参数量不变。
原创
博文更新于 2026.06.02 ·
21 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

【Transformer拆解】-2. 位置编码(Positional Encoding)

这种确定性设计使其在油气领域的长序列处理(如全井段测井分析、跨年产量预测)中展现出显著优势,成为Transformer架构的核心组件之一。由于三角函数在实数域上的周期性,对于任意pos>Ntrainpos>Ntrain​(训练时见过的最大位置),仍能生成有效编码。正弦/余弦函数的周期性允许模型外推到更长序列(相比可学习的位置嵌入更鲁棒)。当i=dmodel/2−1时:λ255≈10000(低频,捕获全局位置)i:维度索引(0≤i<dmodel/20≤i<dmodel​/2)
原创
博文更新于 2025.06.13 ·
367 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

【Transformer拆解】-1. 输入嵌入(Input Embedding)

嵌入层可学习语义信息(类似词向量,如 "king" 和 "queen" 向量方向相近)。"fracture"(裂缝)与"permeability"(渗透率)向量夹角≈30°。:将输入的单词或标记(Token)转换为固定维度的向量(如 512 维)。通过几何结构编码先验知识(如"注水→注气"的向量平移性)将离散的符号(如单词)映射到连续向量空间,便于模型处理。"CO₂"与"EOR"(提高采收率)的余弦相似度>0.7。:相似含义的输入会得到几何上接近的向量表示。每个词wi​的one-hot向量ei​与。
原创
博文更新于 2025.06.09 ·
610 阅读 ·
4 点赞 ·
0 评论 ·
3 收藏

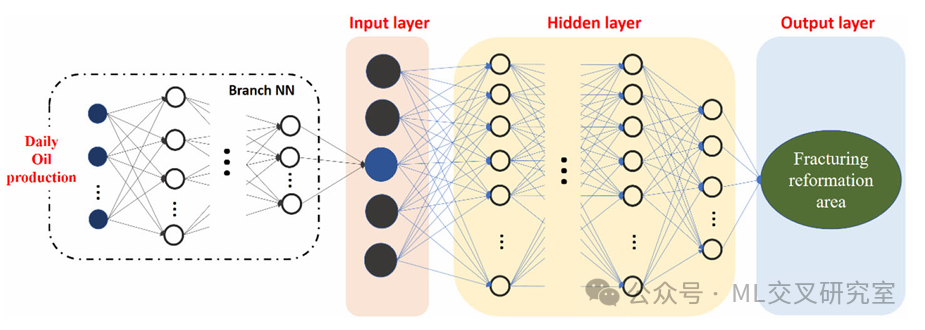
【论文+代码】基于分支网络的水力压裂改造区范围预测

基于分支网络实现动静态数据有机融合,并且实现水力压裂后改造区范围的准确预测。
原创
博文更新于 2025.05.21 ·
570 阅读 ·
10 点赞 ·
0 评论 ·
9 收藏

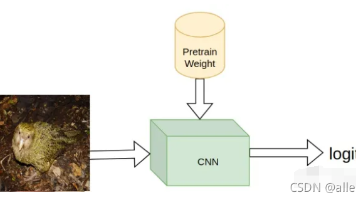
先验知识融合机器学习的几种方式

第一种是把网络的权重替换成一个在另外一个任务上预训练好的模型权重。经过的预训练的模型(如ImageNet预训练)往往已经具备的识别到一些基本的图片pattern的能力,如边缘,纹理,颜色等等,而识别这些信息的能力是识别一副图片的基础。这个思想和迁移学习类似。 第二种是在数据上下功夫。把原始数据的全局特征和局部特征分别训练,然后融合。 第三种是通过注意力机制让模型考虑先验知识:注意力放在鸟头,这就是添加先验信息 基于CAM图激活限制给模型加入先验知识:基于激活图,通过限制激活图的激活区域,加入目标先验。
原创
博文更新于 2025.05.20 ·
1190 阅读 ·
21 点赞 ·
0 评论 ·
26 收藏

【数据分析】常见数据降维技术比较

我们比较了一些降维技术的性能,如奇异值分解(SVD)、主成分分析(PCA)和线性判别分析(LDA)。我们的研究结果表明,方法的选择取决于特定的数据集和手头的任务。对于回归任务,我们发现PCA通常比SVD表现得更好。在分类的情况下,LDA优于SVD和PCA,以及原始数据集。线性判别分析(LDA)在分类任务中始终击败主成分分析(PCA)的这个是很重要的,但这并不意味着LDA在一般情况下是一种更好的技术。
原创
博文更新于 2025.05.20 ·
166 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

RAG(Retrieval-Augmented Generation,检索增强生成)

RAG(Retrieval-Augmented Generation)是一种结合检索与生成的架构,旨在解决传统语言模型在处理需要外部知识任务时的局限性。传统模型依赖预训练数据,难以处理动态或实时信息,且可能产生错误信息。RAG通过检索外部知识库获取相关信息,再结合语言模型生成回答,适用于问答系统、事实核查、实时信息生成等需要准确外部知识的任务。RAG架构包括检索器、向量数据库、生成模型和排序/过滤模块,形成“检索-生成-反馈”链路。其优势包括知识时效性、抗幻觉能力、可解释性和轻量级适配。典型应用场景包括企业
原创
博文更新于 2025.05.19 ·
297 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

CoT(Chain-of-Thought,思维链)推理

CoT(Chain-of-Thought,思维链)推理是一种让大语言模型(LLM)通过分步推导解决问题的方法,模拟人类逐步思考的过程。其核心目标包括复杂问题拆解、可解释性提升和性能优化。CoT的关键组成要素包括问题输入与解析、思维链生成、中间结果整合以及答案生成与验证。实现方式主要有Prompt Engineering、模型训练与微调以及多模态融合。CoT通过分步验证缓解模型幻觉,处理复杂问题,并增强可解释性。典型应用场景包括数学题、逻辑推理、符号推理和真实世界任务。技术原理涉及隐式知识激活、注意力机制和数
原创
博文更新于 2025.05.19 ·
226 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏
加载更多