


《Cache-to-Cache: Direct Semantic Communication Between Large Language Models》提出了一种全新的多LLM通信范式——Cache-to-Cache(C2C),即让大语言模型之间不再通过文本传递信息,而是直接通过KV-Cache进行语义通信。以下是对其研究内容的全面总结。
一、研究背景与动机
1.1 现有多LLM系统的通信瓶颈
现有多LLM系统(如协作式多智能体系统、路由式推理系统)普遍依赖文本到文本(Text-to-Text, T2T) 通信,即一个模型生成文本,另一个模型读取文本。这种方式存在三大固有局限:
-
信息瓶颈:高维内部表示被反复压缩为线性字符串,再由接收方解压缩,导致丰富语义丢失(例如将
<p>误解为章节标记而非段落分隔符)。 -
自然语言模糊性:习语、未充分指定的指代、模糊表达等使得文本难以精确传达专业语义。
-
延迟高:每次交换都需要逐token顺序解码,产生显著的推理延迟。
1.2 核心研究问题
作者提出一个根本性问题:LLM能否超越文本进行通信?
二、核心发现:Oracle实验
作者通过两个Oracle实验验证了KV-Cache作为通信媒介的可行性:
2.1 缓存丰富Oracle(Cache Enrichment Oracle)
-
问题:模型能力能否通过KV-Cache语义丰富得到提升,而不延长序列长度?
-
方法:在示例E和问题X上预填充,但丢弃示例缓存,仅保留问题对齐的切片,使解码使用问题长度的缓存。
-
结论:Oracle设置(62.34%)显著优于Direct(58.42%),证明在不增加缓存大小的前提下,丰富KV-Cache语义可以提升响应质量。
-
层间差异:不同层对缓存丰富的响应差异显著,选择性丰富表现最好的层(如前5层)比丰富所有层效果更好,而丰富表现最差的层则导致性能下降。
2.2 缓存转换Oracle(Cache Transformation Oracle)
-
问题:一个模型的KV-Cache能否被另一个模型有效利用?
-
方法:训练3层MLP将源模型(Qwen3-4B)的KV-Cache映射到目标模型(Qwen3-0.6B)的表示空间。
-
结论:T-SNE可视化显示,转换后的源缓存落入目标模型的表示空间内,证明不同模型的KV-Cache是可转换的。但转换后的缓存仅占目标空间的一个较小子集,说明源模型语义无法完全覆盖目标模型,反映了两者编码方式的固有差异。
2.3 关键洞察
-
KV-Cache是比文本更丰富的表示媒介;
-
不同LLM对同一输入编码不同的语义理解和上下文知识,具有互补优势;
-
KV-Cache支持完全并行的直接投影,避免了文本交换中的顺序解码延迟。
三、C2C方法设计
3.1 整体架构
C2C的核心目标是从Sharer(共享者)模型中提取有用的上下文理解,融合到Receiver(接收者)模型中。其范式包含:
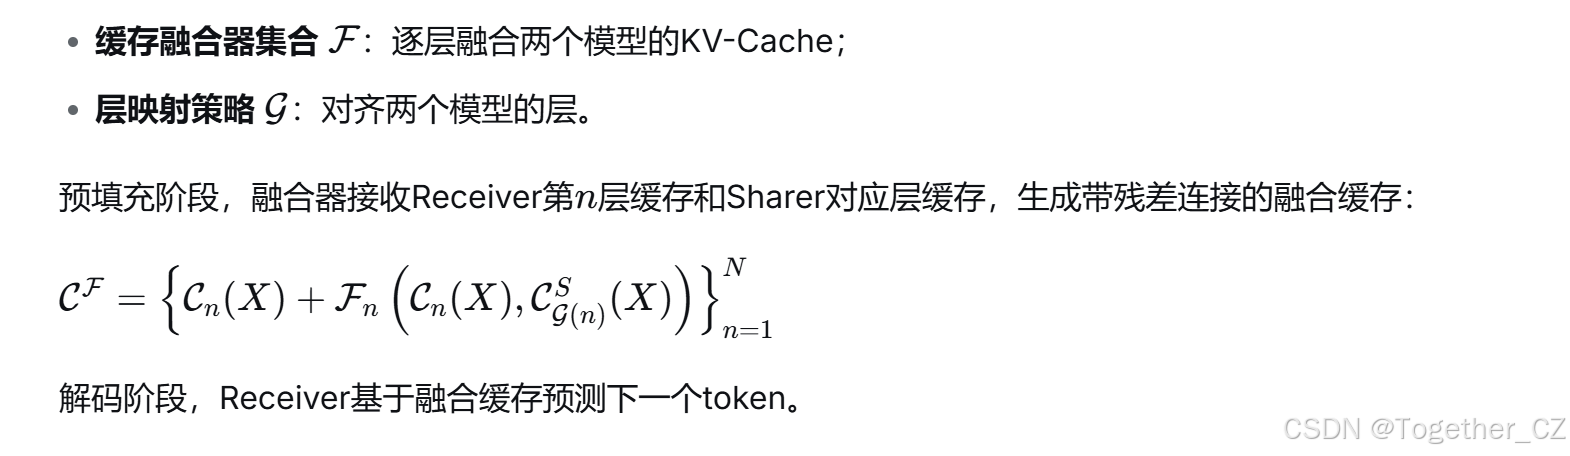
3.2 融合器结构
融合器采用残差集成原则,包含三个关键模块:
-
投影模块:拼接Receiver和Sharer的KV-Cache,通过投影层和特征融合层处理;
-
动态加权模块:应用输入感知的头部调制层,动态重新加权投影信息;
-
可学习门控:引入可训练的逐层门控值,使用带温度退火的Gumbel-sigmoid,训练时可微、推理时二值化,决定是否注入Sharer上下文。
3.3 模型对齐
跨模型家族和大小融合KV-Cache需要两个层面的对齐:
-
Token对齐:将每个Receiver token解码为字符串,用Sharer分词器重新编码;一对多映射时选择最大字符串覆盖的token。
-
层对齐:采用终端对齐策略,从最后一层开始逆序对齐,直到较浅模型的第一个层。
3.4 训练方案
-
冻结Sharer和Receiver,仅训练C2C模块;
-
使用标准下一token预测损失(类似SFT);
-
三阶段:前向编码 → 缓存融合 → 监督预测,梯度通过C2C反向传播。
四、实验验证
4.1 实验设置
-
模型:Qwen2.5、Qwen3、Llama3.2、Gemma3,涵盖不同代际、家族、大小(0.6B-14B)、专业化(通用/代码/数学)和训练阶段。
-
基线:T2T通信、查询级路由、单独模型性能。
-
基准:OpenBookQA、MMLU-Redux、ARC-Challenge、C-Eval。
-
训练数据:OpenHermes2.5前500k样本。
-
评估:平均准确率(性能)、平均推理时间(效率),单张NVIDIA A100,批量大小1。
4.2 主要结果
性能提升
-
C2C比单独模型平均准确率提高6.4-14.2%;
-
比T2T通信范式高出约3.1-5.4%;
-
在三个不同Sharer下,准确率平均分别提高11.00%、9.64%、11.88%;
-
相比T2T,C2C平均准确率提高5.36%、4.15%、3.06%。
效率提升
-
C2C比T2T实现3.46×、1.51×、14.41×的加速;
-
T2T需Sharer解码80个输出token,产生1312ms解码开销,而C2C用90ms并行缓存融合替代;
-
平均延迟加速2.5×。
特殊用例
-
当Sharer为Qwen3-4B Base(经常忽略指令、单独性能差)时,C2C绕过此问题,使较弱的指令微调Receiver能利用更强基础模型的知识。
4.3 缩放行为
-
序列长度:在LongBenchV1上,C2C在所有长度区间(0-4k、4-8k、8k+)持续优于T2T。
-
模型大小:C2C的准确率提升通常比T2T增长更快,表明Sharer知识越丰富,C2C传递越有效。
-
不同模型组合:在5种异构组合上平均比T2T高8.59%;交换Sharer/Receiver后,C2C稳健提升5.05%,而T2T下降6.30%。
4.4 消融研究
-
改进来源:C2C优于Single(仅微调Receiver)和Identical(同模型自通信),证明增益来自异构Sharer的互补上下文理解,而非增加训练容量或过拟合。
-
融合器组件:纯投影(丢弃Receiver缓存)→ +Fuse(残差融合)→ +Gate(逐层门控),准确率逐步提升24.18%和3.07%。
4.5 行为分析
-
有效秩:C2C融合后,K和V的有效秩分别从388→395、532→560,表明语义空间被丰富。
-
准确率分解:容量相当时C2C整合双方理解解决额外问题;容量差异大时C2C更多整合强模型理解。
-
渐进行为:融合比例超过50%后,性能随比例持续提升。
-
门控行为:通用训练倾向于广泛门控激活+细粒度权重调制;任务特定训练倾向于稀疏门控激活+强依赖所选层。
五、讨论与未来方向
5.1 未来工作
-
多智能体系统中的缓存通信:作为复杂多轮推理、编码、工具使用的通信原语;
-
跨模态协作:融合VLM和VLA模型之间的缓存;
-
推理加速:增强投机解码,实现token级路由;
-
隐私感知协作:传输KV-Cache片段而不暴露显式文本。
5.2 局限性
-
当非常弱的Sharer向强Receiver提供噪声信息时,性能可能退化(T2T和C2C共有);
-
以O(N)训练成本扩展通信LLM数量仍是开放问题。
C2C证明了LLM可以超越文本进行通信。通过直接转换和融合KV-Cache,C2C在多种任务和模型配置下持续实现比T2T更高的任务性能和更好的效率。这一范式为可扩展、低延迟的多LLM系统提供了实用替代方案,并开辟了缓存级语义通信的新研究方向。
核心贡献总结:
| 维度 | 贡献 |
|---|---|
| 问题提出 | 首次系统探究LLM能否超越文本通信 |
| 方法创新 | 提出C2C范式,直接投影和融合KV-Cache |
| 关键技术 | 缓存融合器(投影+动态加权+可学习门控)、Token/层对齐策略 |
| 实验验证 | 跨模型家族/大小/专业化全面验证,性能+效率双优 |
| 理论洞察 | Oracle实验证明KV-Cache可丰富、可转换、具互补性 |
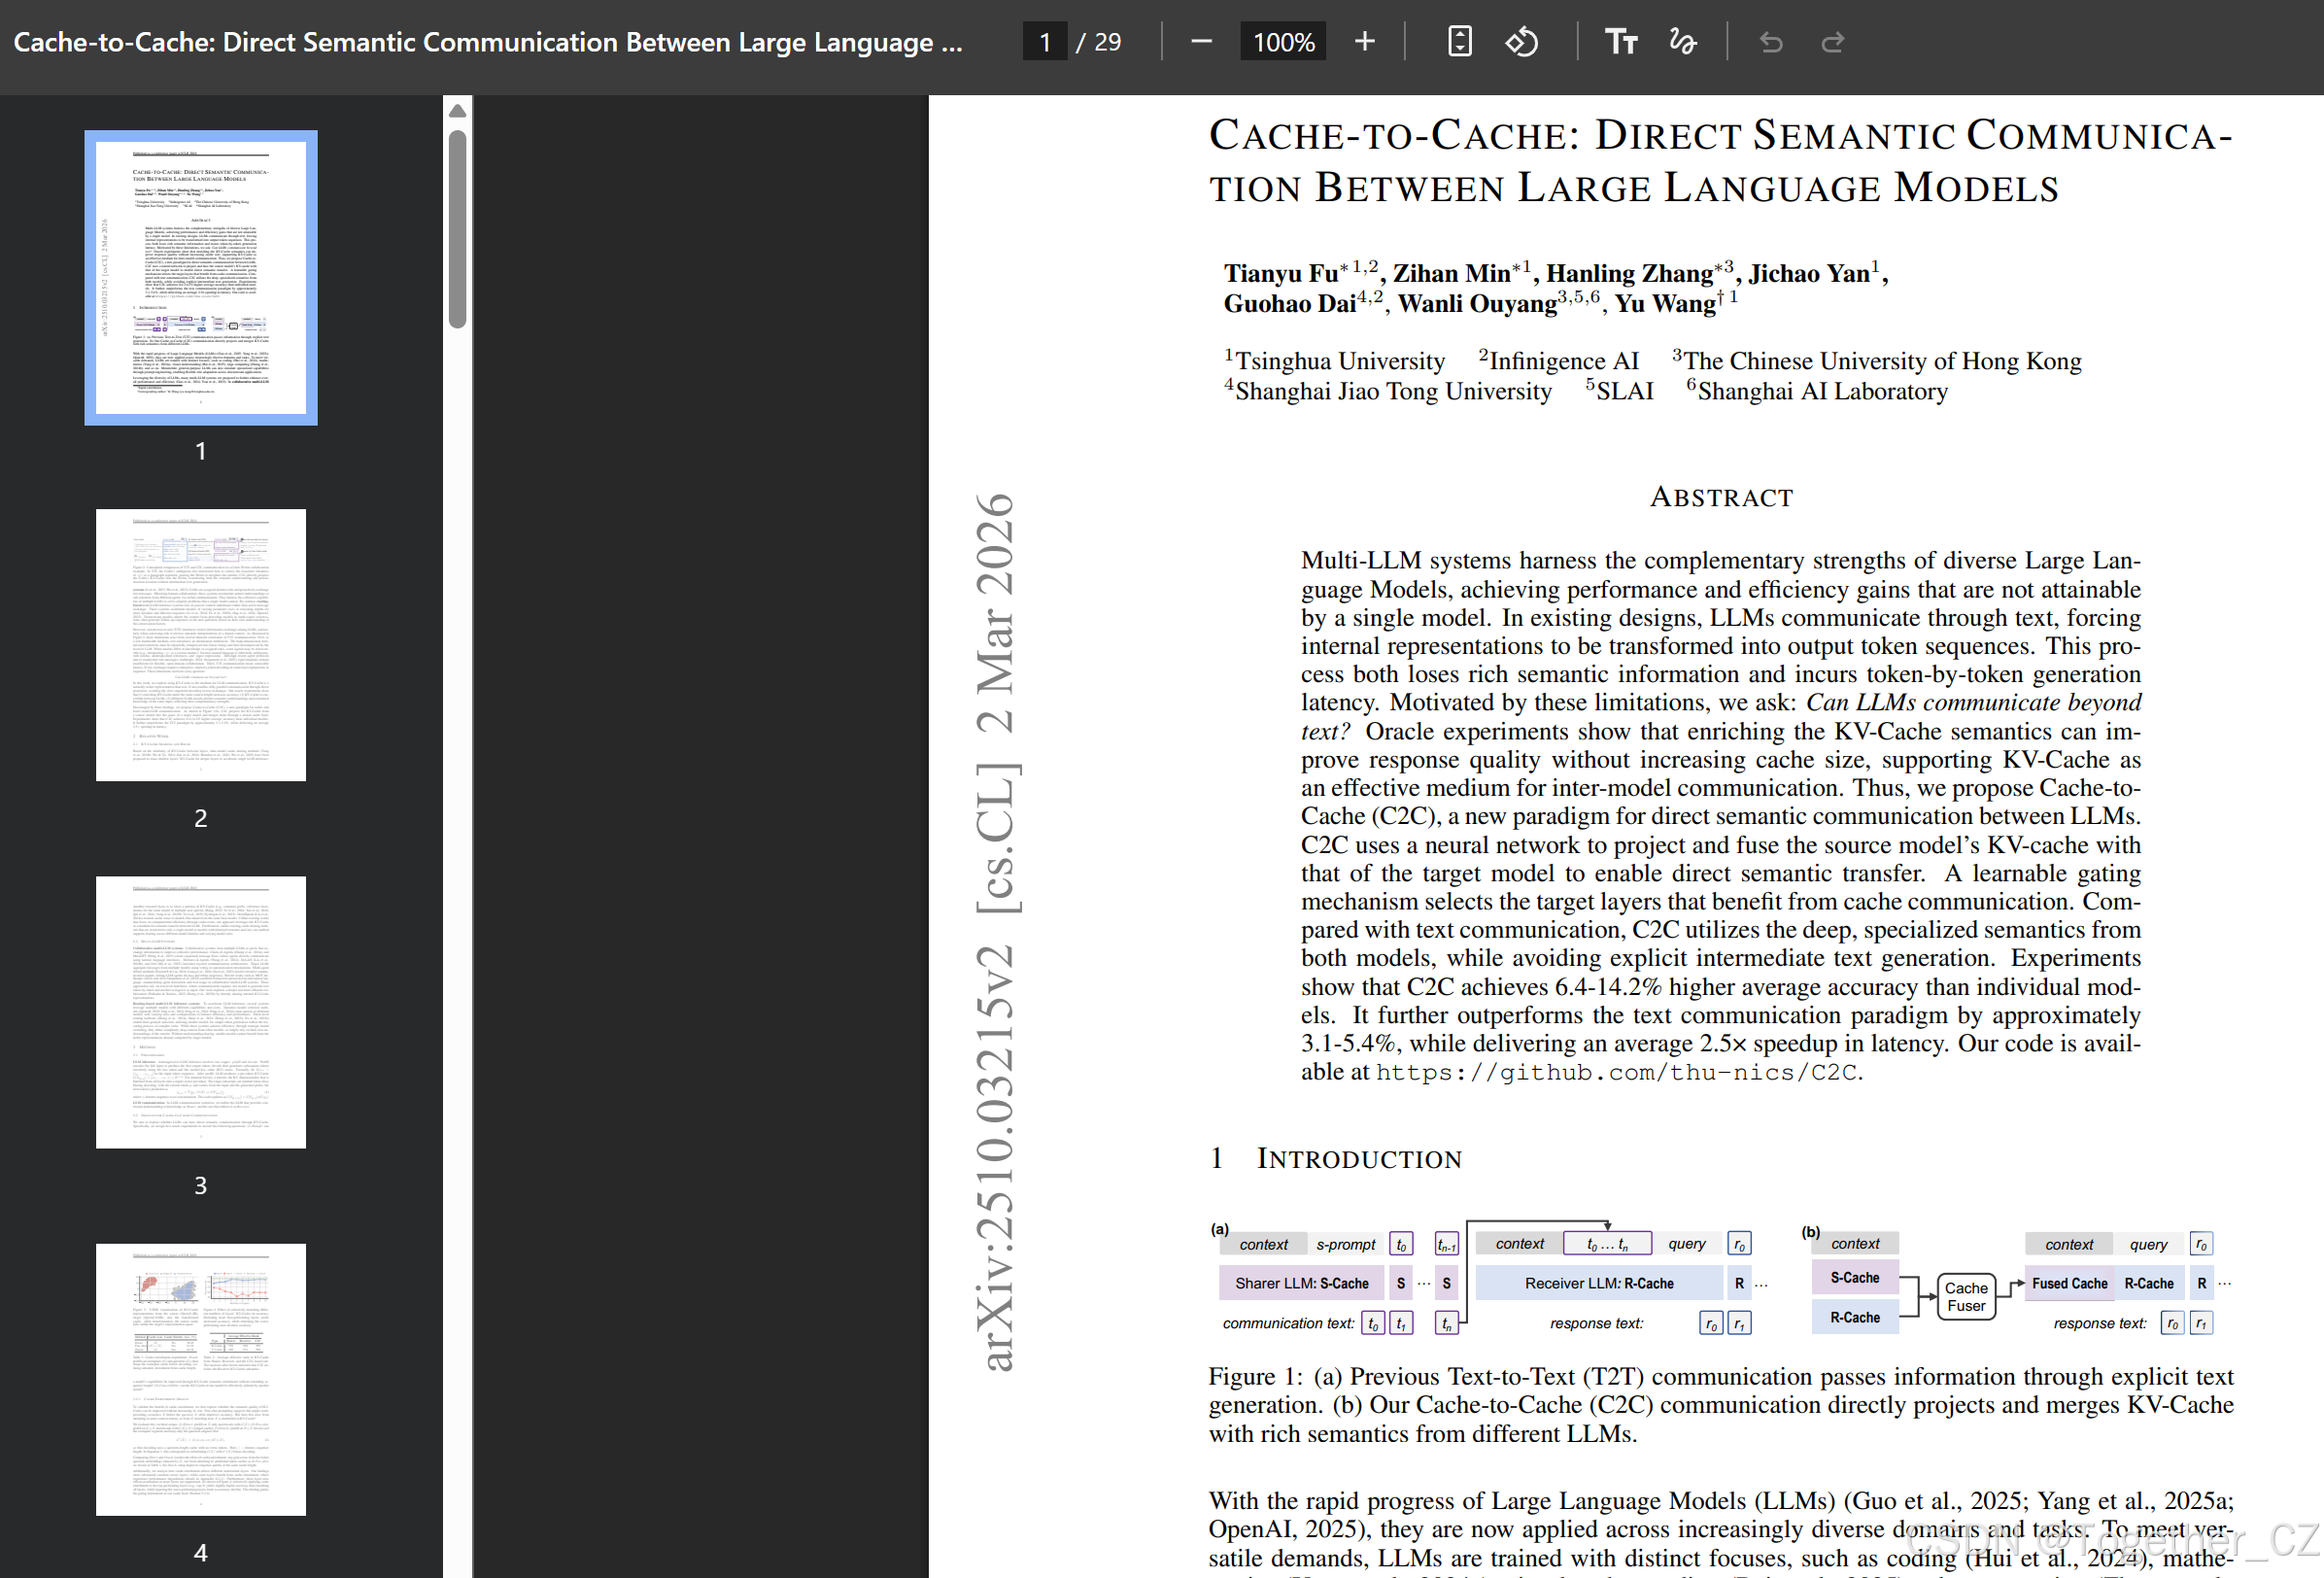
这里是自己的论文阅读记录,感兴趣的话可以参考一下,如果需要阅读原文的话可以看这里,如下所示:
项目地址在这里,如下所示:
摘要
多LLM系统利用多种大语言模型的互补优势,实现了单一模型无法达到的性能和效率提升。在现有设计中,LLM通过文本进行通信,这迫使内部表示被转换为输出token序列。这一过程既丢失了丰富的语义信息,又产生了逐token生成的延迟。受这些局限性的启发,我们提出:LLM能否超越文本进行通信?Oracle实验表明,在不增加缓存大小的前提下,丰富KV-Cache的语义可以提升响应质量,这支持将KV-Cache作为模型间通信的有效媒介。因此,我们提出了Cache-to-Cache(C2C),一种LLM之间直接语义通信的新范式。C2C使用神经网络将源模型的KV-Cache投影并与目标模型的KV-Cache融合,以实现直接的语义迁移。一个可学习的门控机制选择能够从缓存通信中受益的目标层。与文本通信相比,C2C利用了来自两个模型的深层、专业化语义,同时避免了显式的中间文本生成。实验表明,C2C比单个模型的平均准确率高出6.4-14.2%。它进一步比文本通信范式高出约3.1-5.4%,同时实现了平均2.5倍的延迟加速。
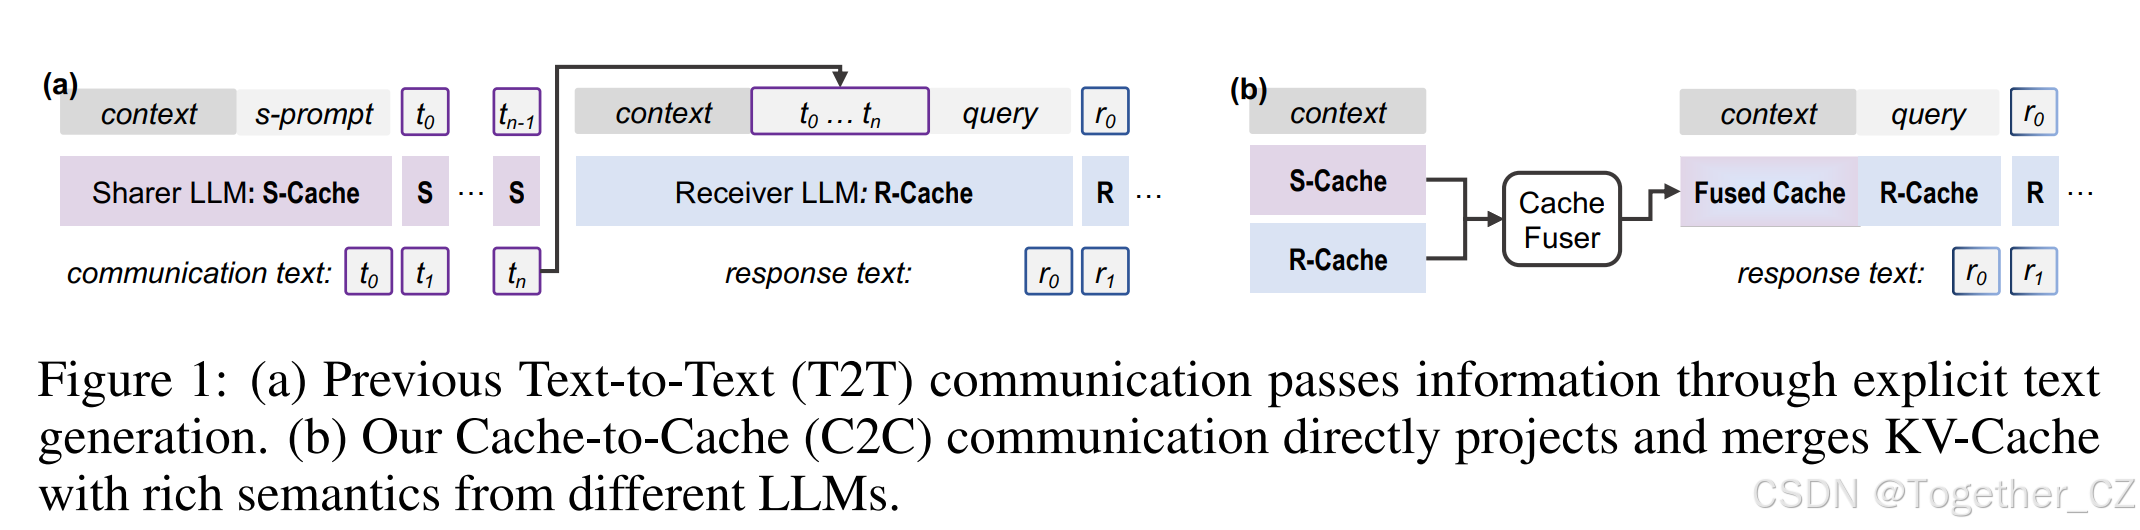
图1:(a)先前的文本到文本(T2T)通信通过显式文本生成传递信息。(b)我们的缓存到缓存(C2C)通信直接投影并合并来自不同LLM的具有丰富语义的KV-Cache。
随着大语言模型(LLM)(Guo et al., 2025; Yang et al., 2025a; OpenAI, 2025)的快速进展,它们现在被应用于日益多样化的领域和任务。为满足多样化需求,LLM被训练以不同的侧重点,如编码(Hui et al., 2024)、数学(Yang et al., 2024a)、视觉理解(Bai et al., 2025)、边缘计算(Zhang et al., 2024b)等。同时,通用LLM也可以通过提示工程模拟专业能力,实现跨下游应用的灵活角色适应。
利用LLM的多样性,许多多LLM系统被提出以进一步增强整体性能和效率(Guo et al., 2024; Tran et al., 2025)。在协作式多LLM系统中,LLM被分配不同的角色并主动交换文本消息。仿照人类协作,这些系统通过语言通信积累来自不同智能体的部分理解或子解决方案。它们利用多个LLM的集体能力来解决单个模型无法解决的复杂问题。相比之下,基于路由的多LLM推理系统依赖于被动的上下文继承而非主动的消息交换。这些系统协调不同参数规模或推理深度的模型,以实现更动态和高效的响应(Li et al., 2024; Fu et al., 2025a; Ong et al., 2024; OpenAI, 2025)。下游模型在多轮对话中继承前序模型的上下文,然后基于自身对对话历史的理解生成对新问题的后续响应。
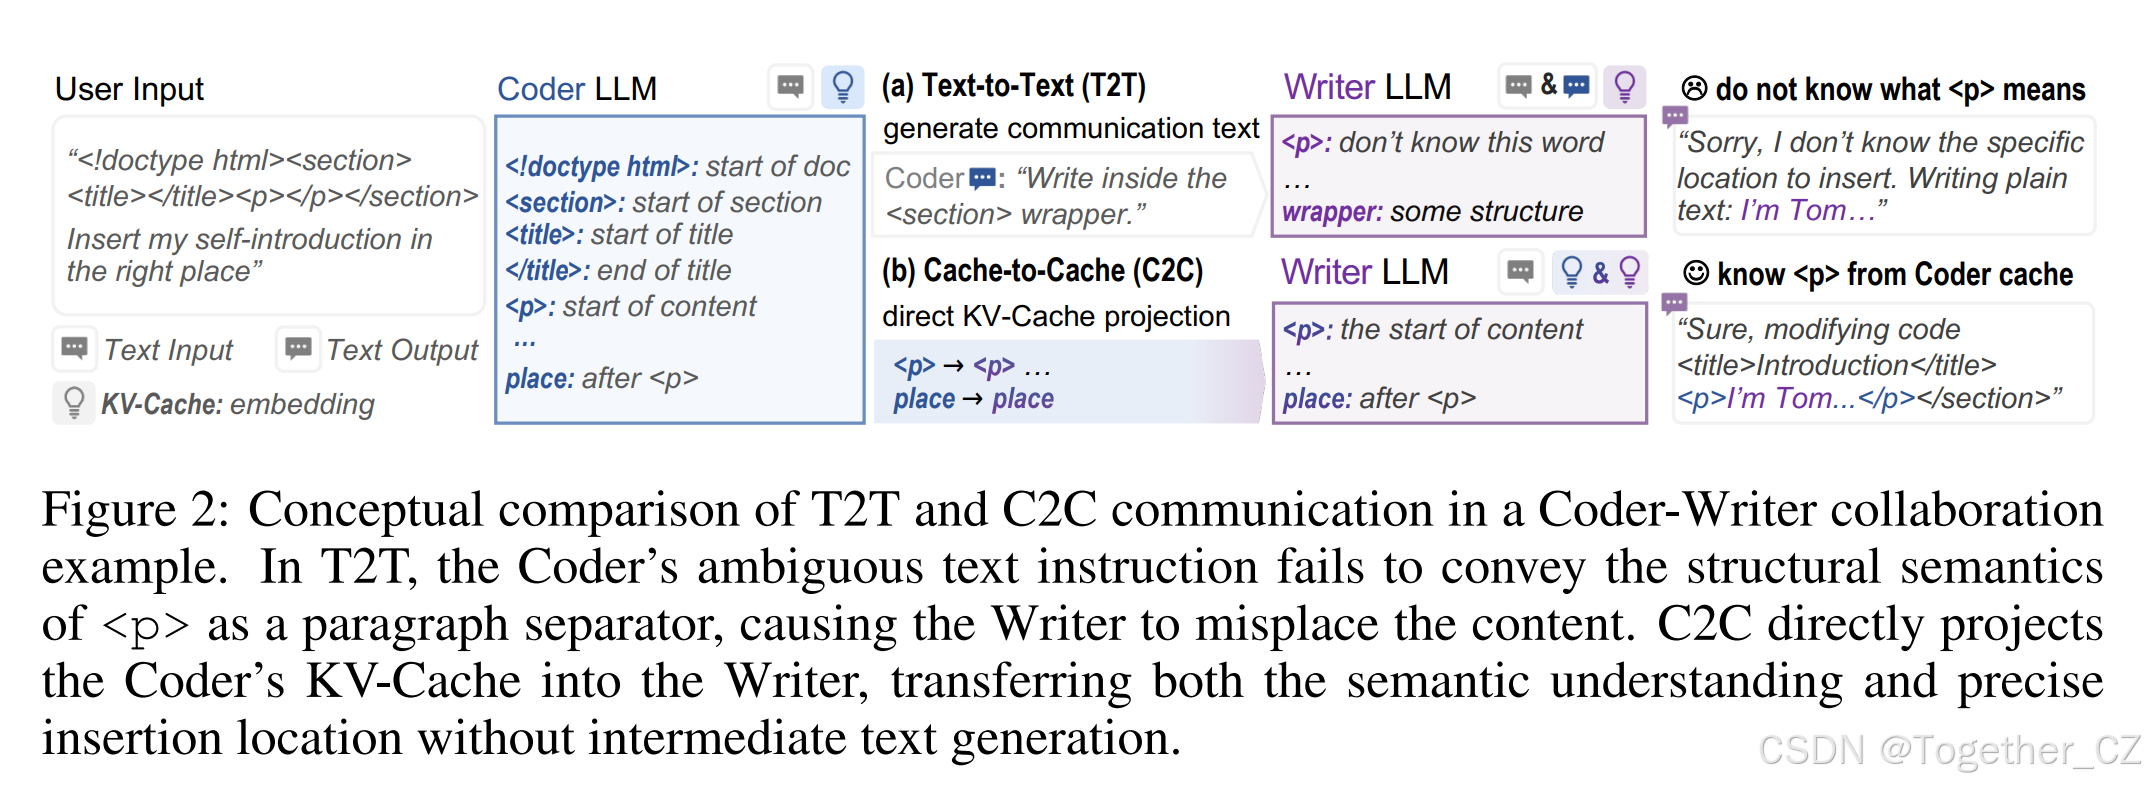
然而,当前的文本到文本(T2T)接口限制了LLM之间的信息交换,特别是在传达对共享上下文的丰富或多样化语义解释时。如图2所示,这些限制源于T2T通信的几个固有约束。首先,作为低带宽媒介,文本引入了信息瓶颈。高维内部表示必须被反复压缩为线性字符串,然后由接收方LLM解压缩。当模型在知识或分配角色上存在差异时,某些信号可能不可恢复(例如,将<p>解释为章节标记)。其次,自然语言本质上是模糊的,包含习语、未充分指定的指代和模糊表达。尽管最近的智能体协议旨在标准化文本消息(Anthropic, 2024; Surapaneni et al., 2025),但僵化的模板仍不足以支持灵活、开放领域的协作。第三,T2T通信产生明显的延迟。每次交换都需要按顺序对上下文解释进行穷举式的逐token解码。这些局限性引出了一个关键问题:
LLM能否超越文本进行通信?
在这项工作中,我们探索使用KV-Cache作为LLM通信的媒介。KV-Cache是一种天然比文本更丰富的表示。它还通过直接投影实现完全并行的通信,避免了文本交换中缓慢的顺序解码。我们的Oracle实验表明:(1)在相同上下文长度下丰富KV-Cache可以提高准确率;(2)KV-Cache可以在LLM之间转换;(3)不同LLM对同一输入编码不同的语义理解和上下文知识,反映了它们的互补优势。
受这些发现的鼓舞,我们提出了Cache-to-Cache(C2C),一种用于更丰富、更快速的多LLM通信的新范式。如图1(b)所示,C2C将源模型的KV-Cache投影到目标模型的空间中,并通过神经缓存融合器将它们合并。实验表明,C2C比单个模型的平均准确率高出6.4-14.2%。它进一步比T2T范式高出约3.1-5.4%,同时实现了平均2.5倍的延迟加速。
2 相关工作
2.1 KV-Cache共享与复用
基于层间KV-Cache的相似性,模型内缓存共享方法(Yang et al., 2024b; Wu & Tu, 2024; Sun et al., 2024; Brandon et al., 2024; Wu et al., 2025)被提出,用于复用浅层的KV-Cache以供深层使用,从而加速单个LLM推理。
2.2 多LLM系统
另一个研究重点是在多个用户查询中复用同一模型的部分KV-Cache(例如,公共前缀、参考文档)(Bang, 2023; Ye et al., 2024; Yao et al., 2024; Qin et al., 2024; Yang et al., 2025b; Ye et al., 2025; Eyuboglu et al., 2025)。DroidSpeak(Liu et al., 2024a)将缓存复用扩展到从同一基础模型微调的模型。与现有专注于通过缓存复用提高计算效率的工作不同,我们的方法利用KV-Cache作为LLM之间语义迁移的媒介。此外,与仅限于单个模型或具有相同结构和大小的模型的现有缓存共享方法不同,我们的方法支持跨不同模型家族和不同模型大小的共享。
协作式多LLM系统。 协作系统将多个LLM视为交换信息以提高集体性能的对等体。Chain-of-Agents(Zhang et al., 2024c)和MetaGPT(Hong et al., 2023)创建了顺序消息流,其中智能体使用自然语言接口直接通信。Mixture-of-Agents(Wang et al., 2024)、DyLAN(Liu et al., 2024b)和Owl(Hu et al., 2025)引入了分层通信架构。目标LLM使用投票或摘要机制聚合来自多个模型的消息。多智能体辩论方法(Estornell & Liu, 2024; Liang et al., 2024; Du et al., 2023)涉及迭代通信轮次,让LLM智能体讨论和精炼响应。最近的工作如MCP Anthropic(2024)和A2A Surapaneni et al.(2025)建立了超越自然语言的正式文本协议,标准化了协作式多LLM系统中的智能体交互和工具使用。这些方法依赖于文本级接口,其中通信需要一个模型逐token生成文本,另一个模型将其作为输入摄取。我们的工作通过直接共享内部KV-Cache表示,探索了更深层、更高效的协作(Pidkuiko & Starkov, 2025; Zheng et al., 2025b)。
基于路由的多LLM推理系统。 为加速LLM推理,若干系统利用具有不同能力和成本的多个模型。动态模型选择方法(OpenAI, 2025; Ong et al., 2024; Feng et al., 2024; Ning et al., 2024)将查询路由到不同大小和配置的模型,以平衡效率和性能。Token级路由方法(Zhang et al., 2024a; Shen et al., 2024; Zheng et al., 2025a; Fu et al., 2025a)实现更细粒度的选择,在复杂任务的推理过程中利用较小模型进行简单token生成。虽然这些系统通过策略性模型切换实现效率,但它们要么完全丢弃来自其他模型的上下文,要么仅仅依赖自身对上下文的理解。在没有理解共享的情况下,较小模型无法受益于较大模型已计算的更丰富表示。
3 方法
3.1 预备知识
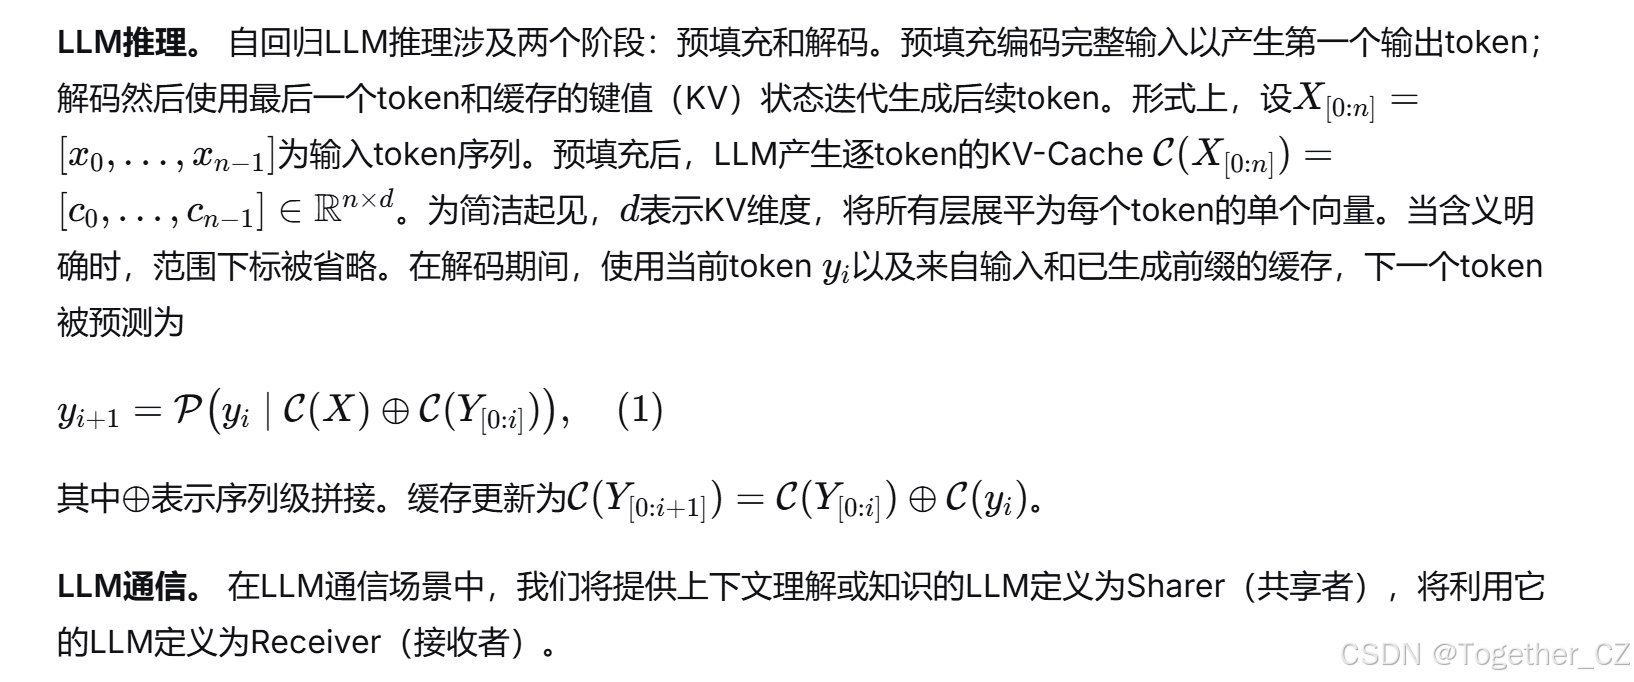
3.2 缓存到缓存通信的Oracle实验
我们旨在探索LLM是否可以通过KV-Cache进行直接的语义通信。具体而言,我们设计两个Oracle实验来回答以下问题:(1)收益:模型的性能能否通过KV-Cache语义丰富得到提升,而不延长序列长度?(2)可转换性:一个模型的KV-Cache能否被另一个模型有效利用?
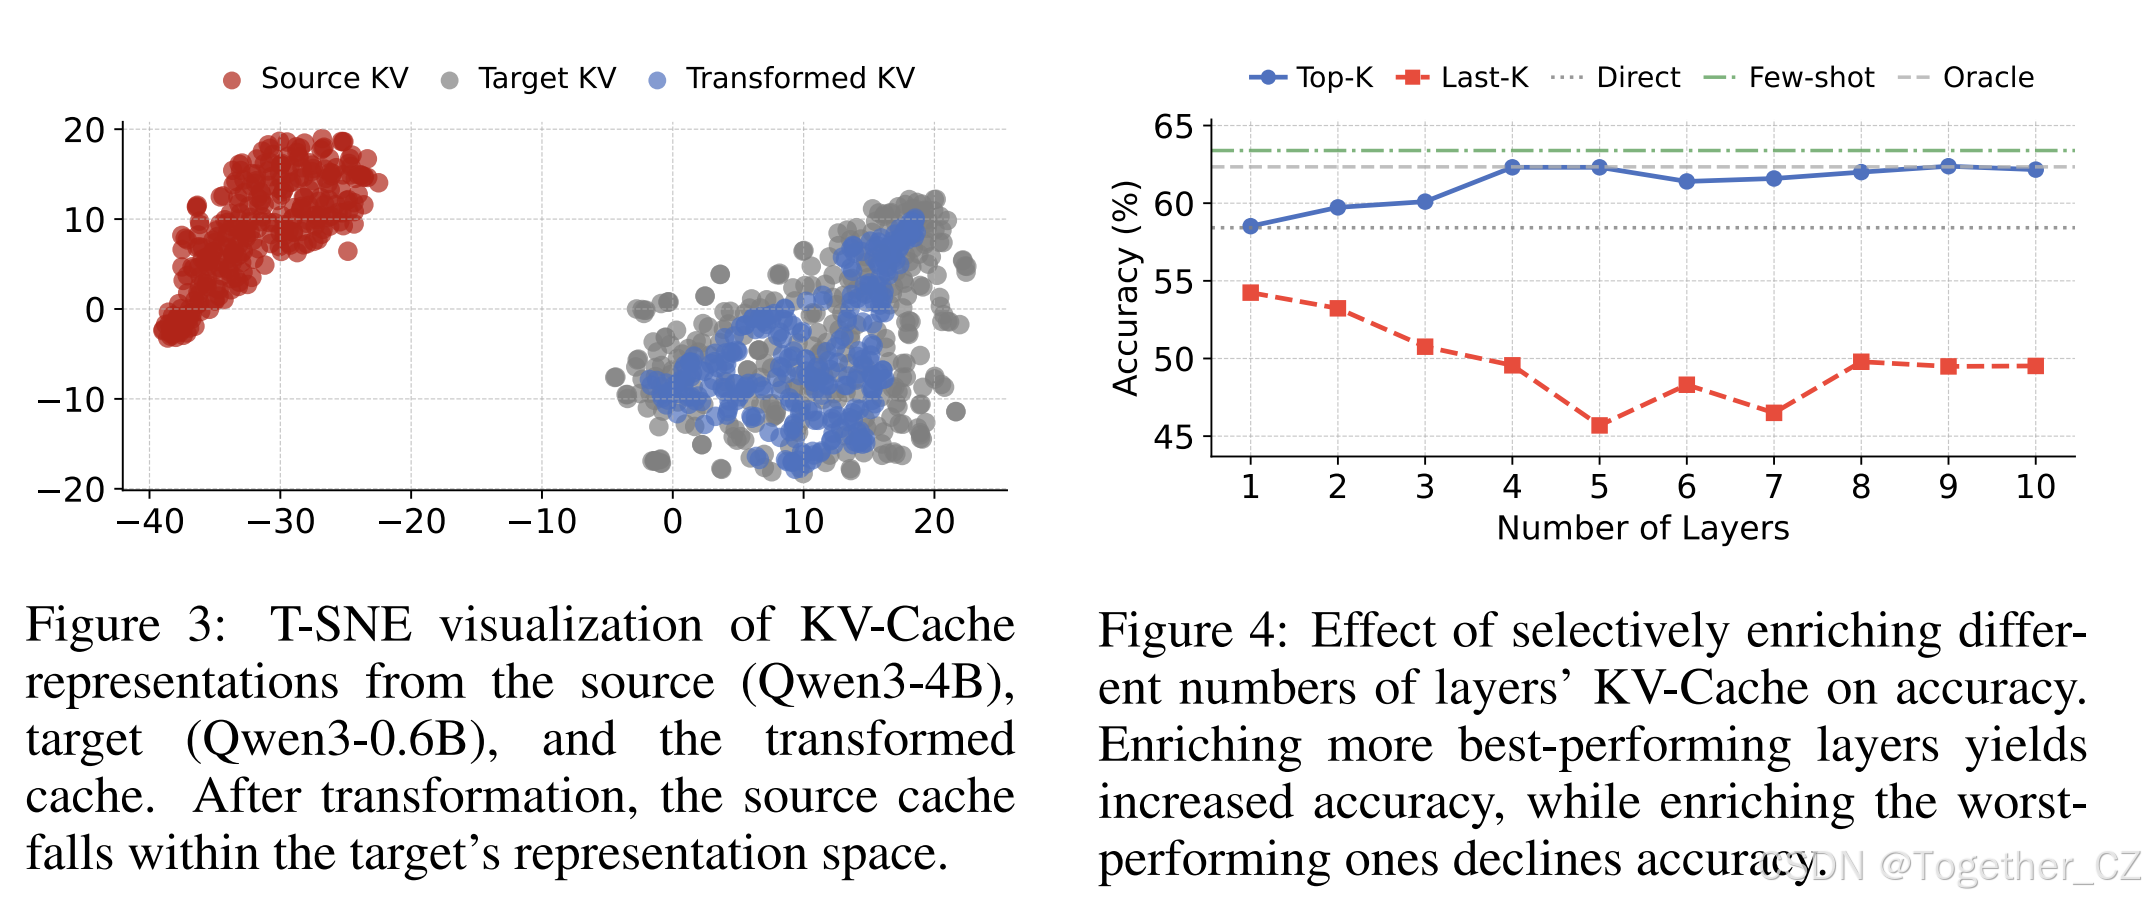
图3: 源模型(Qwen3-4B)、目标模型(Qwen3-0.6B)和转换后缓存的KV-Cache表示的T-SNE可视化。转换后,源缓存落入目标的表示空间内。图4: 选择性丰富不同数量层的KV-Cache对准确率的影响。丰富更多表现最好的层可提高准确率,而丰富表现最差的层则降低准确率。
表1: 缓存丰富实验。Oracle在示例(E)(E)和问题(X)(X)上预填充,然后在解码前丢弃示例缓存,将语义丰富与缓存长度隔离。
| 方法 | 缓存长度 | 缓存丰富 | 准确率(%) |
|---|---|---|---|
| Direct | X | 否 | 58.42 |
| Few-shot | E X | 是 | |
| Oracle | X | 是 | 62.34 |
表2: Sharer、Receiver和C2C融合后的KV-Cache的平均有效秩。融合后的增加表明C2C丰富了Receiver KV-Cache的语义。
| 类型 | 平均有效秩 | ||
|---|---|---|---|
| Sharer | Receiver | C2C | |
| K Cache | 539 | 388 | 395 |
| V Cache | 689 | 532 | 560 |
3.2.1 缓存丰富Oracle
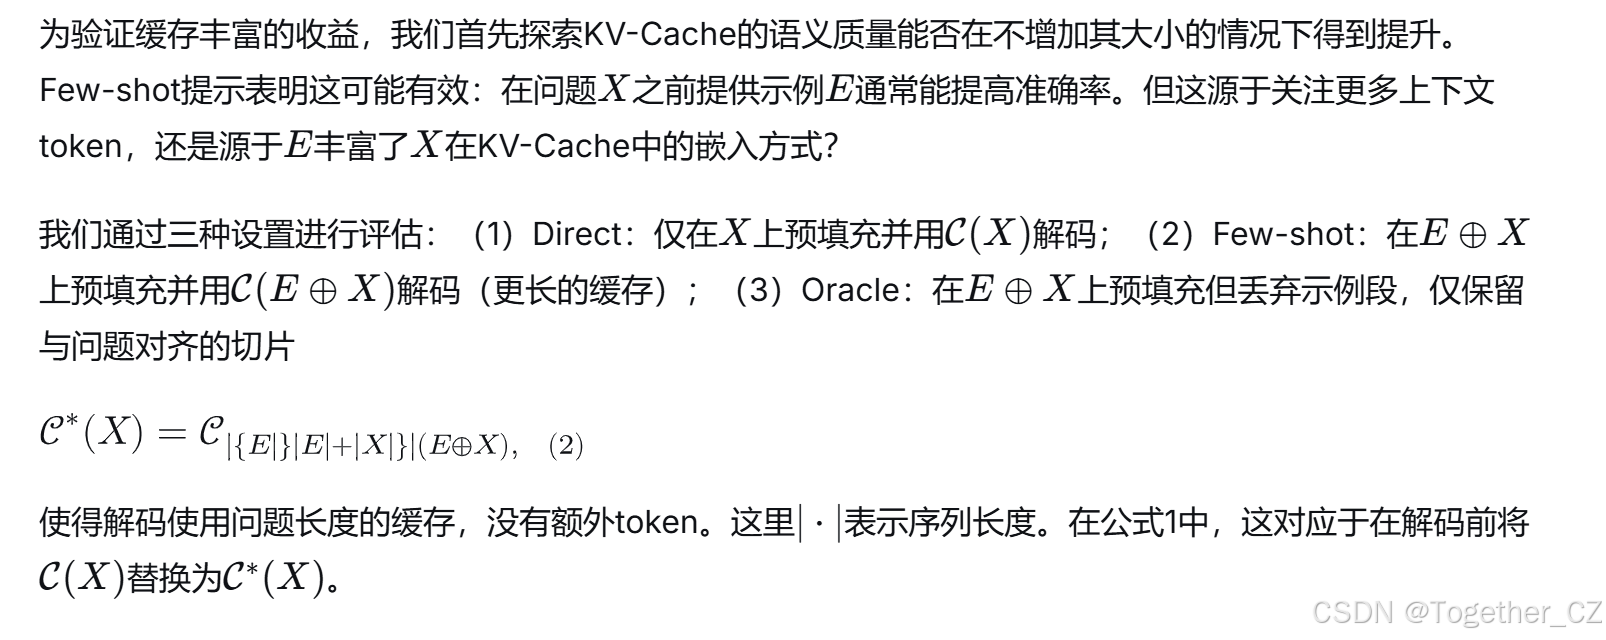
比较Direct和Oracle隔离了缓存丰富的效果:任何增益都来自E诱导的更丰富的问题嵌入,而非关注额外的token缓存(如Few-shot)。如表1所示,Oracle设置在相同缓存长度下提高了响应质量。
此外,我们分析了缓存丰富如何影响不同的Transformer层。我们的发现表明层间存在显著差异:一些层从缓存丰富中受益,而其他层则经历性能退化(详见附录A.2.1)。此外,这些层间效应随着更多层被增强而累积。如图4所示,选择性地将缓存丰富应用于表现最好的层(例如,前5层)比丰富所有层产生略高的准确率,而针对表现最差的层则导致准确率下降。这一发现指导了我们缓存融合器的门控机制(第3.3.2节)。
3.2.2 缓存转换Oracle
为验证一个模型的KV-Cache可以被另一个模型利用,我们进行了跨模型转换实验。我们训练一个3层MLP将源LLM(Qwen3-4B)的KV-Cache映射到目标LLM(Qwen3-0.6B),更多设置详见附录A.3.2。
图3中的T-SNE可视化揭示,两个LLM的原始KV-Cache在表示空间中相距甚远。转换后,映射的KV-Cache位于目标模型的表示空间内。这些结果表明,来自不同模型的KV-Cache通常是可转换的,因为转换后的缓存被目标模型的表示空间所覆盖。
需要注意的一点是,转换后的缓存仅占据目标空间的一个较小子集。这表明源模型的语义信息无法完全覆盖目标的语义信息,尽管源模型更大。这反映了每个模型编码上下文方式的固有差异。另一个观察也支持这一解释:不同模型的正确答案集表现出有限的重叠(图7),尽管各自模型的聚合准确率相当。这些发现表明,如果来自不同模型的专业化上下文理解能够被成功投影和融合,就可能利用各自模型的互补优势。
3.3 C2C设计
3.3.1 概述
基于Oracle实验,我们提出了C2C方案。其核心目标是从一个模型(Sharer)中提取有用的上下文理解或知识,并将其融合到另一个模型(Receiver)中。
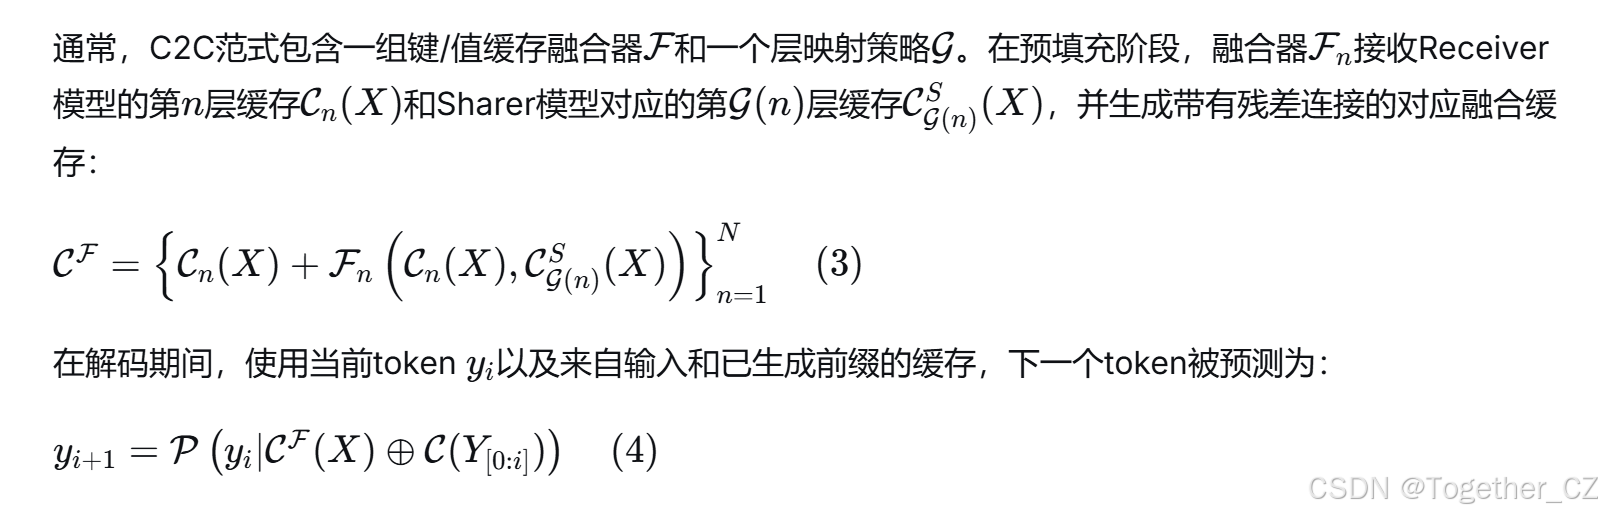
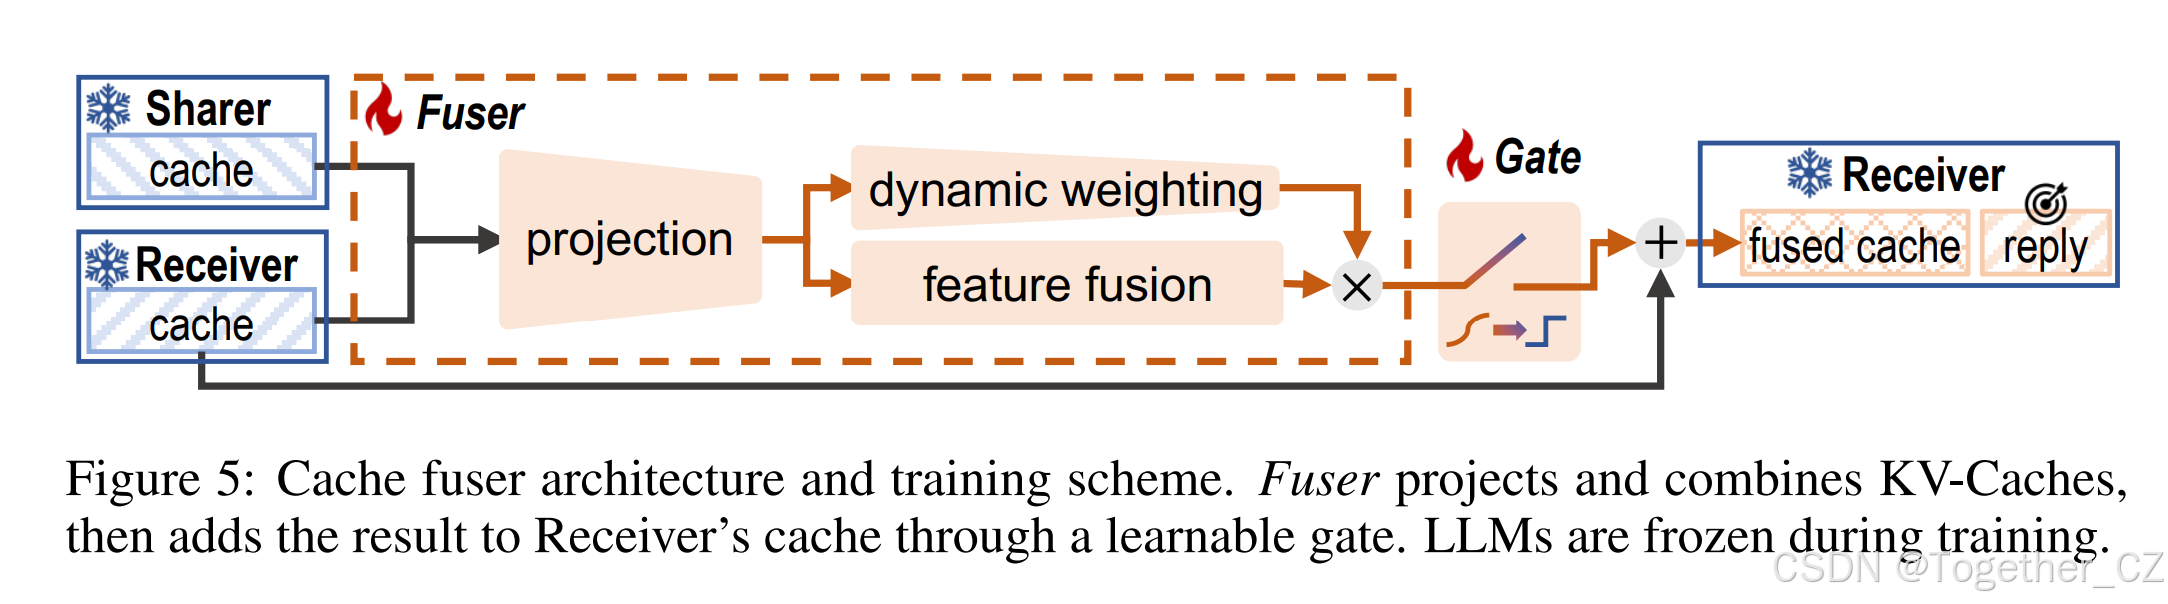
为了在不破坏性地覆盖Receiver信息的情况下增强Receiver的KV-Cache,融合器在残差集成原则下设计。如图5所示,它包含三个关键模块:
(1)投影模块将Receiver的KV-Cache与Sharer的KV-Cache拼接,然后通过投影层和特征融合层处理拼接后的特征。
(2)动态加权模块应用输入感知的头部调制层来动态重新加权投影信息。
(3)可学习门控引入可训练的逐层门控值,决定是否注入Sharer的上下文。门控应用带温度退火的Gumbel-sigmoid,以在训练期间从可微平滑过渡到推理时的二值化。
我们还在附录A.1.3中探索了一种更复杂但可能更强大的融合器变体。
3.3.3 模型对齐
跨模型家族和大小融合KV-Cache需要在两个层面进行对齐:token和层。对于token对齐,不同的分词器可能对同一输入产生略有不同的token序列。我们通过将每个Receiver token解码为其字符串形式,并使用Sharer的分词器重新编码来对齐它们。当偶尔出现一对多映射时,我们选择具有最大字符串覆盖的Sharer token以保留信息。对于层对齐,我们采用终端对齐策略:首先对齐两个模型的最后层,然后对齐倒数第二层,依此类推,按逆序直到较浅模型的第一个层。详情见附录A.1.1和A.1.2。
3.3.4 训练方案
在训练期间,我们冻结Sharer和Receiver模型,仅训练C2C模块进行KV-Cache融合。我们对Receiver的响应预测采用标准的下一token预测损失,类似于监督微调(SFT)。关键区别在于Receiver以融合的KV-Cache为条件预测响应,而非其自身的KV-Cache。
训练过程包括三个阶段:(1)前向:两个模型编码输入上下文以产生各自的KV-Cache。(2)融合:C2C模块融合两个KV-Cache并替换Receiver的缓存。(3)监督:Receiver使用融合缓存预填充响应,梯度通过C2C反向传播以最小化预测损失。
4 实验
4.1 设置
我们在此简要介绍实验设置,更多详情见附录A.3。
模型。 我们在各种模型家族上评估C2C,包括Qwen2.5(Yang et al., 2024a; Hui et al., 2024)、Qwen3(Yang et al., 2025a)、Llama3.2(Dubey et al., 2024)和Gemma3(Team et al., 2025)。为测试泛化性,我们为Sharer-Receiver模型组合选择不同配置,包括不同代际的模型(Qwen3和Qwen2.5)、不同家族(Qwen、Llama和Gemma)、不同大小(0.6B到14B)、不同专业化(通用、代码和数学模型)以及不同训练阶段(预训练和指令微调模型)。对于消融和诊断分析(缩放行为、消融研究、行为分析),除非另有说明,我们将Receiver和Sharer固定为Qwen3模型。这种一致性消除了模型对齐的混杂因素,隔离了C2C的核心影响。
基线。 我们将C2C与两种LLM协作方法进行比较以定位性能:(1)文本到文本(T2T)通信:模型通过针对每个查询的“分析-然后-响应”交接进行协作。Sharer生成关键信息的分析文本以解决输入问题。该文本与原始问题拼接后馈送给Receiver,以镜像标准协作流程。相应提示见附录A.3.6。(2)查询级路由(Ong et al., 2024):模型通过为不同查询选择合适的LLM进行协作。我们还纳入单个模型性能(单独Sharer或Receiver)以建立协作增益的下界。
基准。 我们在四个广泛使用的基准上评估,涵盖推理、知识和语言领域以确保全面覆盖。OpenBookQA(Mihaylov et al., 2018)用于基于事实的推理,MMLU-Redux(Gema et al., 2025)用于通用领域知识,ARC-Challenge(ARC-C)(Clark et al., 2018)用于科学和逻辑推理,C-Eval(Huang et al., 2023)用于中文领域的综合知识。
表3: MMLU-Redux上的平均token数和推理时间分解(Shaper:Qwen2.5-0.5B-Instruct,Receiver:Qwen3-0.6B)。*包括90ms的KV-Cache融合时间。
| 指标 | Receiver-only | Sharer-only | Text-to-Text | Cache-to-Cache | |
|---|---|---|---|---|---|
| Sharer | Receiver | ||||
| 输入Token | 170 | 187 | 103 | 332 | 170 |
| 输出Token | 11 | 19 | 80 | 10 | 12 |
| 预填充时间(ms) | 27 | 20 | 21 | 32 | 20 + 90* |
| 解码时间(ms) | 281 | 326 | 1312 | 231 | 103 |
| 总时间(ms) | 308 | 346 | 1596 | 445 |
训练数据集。 为确保C2C的泛化性,我们使用OpenHermes2.5数据集(Teknium, 2023)的前500k样本(一个通用微调数据集)来训练C2C融合器。为降低训练成本,除非另有说明,我们在缩放行为和行为分析实验中使用MMLU作为训练集。
评估设置。 我们使用平均准确率作为性能指标。对于C2C和基线,我们使用文本生成和答案提取作为评估模式,多选题基准的最大生成长度设为64。所有实验在零样本设置下进行,生成温度为零以确保可复现性。我们使用平均推理时间作为效率指标,在单张NVIDIA A100 GPU上以批量大小为一进行测量。
4.2 主要结果
性能。 如表4所示,C2C在不同设置和基准上持续提升Receiver模型性能。代表性示例输出见附录A.4.4。应用C2C后,三个Sharer的准确率平均分别提高11.00%、9.64%和11.88%。与文本到文本通信相比,C2C的平均准确率分别提高5.36%、4.15%和3.06%。查询级路由优先考虑效率,但将准确率限制为两个原始模型中较好的一个。值得注意的是,Qwen3-4B Base作为Sharer时经常忽略指令,导致单独性能差且T2T通信时间过长。相比之下,C2C绕过了这个问题,突出了一个有趣的用例:较弱的指令微调Receiver可以通过C2C利用更强基础模型的知识,即使基础模型无法遵循指令。我们还探索了强到弱通信(详见附录A.2.2),使用Qwen3-4B作为Sharer,表明C2C有效地使Receiver能够从更强的Sharer中受益。
效率。 如表4所示,C2C通过消除中间文本生成,比T2T实现了3.46倍、1.51倍和14.41倍的显著加速。如表3所详述,T2T需要Sharer解码80个输出token,产生1312ms的解码开销,而C2C用90ms的并行缓存融合替代了这种顺序解码。对Llama3.2-1B异常快速推理的进一步分析见附录A.4.3。
4.3 缩放行为
缩放序列长度。 我们评估C2C如何随序列长度缩放,在LongBenchV1基准的长上下文任务上进行。所有C2C融合器在不同LongBenchV1集合上训练和测试。如表5所示,C2C在所有序列长度区间上持续优于文本到文本通信。这证明了C2C在输入长度范围内的优势。更详细的设置和结果见附录A.2.2和A.3.4。
缩放模型大小。 我们研究C2C如何随Sharer和Receiver模型大小缩放。所有C2C融合器在MMLU的辅助训练集上训练,在MMLU-Redux上评估。如图6所示,x轴表示Sharer大小(Qwen2.5-Instruct系列),yy轴显示C2C相对于仅Receiver基线的准确率增益(Δ Accuracy),每条曲线代表Qwen3系列的一个Receiver。我们发现C2C的准确率提升通常比T2T增长更快。这一趋势表明,当Sharer拥有更丰富的知识时,C2C能够更有效地向Receiver传递有用信息。注意,较大Receiver的相对增益不那么明显,因为它们有更强的基线且与Sharer的知识重叠更高。
不同模型组合。 我们测试不同的Sharer-Receiver组合,包括不同模型家族和不同任务特定模型。表7的结果显示,C2C在MMLU-Redux上所有五种组合中平均比文本到文本通信高出8.59%。这支持了通过采用C2C,Receiver模型可以有效利用来自不同模型的上下文理解来增强性能。值得注意的是,当使用Qwen2.5-Math作为Sharer时,通信文本变得相当长,如附录A.4.3所分析。为进一步测试C2C的泛化性,我们交换Sharer和Receiver模型。结果显示C2C稳健地带来5.05%的准确率提升,而应用T2T导致6.30%的性能下降。
这些实验共同支持了C2C作为一种有效且高效的新LLM通信范式的可扩展性。
表4: 不同通信方法在四个基准上的准确率(%)和推理时间(秒)。Receiver固定为Qwen3-0.6B,搭配三个不同的Sharer。
| Sharer | 任务 | 指标 | Receiver | Sharer | Routing | Text-to-Text | Cache-to-Cache |
|---|---|---|---|---|---|---|---|
| Qwen2.5-0.5B | MMLU-Redux | Acc | 35.53 | 38.42 | 35.58 | 41.03 | 42.92 |
| Time | 0.29 | 0.34 | 0.27 | 1.52 | 0.40 | ||
| OpenBook | Acc | 39.20 | 45.60 | 40.80 | 44.00 | 52.60 | |
| Time | 0.27 | 0.35 | 0.29 | 0.81 | 0.30 | ||
| ARC-C | Acc | 41.04 | 42.09 | 40.70 | 49.48 | 54.52 | |
| Time | 0.29 | 0.39 | 0.29 | 1.00 | 0.36 | ||
| C-Eval | Acc | 32.04 | 40.21 | 34.61 | 35.88 | 41.77 | |
| Time | 0.26 | 0.31 | 0.26 | 1.51 | 0.34 | ||
| Llama3.2-1B | MMLU-Redux | Acc | 35.53 | 32.30 | 33.38 | 43.32 | 44.42 |
| Time | 0.29 | 0.06 | 0.18 | 0.75 | 0.50 | ||
| OpenBook | Acc | 39.20 | 32.60 | 36.40 | 41.20 | 47.80 | |
| Time | 0.26 | 0.07 | 0.17 | 0.70 | 0.43 | ||
| ARC-C | Acc | 41.04 | 33.57 | 37.22 | 50.00 | 53.39 | |
| Time | 0.28 | 0.07 | 0.18 | 0.70 | 0.47 | ||
| C-Eval | Acc | 32.04 | 31.31 | 31.92 | 35.27 | 40.77 | |
| Time | 0.25 | 0.04 | 0.15 | 0.71 | 0.49 | ||
| Qwen3-4B-Base | MMLU-Redux | Acc | 35.53 | 1.03 | 16.39 | 43.87 | 43.95 |
| Time | 0.29 | 2.06 | 0.28 | 7.54 | 0.45 | ||
| OpenBook | Acc | 39.20 | 2.20 | 22.20 | 46.40 | 53.20 | |
| Time | 0.26 | 1.98 | 0.27 | 5.08 | 0.34 | ||
| ARC-C | Acc | 41.04 | 1.48 | 19.65 | 53.91 | 55.39 | |
| Time | 0.28 | 2.06 | 0.28 | 6.56 | 0.40 | ||
| C-Eval | Acc | 32.04 | 5.65 | 15.10 | 38.92 | 42.79 | |
| Time | 0.25 | 2.02 | 0.26 | 3.59 | 0.39 |
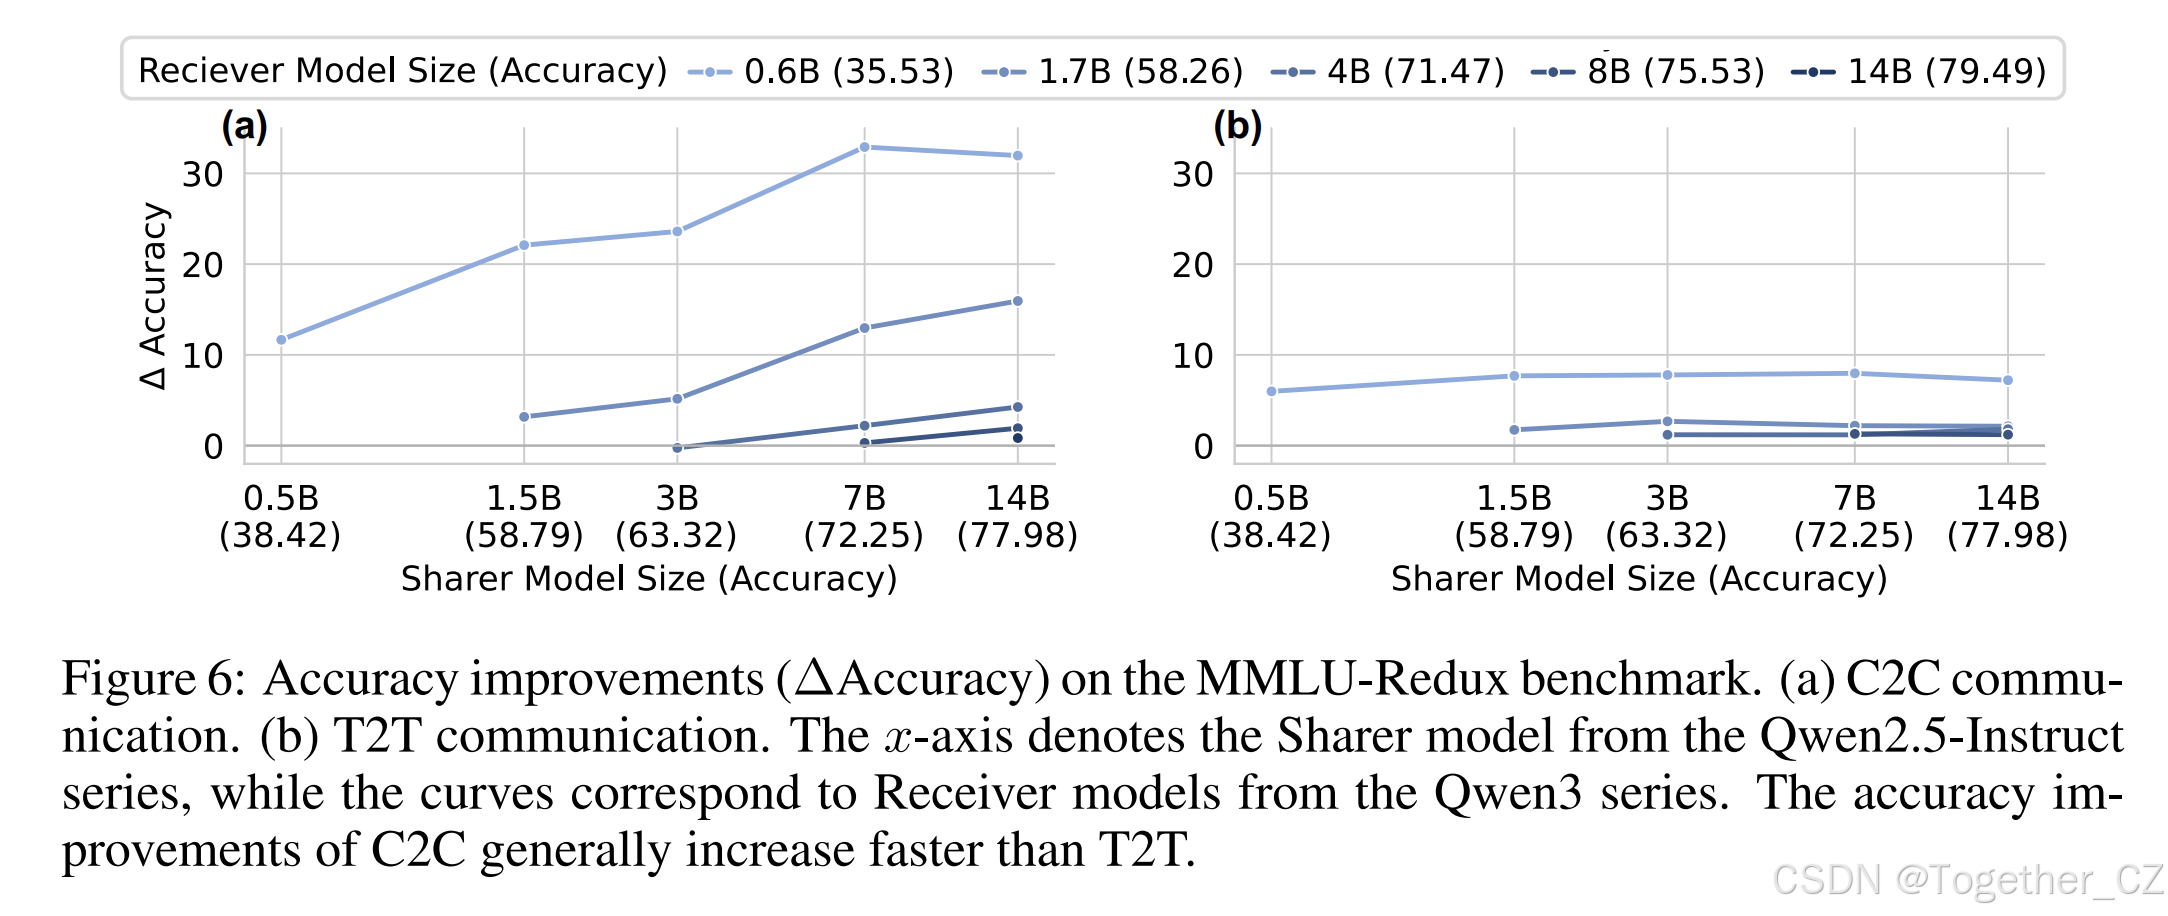
图6: MMLU-Redux基准上的准确率提升(Δ Accuracy)。(a)C2C通信。(b)T2T通信。x轴表示来自Qwen2.5-Instruct系列的Sharer模型,曲线对应来自Qwen3系列的Receiver模型。C2C的准确率提升通常比T2T增长更快。
表5: LongBenchV1上随序列长度的性能缩放,使用Qwen3-0.6B Receiver和Qwen2.5-0.5B Sharer。
| 长度 | Receiver | Sharer | T2T | C2C |
|---|---|---|---|---|
| 0-4k | 30.52 | 24.94 | 33.46 | 37.31 |
| 4-8k | 26.03 | 23.18 | 29.70 | 34.01 |
| 8k+ | 25.99 | 16.44 | 25.64 | 30.72 |
表6: C2C改进来源的消融。Single:仅微调Receiver,无Sharer。Identical:C2C使用同一LLM作为Sharer和Receiver。C2C:使用不同LLM作为Sharer和Receiver。
| 设置 | #参数 | OpenBook | ARC-C | MMLU | C-Eval |
|---|---|---|---|---|---|
| Single | 596M | 45.80 | 47.65 | 36.81 | 35.81 |
| Identical | 529M | 50.60 | 52.52 | 42.17 | 40.34 |
| C2C | 478M | 52.60 | 54.52 | 42.92 | 41.77 |
表7: Receiver-only、Sharer-only、T2T和C2C在准确率和时间上的比较。这些配对分为异构设置(Receiver与不同能力的Sharer配对)和交换设置(Receiver和Sharer角色互换)。
| 配对类型 | Receiver | Sharer | 指标 | Receiver | Sharer | T2T | C2C |
|---|---|---|---|---|---|---|---|
| 异构 | Qwen3-0.6B | Gemma3-1B | Acc | 35.53 | 31.75 | 41.35 | 45.90 |
| Time | 0.29 | 0.54 | 1.04 | 0.30 | |||
| Qwen3-0.6B | Qwen2.5-Math-1.5B | Acc | 35.53 | 39.86 | 43.71 | 46.13 | |
| Time | 0.29 | 8.71 | 6.60 | 0.27 | |||
| 交换 | Qwen3-0.6B | Qwen2.5-Coder-0.5B | Acc | 35.53 | 25.09 | 39.74 | 46.89 |
| Time | 0.29 | 0.26 | 1.59 | 0.27 | |||
| Qwen2.5-0.5B | Qwen3-0.6B | Acc | 38.42 | 35.53 | 32.12 | 43.47 | |
| Time | 0.34 | 0.29 | 0.98 | 0.21 | |||
| Qwen3-0.6B | Qwen2.5-0.5B | Acc | 35.53 | 38.42 | 41.03 | 46.50 | |
| Time | 0.29 | 0.34 | 1.52 | 0.26 |
4.4 消融研究
改进来源。 在表6中,我们通过固定Receiver(Qwen3-0.6B)并变化Sharer来消融C2C性能增益的来源。Single表示对Receiver进行标准全微调,无Sharer。Identical表示C2C中Sharer和Receiver均为Qwen3-0.6B。我们的默认C2C使用Qwen2.5-0.5B作为Sharer。在相同训练配置下,C2C持续获得比Single和Identical更高的准确率。这证实了C2C的改进并非纯粹来自增加的训练容量或对训练集的过拟合。相反,它指向了异构Sharer贡献的互补上下文理解。Identical仍然优于Single,表明缓存级自通信可以提供有用的辅助理解,这与潜在推理和循环Transformer中观察到的效果相呼应(Saunshi et al., 2025; Fu et al., 2025b)。
融合器架构。 在表8中,我们展示了C2C设计中不同组件的效果。与丢弃Receiver缓存的纯投影相比,融合两个模型的KV-Cache并通过残差连接保留Receiver的缓存,准确率提高了24.18%。添加用于融合层选择的门控进一步将平均准确率提高了3.07%。
4.5 行为分析
有效秩分析。 我们分析缓存到缓存通信前后KV-Cache的有效秩。有效秩(Roy & Vetterli, 2007)是模型权重或激活值内在维度的常用度量;更高的内在维度意味着更丰富的语义信息,详见附录A.4.1。如表2所示,缓存到缓存融合后,K和V的有效秩分别从388增加到395,从532增加到560。这表明C2C通过成功转换Sharer的表示并将知识注入Receiver模型,丰富了语义空间。
准确率分解。 我们的分析揭示,C2C准确率增益的来源取决于通信模型的相对容量,并因任务子类别而异。详情见附录A.2.3。我们还发现,在某些特定情况下,C2C可能失败,因为来自Sharer模型的上下文理解并不总是准确的,可能误导Receiver生成错误答案。代表性示例见附录A.4.6。
渐进行为。 我们通过逐渐增加C2C更新的上下文KV-Cache百分比来分析C2C的渐进行为(详情见附录A.2.4)。当百分比超过50%时,增加百分比持续产生更好的性能。
门控行为。 我们在附录A.4.2中分析不同训练模式下C2C可学习门控的行为。我们可以得出结论:通用训练倾向于广泛的门控激活,通过权重进行细粒度调制,而任务特定训练倾向于稀疏的门控激活,更强地依赖所选层。
表8: C2C融合器组件的消融。Project:直接用投影的Sharer缓存替换Receiver的KV-Cache。+Fuse:融合两个缓存并通过残差将结果加回Receiver。+Gate:添加逐层可学习门控。
5 讨论
未来工作。 C2C开辟了若干未来研究方向。(1)多智能体系统中的缓存通信:C2C可能成为具有复杂多轮推理、编码和工具使用的真实世界智能体任务的更好通信原语。附录A.5.3提供了数学问题解决的初步案例研究。(2)跨模态协作:超越纯文本模型,融合视觉语言模型(VLM)和视觉语言动作(VLA)模型之间的缓存可能实现更丰富的多模态协作。(3)推理加速:C2C可以增强投机解码,并实现跨异构模型的token级路由,以降低延迟和成本。(4)隐私感知协作:LLM可以传输KV-Cache片段而无需显式文本,限制内容暴露并提高隐私性。
局限性。 (1)当非常弱的Sharer向更强的Receiver提供噪声信息时,多LLM系统会经历性能退化。这一局限为T2T和C2C所共有,因为Sharer的语义质量直接影响Receiver性能。(2)虽然成对KV-Cache通信可行且有利,但以O(N)训练成本扩展通信LLM数量仍是一个开放问题。针对此目标的初步努力见附录A.5.1和A.5.2。
6 结论
我们证明了LLM可以超越文本进行通信。我们引入了Cache-to-Cache(C2C),一种跨模型转换和融合键值(KV)缓存以实现直接语义通信的通用范式。在不同任务和模型配置中,C2C持续实现比文本到文本通信更高的任务性能和更好的效率。这些结果确立了缓存到缓存作为基于token通信的实用替代方案,并突出了其在可扩展、低延迟多LLM系统中的前景。


 扫一扫


 614

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


